这是本节的多页打印视图。 .
文章
- 1: 四视角 review
- 2: AI 编程的三阶水平
- 3: 使用文件系统映射进程内存
- 4: AI 全速开发中
- 5: 关于 sharedata 的使用
- 6: ai 主旋律
- 7: 又溢出了
- 8: 当lua_sharedata碰上上限
- 9: debian12安装nvidia驱动
- 10: 项目上线啦
- 11: 首次付费测
- 12: 压测周
- 13: 视频分析
- 14: 43 周回顾
- 15: SSH 产生公钥
- 16: 折腾 HTTPS 的一点笔记
- 17: 流量压缩
- 18: 沉迷 docker
- 19: 代码扫描
- 20: sproto 添加版本号
- 21: Skynet 广播优化小记
- 22: proxychains4.16 的新行为
- 23: 使用 jemalloc 的潜在问题
- 24: golang编译问题
- 25: CPU 画正弦曲线
- 26: 发布 pysproto
- 27: 折腾Makefile
- 28: Skynet require 的更新
- 29: Lua54 兼容性
- 30: 一些吐槽
- 31: 技能系统
- 32: Pixel 刷入 Android10
- 33: opencv 学习
- 34: 新年快乐 2021
- 35: goroutine 数据竞态
- 36: [译]Redis 探险之旅的结束
- 37: skynet.call 调用
- 38: skynet 火焰图的新方法
- 39: shadowsocks 重定向攻击
- 40: 二叉平衡树之 AVL 树
- 41: 博客中英文间添加空格
- 42: skynet 中隐藏的单点服务 : Harbor
- 43: git 与 redmine 联动
- 44: jemalloc 内存占用问题
- 45: 罕见的 coredump 了
- 46: iPhone 惊爆史诗级漏洞?漏洞细节解析
- 47: 线程数与游戏卡顿
- 48: 技能问题引发内存泄漏
- 49: PullRequest 找原作者做 review
- 50: Nginx 超时设定
- 51: Rust 对协程的思考
- 52: Python 的定时执行
- 53: Mesh 内存分配器的 mmap 小技巧
- 54: 尝鲜 svnup
- 55: HTTPPostmultipartform-data 支持
- 56: MongoDB 慢查询性能分析
- 57: redis 的 LRU 算法(二)
- 58: Skynet 服务热点火焰图分析
- 59: 内存爆灯
- 60: 时区问题
- 61: 与机器共生
- 62: bug 狩猎
- 63: LessonLearned
- 64: 下划线引起的血案
- 65: Intel 的 CPU 漏洞:Spectre
- 66: git 和 redmine 同步
- 67: syslog 日志打印
- 68: redis 的 LRU 算法(一)
- 69: skynet 的网络收发
- 70: skynet 的火焰图
- 71: 伤感三月
- 72: 加班月
- 73: theevolutionofLua 全文翻译
- 74: 2016 年终总结
- 75: 《The Evolution of Lua》翻译 part2
- 76: 《The Evolution of Lua》读书笔记 1
- 77: 《一个 Go 程序系统线程暴涨的问题》结论
- 78: 空中换心
- 79: 阅读分享:游戏服务器的设计与面向日志的工作流
- 80: 六月小结
- 81: 忙忙忙
- 82: 回炉重铸 - 设计模式的领悟
- 83: pythonsproto 支持 64 位有符号整数
- 84: pysprotobug 修复
- 85: 最近设计的反思
- 86: 服务器被发现存在未授权访问
- 87: RRDtool 简介
- 88: 折腾域名的 dns
- 89: 2015 年终总结
- 90: mmzb 游戏事故分析
- 91: 为 sproto 手写了一个 pythonparser
- 92: Lua 小技巧
- 93: Techparty- 广州 10 月 31 日 Docker 专场沙龙后记
- 94: 1password 密码库格式更新
- 95: SSL 加密与系统时间
- 96: python 和 nodejs 的 aes128 加密对比
- 97: 9 月补记
- 98: 对 bt 的一些想法
- 99: 旧梦重温
- 100: 树莓派改用中山大学软件源
- 101: 翻译 lpeg 入门教程
- 102: 为 python-sproto 添加 map 支持
- 103: 玩家回档原因分析
- 104: 为 sproto 添加 python 绑定
- 105: 如何快速编写 Vim 语法高亮文件
- 106: windows 调试器尝鲜
- 107: 休斯顿,我们遇到了一个问题
- 108: 糟糕的十一月
- 109: skynet 的协程
- 110: redis-persist 上线
- 111: 忙里偷闲的八月
- 112: 并行的边界
- 113: 初来乍到
- 114: 进程 daemon 化
- 115: 嵌入式课程设计 -- 第一天
- 116: 引用计数 gc 机制使用不当导致内存泄漏
- 117: 脚本引擎栈指针误操作引起内存泄露
- 118: 译 libev 和 libevent 的设计差异
- 119: libevent 库 1.4 升级到 2.0 时无法 flush 的解决办法
- 120: 游戏协议加密及身份验证
- 121: 初探 groupcache
- 122: systemtap 折腾笔记
- 123: Mongodb 在 NUMA 机器上的优化
- 124: 转设置 Android 手机以使用 ARMStreamline 进行性能分析(二)
- 125: 转设置 Android 手机以使用 ARMStreamline 进行性能分析(一)
- 126: FreeBSD 打开 DTrace 支持
- 127: 压测周
- 128: 类型系统线程安全
- 129: dbd 到 mongo 的序列化问题及稳定性
- 130: 进程演算中的事件概念
- 131: 青春请你归来,再伴我一会
- 132: 再堕噩梦,斩龙之旅
- 133: 抄作业的一周
- 134: supervisor 很赞!
- 135: 添加 mongodb 支持
- 136: TheimplementationofLua5.0 阅读笔记(二)
- 137: TheImplementationofLua5.0 阅读笔记(一)
- 138: 移动安卓端网络库开发
- 139: 从 lua 调用 C 函数
- 140: 新的开始
- 141: 外服部署时遇到的问题
- 142: 迅捷 FASTFWR171-3G 实战 OpenWRT
- 143: 游戏服务器设计的思考
- 144: 多语言协作与二进制交互
- 145: 从一段代码里看 FreeBSD 与 Linux 内存分配的不同
- 146: 存储器性能测试
- 147: 欢送 2012
- 148: tig 支持中文搜索
- 149: 为什么 go 语言适合开发网游服务器端
- 150: LPC 及 MudOS 简介 ( 一 )
- 151: 大面积断线原因分析
- 152: 断线与资源释放
- 153: RPC 的思考
- 154: 【翻译】HowwemakeGitHubfast( 我们如何让 github 更快 )
- 155: tricks: 如何把 sqlalchemy 的数据转化为 json 格式
- 156: 项目总结
- 157: 智能去除选定区域
- 158: 分享三个好用的装饰器
- 159: 根据 pythonprotobuf 自动生成 protobuf 包收发接口
- 160: 台电 k6 你立功了
- 161: python 实现的简单的 epub2txt
- 162: vim 定制配色方案
- 163: ubuntu 下访问 E72
- 164: python 实现的最近最少使用算法
- 165: GreaseMonkey 渐进
- 166: 新浪微博显示原创图片
- 167: 如何组织文件
- 168: 在 cygwin 上安装 gevent
- 169: 使用 python 对 txt 格式的小说进行处理
- 170: RLE 游程长度编码
- 171: SICP 与函数式编程
- 172: 视频数据编解码技术
- 173: C 程序设计语言答案 chapter3
- 174: C 程序设计语言答案 chapter2
- 175: C 程序设计语言答案 chapter1
- 176: ubuntu 下 svn 上传到 googlecode
- 177: 操作系统逻辑地址与物理地址的转换
- 178: 入手台电 K6
- 179: archlinux 安装 quick-init 导致根目录可读的修复
- 180: virtualbox 安装 gentoo
- 181: Ubuntu 下利用 expect 脚本自动登录 ssh 作代理
- 182: 着迷 twittering
- 183: python-twitter 与第三方 api 协作
- 184: Oauth 与 twip 杂感
- 185: sshtunnel 翻过伟大的长城
- 186: python 中文编码笔记
- 187: 分布式有感
- 188: CrossSiteRequestForgeries 跨站伪请求
- 189: chrome 关于 404 的错误处理
- 190: web.py+gae= 我的第一个留言板【二】
- 191: web.py+gae= 我的第一个留言板【一】
- 192: Datagramsocketwithconnection-orientedinJava
- 193: thetruthaboutsessions 择译
- 194: web.py0.3 版本 tutorial 示例
- 195: apache-tomcat-6.0.26 的 cgi 配置过程
- 196: MatlabCell 功能
- 197: 浅论函数式语言的环境,兼谈闭包
- 198: 最近要跟函数式语言干一仗!
- 199: RBF、K-NN 与 Decisiontree
- 200: java 路径设置
- 201: 同步与异步
- 202: 最长公共子序列 --- 从动态规划说起
- 203: JavaScript 中的闭包
- 204: StandardML 语言(一)
- 205: 初探 Git
- 206: Linux 超级块
- 207: 嵌入式系统概念笔记
- 208: linux 进程信息
- 209: watchdog
- 210: copyonwrite
- 211: 反转分页表(Invertedpagetables)
- 212: 银行家算法(Thebanker'salgorithm)
1 - 四视角 review
好久没试过自己纯手写点什么了。。试试重新写 blog 看看
最近模仿 qoder 的 code review ultra 技能,自己写了个分四视角做 code review 的,效果确实比之前单视角的强。大致是按正确性、完整性、影响范围、安全性四个维度做评估。正确性主要关注逻辑错误、错误处理的边界情况、明显的错误边界。完整性是按 commit message 里描述的功能特性来评估的。影响范围是看引入的新代码,有没有将现有的东西改坏了,比如引入并发问题等。安全是针对玩家输入,看看有没有缺乏校验,导致玩家可以薅羊毛的,或者拖垮整个服务器的。
后面又针对缓存性的问题,将完整的 diff 先发一份上去,建立公共前缀,再附上各自视角的 prompt,提高缓存命中率。后面大家都用上 ai 来写代码,diff 越来越大,就加了个分组的功能,有相互引用的文件划分成一组,尽量保证留更多上下文空间给模型做思考。这里补充一点细节,6.1-sol需要增加prompt_cache_key,6-sol只要前缀一样就行,然后缓存需要等到TTFT(第一个回复token回来)才生效的
为了限制模型的过度思考,加了超时和轮次上限,但是比较大的 diff 容易摸到上限,后面针对 diff 里的函数,再做了一次全量搜索,这样 4 个视角都可以共享搜索结果,不用分别独立发现函数调用和对应函数定义了,速度更快,token 更省。
先写到这里吧
2 - AI 编程的三阶水平
最近一直在想一个问题:用了 AI 写代码这么久,到底到了什么水平?
想了想,大概可以分成三个阶段。
一阶:写代码
这就是 vibe coding。描述需求,AI 写代码,自己 review。效率飞升,睡眠不足时遗漏边界条件的 bug 也少了很多——上次聊过,不重复了。
一阶的核心是"快"。以前一个功能写三天,现在一天能写完三个。AI 像 C 语言取代汇编一样,不再需要纠结每一行怎么写,除非遇到性能瓶颈。这个阶段我已经比较熟练了,Claude Code 搭配 GLM-5 日常开发,基本形成了肌肉记忆
但快了之后,反而暴露出新的问题。AI 写得飞快,看都看不过来,只能让它先写测试再写代码。有时候它会跑偏,需求理解错了,写出一堆要返工的东西。于是很自然地,就需要进入第二阶段
二阶:工程化质控
一阶是让 AI 写代码,二阶是让 AI 在工程规范的约束下写代码
具体来说就是 TDD、SDD 这些老朋友。先写 spec 把需求确认清楚,再写测试把预期行为钉死,最后才让 AI 写实现代码。这样 AI 一次就能成型,不用来回返工。不是什么新方法论,只是以前嫌麻烦懒得做,现在 AI 速度快到你不做反而更亏——返工的时间比写 spec 的时间还长
还有一个是代码审查。AI 写的代码表面上看起来很漂亮,但细节里经常藏着坑。比如 skynet 里 pairs 遍历 table 时不能往里面塞元素,这种 Lua 的隐式约束,AI 不一定会注意到。所以 review 这步不能省,反而因为产出速度上去了,review 的压力更大了
二阶的另一个方面是线上问题排查。之前写了篇用文件系统映射进程内存的文章,思路就是让 AI 能直接读游戏服务端的数据来做分析。AI 逐次调用接口太慢,不如提前把数据备好让它操作文件。这本质上也是工程化——给 AI 搭好基础设施,让它在一个可控的环境里干活
目前我大概就卡在二阶这个水平。工程化做得还行,但总觉得天花板很低。AI 能帮我写代码、跑测试、查 bug,但它不会告诉我:这个功能该不该做?这个版本的方向对不对?玩家到底在不在乎这个东西?
这些问题,需要有个人坐在那里,翻翻线上数据,看看玩家行为,想想商业逻辑。以前这个人是策划,或者是制作人,或者是自己凭直觉
但如果 AI 也能做呢?
三阶:商业洞察
这是我最焦虑的部分——不是焦虑 AI 做不到,而是焦虑有人已经做到了
三阶是什么?我理解的形态是这样的:
玩家行为分析。AI 直接拉线上日志,做用户行为建模。哪些玩家在新手引导的哪一步流失了?哪些玩家连续三天没登录,回来之后做了什么?这些数据以前要找数据分析师排期出报表,现在如果 AI 能实时拉出来、自己就能看懂呢?
商业洞察。从数据里发现付费卡点、流失节点。某个道具的定价是不是挡住了一批潜在付费用户?某个活动的奖励结构是不是导致了一批玩家"白嫖完就跑"?这些以前全靠策划的经验和直觉——但直觉这东西,有时准有时不准。如果 AI 能从海量数据里发现人眼看不到的模式呢?
策划协同。AI 理解策划意图,结合数据反馈,参与版本内容的决策。比如策划想做一个周末活动,AI 根据历史数据说:上个月类似活动的参与率只有 15%,但如果你把奖励门槛从 50 分降到 30 分,预计参与率能到 35%,同时 ARPU 只下降 2%。策划再拍板
类比自动驾驶的进化路径:L1 辅助驾驶(一阶,AI 帮你写代码)、L2 部分自动化(二阶,AI 在工程框架内自主工作)、L3 有条件自动化(三阶,AI 在特定场景下独立做决策)。我们大概正处在 L2 到 L2.5 的阶段,离 L3 还有距离,但也不是遥不可及
焦虑
说实话,想到三阶,我的第一反应不是兴奋,是焦虑
焦虑有两层。第一层是:会不会还没到三阶,二阶的活儿就被更厉害的 AI 替代了?现在用 Claude Code 写代码很爽,但工具链发展太快了,6 个月前的最佳实践现在已经过时。如果有一天 AI 不需要人类搭工程框架就能自己闭环,那二阶也不值钱了
第二层是:如果三阶真的来了,我能不能跟上?游戏行业的数据敏感度和商业判断力,不是靠看几篇论文就能建立的。做了这么多年后端,对玩家行为的理解主要还是靠踩坑积累。如果 AI 能从数据里直接得出结论,那我的经验优势在哪里?
上次写过,“提供快速有效的反馈"才是自己的最大价值。这句话我到现在还是信的。但"反馈"的定义可能需要升级了——不只是"这个接口写得对不对”,还包括"这个方向值不值得做"
反过来想,也许焦虑本身就是答案。能感受到焦虑,说明还在思考,还在试图跟上。最怕的不是 AI 变强,而是自己停下来了
三阶什么时候能到,我不知道。但至少,先把二阶做到极致吧
PS:写这篇的时候想到一个问题——三阶如果真的实现了,那"AI 编程"这个词就不太准确了。AI 不只是在"编程",它在"做产品"。到那时候,编程反而成了最不重要的部分……有点讽刺 XD
本文使用 glm-5.1 模型进行过润色
3 - 使用文件系统映射进程内存
同事写了个游戏控制台,支持读取和改写游戏数据。上周他又迭代了一版,用 Opus 4.6 封装了一个漂亮的 Inspector 网页,调试起来非常方便。
不过我比较懒,更希望 AI 替我看数据。于是我在控制台基础上又封装了一层:通过协议对接控制台,把游戏服务端的数据拉下来写入本地文件系统。这样 AI 就能在自己最熟悉的文件系统里检索和分析了。思路类似 Linux 的 /proc——用文件系统作为窗口,透视远端进程的内存状态。更进一步,我还考虑用 git 管理这套文件快照,通过 diff 发现数据变化,再将差异反写回游戏服,实现数据修改的闭环。
核心考量很简单:AI 逐次调用接口太慢,不如提前把数据备好,让 AI 直接操作文件,效率高得多。
Boss 希望这套机制能用在线上环境。线上不可能全量导出数据,因此思路需要调整:先让 AI 结合代码生成一份需要访问的数据清单,在内网验证数据脚本无误后,再拿到线上执行、拉回数据文件做离线分析。不让 AI 直接调线上 API,风险更可控。
4 - AI 全速开发中
最近用 Claude Code 接 GLM-5 来 vibe coding,有了 AI 加持,解决问题和写需求的速度突飞猛进。更关键的是,以前睡眠不足时经常遗漏边界情况导致的 bug,现在少了很多
回想起来很感谢阮一峰的推荐,趁着过年买了智谱的 Pro 版 Coding Plan,后来纷纷涨价,现在只后悔当时没直接上 Max。搭配 Claude Code 真的很爽,当然 Codex 也很香,不过最近养 OpenClaw 花得有点快……反而工作里没怎么用上 Codex 了
有了 vibe coding 后,反而觉得以前的软件工程最佳实践更有价值了
比如 TDD(测试驱动开发),先写测试再写代码。以前时间充裕会写个测试覆盖 happy path,忙起来就直接写代码手动测。现在 AI 写得飞快,看都看不过来,只能让它先写测试再写代码,自己形成闭环,完成后再来 review,效率反而更高
又比如 SDD(Spec 驱动开发),先把需求确认清楚,后面就不用看它写错代码再返工,常常一次就能成型,真的很棒
自从习惯了命令行后,除非为了 Opus 4.6 这种顶级模型,否则真的用不惯 IDE 了。IDE 的速度明显比 CLI 慢,而且很难形成闭环,受工作目录的约束也更大
命令行的缺点就是语音输入法用不了。现在闪电说、CapsWriter 这类语音输入工具,都是利用剪贴板再贴进文本框的,Windows Terminal 下就没法弄。参考《如何有效地给 10 个 Claude Code 打工》 vibe coding 了一个,不过自己用不下去……总觉得非交互模式下 Claude 结束得特别快,而且看不到 git diff,心里有点慌……可能还是没进化到老板的视角 XD
AI 给的反馈确实很强,但也容易陷入一种「我和成功只差一个 prompt」的错觉,一直肝一直肝,睡眠不足反而容易犯错。还容易刷完 X 后一直处于 FOMO(Fear Of Missing Out)的焦虑中,不断尝试优化自己的工作流。但 AI 进步太快了,6 个月前的工具和方法论,不一定适合当下的模型 Orz
反过来想,作为开发者,现在我觉得提供快速有效的反馈,才是自己的最大价值。这是同时对 AI 实习生和资深人类同事都通用的技能,搭配上合适的技术写作能力,能更好地推动组织发展
PS:最近 LiteLLM 的供应链投毒事件有点恐怖,感觉除非是特别知名、历史悠久的库才会放心用了。不然自己 vibe coding 可能更安全,只要复用开源的测试集就行。比如 Cloudflare 重写了 Next.js,体积下降 57%,相当厉害。
5 - 关于 sharedata 的使用
最近上了全节点热更配置表。起因是有一次热更配置表时没有覆盖全节点,导致数据不一致而 traceback,中断了一个重要流程。由于读表服务和目标服务的相关性比较隐蔽,热更 review 时没能发现这个问题,于是决定后续所有配置表都采用全节点热更。
全节点热更上线后,发现内存会持续增长,多次热更后尤为明显。同事排查后发现是 sharedata 服务的内存一直在涨,应该是旧配置表没有释放导致的。这件事比较复杂,搞清楚后很容易又忘了,决定写篇博客记录一下。
为什么要有 sharedata
各服务的配置内容都是相同的,如果每个 lua 虚拟机都各自加载一份,既浪费内存,热更处理也不够优雅。
sharedata 是怎么做的
为了实现配置表共用,sharedata 在 C 层维护一份公共配置数据,对 lua 层返回一个 userdata。这个 userdata 包含指向配置数据的指针,以及用于减少引用计数的 gc 方法。当引用计数降为 0 时,就可以释放底层资源了。
热更时需要通知各服务进行更新。为什么需要通知呢?原因有二:一是底层没有持有所有指针的引用;二是需要提供一个保证——在处理一条消息的过程中,访问到的配置表版本是一致的。如果不通知就直接更换指针,可能导致数据异常。
因此 skynet 提供了 sharedatad 服务来负责通知各服务热更。但这会引入一个问题:如果服务退出时恰好发生热更,通知就会失效。此时服务不会再发送确认消息说自己已更新、可以释放旧资源,最终导致旧资源内存泄漏。
为了解决这个问题,我们在 sharedatad 之上又包装了一层 sharedata_extend 服务来处理服务退出的情况。sharedatad 永不退出,其他服务需要配置时向 sharedata_extend 申请,后者再向 sharedatad 申请。服务退出时,通过 __gc 方法通知 sharedata_extend,然后由 sharedata_extend 向 sharedatad 提出释放请求。
现在的难点在于:当服务退出时恰好遇到热更,可能出现几种情况:
- 通知不到服务
- 通知到服务后,服务不再回包确认已更新
- 服务地址发生回绕,同一个 address id 已经对应到其他服务了,自然也不会回包
- 用 sharedata 的服务,__gc不一定是服务退出,也有可能只是暂时不用导致被gc。申请也有可能随着资源使用而申请多次
sharedata_extend 需要解决上述问题,才算比较完整。只是感觉这个方案比较复杂,有点像为了一碟醋,包了一碟饺子,又杀了一只鸡的感觉……
PS. 事后反思,这本质上是多线程共享内存的经典场景。理想方案是用 shared_ptr 做引用计数——用内存时计数加一,用完尽快释放——简单明了。
但现实比较棘手:skynet 服务(工作线程)的生命周期不可控,既可能长时间存在,也可能随时退出。如果分配方(sharedatad)在发送通知后超时释放内存,服务端再访问就会触发野指针崩溃。
权衡之下,只能两害相权取其轻:收不到确认就继续持有内存,宁可泄漏也不能崩。
本文由 glm 4.7 润色
6 - ai 主旋律
没想到这就变成了年更博客,完全没想到啊……感觉时间被偷走了一样
这一年里,终于搞清楚了困扰我多年的身体bug的根本原因。有些问题原来是由基因决定的,活了这么久竟然从没往这方面想过。好在今年的体检指标比去年有了明显改善,往后会更加重视健康
这段时间,AI俨然成了集团的主旋律。到处都在宣讲"all in AI",但肉眼可见的实际落地却寥寥无几。这越来越像一场不得不参与的豪赌——不参与可能直接出局,参与了又担心最终沦为AI的打工人,在AI搞不定的地方被临时拉上线救场hhhhh
就个人体验而言,AI在编程方面的进步最为明显。我尝试过用tab补全写完整个功能,也试过完全交给AI ── 只描述需求,让它独立完成一个原本需要3天的开发任务。不过AI在长周期项目上还是容易跑偏,可能是我的提示词工程不过关,给了太多自由发挥的空间。总体而言,这有点像C语言取代汇编的感觉:不再需要纠结具体语句如何构思,除非遇到性能瓶颈,否则AI生成的代码通常够用。最近发现优质模型越来越贵,不付费就限速限频,让人很是难受。这套路像是先给点甜头培养依赖,然后挥起收割的镰刀。最终成本可能还不如自己从头写。集团内部也差不多,之前说内部使用会产生账单但自动冲销,方便大家探索AI应用方向,现在这公告也不见了。中美在争夺算力和显卡,国内平台在争夺算力和用户心智,个人和公司之间其实也在博弈。最理想的状态还是自己部署模型,用自己的模型既能保障隐私又能省钱,关键是不会被卡脖子——不然涨价都没处说理。目前只有输入法实现了"模型自由",还希望文本总结类应用能出个强力小模型,让购物比价、评测总结、小说跳读等功能都能落地,全面提升上网体验
看到别人的博客都在兴致勃勃地折腾AI,说实话很羡慕。自己没能折腾出什么,主要是臆想了一堆困难:比如想定期总结某个网站的新闻,但对方套了Cloudflare的3秒盾,机器人根本抓不到;又觉得Folo之类的产品已经做了AI总结,自己再搞一次不够环保。以后得克服这些心理障碍……Perplexity的AI搜索是真的好用,现在用Google的次数越来越少,特别是那些需要结合专业技能和个人信息的查询,我都不知道怎么向Google表达,可能只能先让自己学会某个技能,再对这个技能进行自我应用了
有了AI之后,与人交流的意愿反而变小了。工作和生活中的问题并未减少,但与AI对话就能得到解答,还附带一点点交流的乐趣,渐渐失去了诉诸文字的冲动。希望这个习惯能慢慢纠正过来,毕竟多输出对自己总归是有益的。开源方面,有了AI就不太担心别人提bug了——当天提的issue让AI当天解决,基本不影响正常生活。上次python-sproto有个issue就是用AI解决的,速度快得惊人。我既惊讶于这么基础的问题竟然一直没人发现,又感慨于AI的高效,实在给力
这段时间最受益的新习惯是写工作日志。每天第一件事就是把待办事项列出来,不然策划和QA的打断太多,忙起来就全忘了……目前还只是做到了日维度的规划和总结,更长期的计划与回顾做得还不够,需要继续努力
本文使用kimi-k2模型进行过润色
7 - 又溢出了
海外上线了,首日无事故,总算平平安安。最近抓了个黑产,发现又是熟悉的溢出, 和旧文如出一辙 ,真是尴尬
这次遭殃的是交易行,也是利用相乘后,一个巨大的数量变成一个小的消耗,刚刚好可以负担得起,于是他就上架了庞大数量的虚拟货币(153722867280914*120000),一直卖一直拿钱 …… 同样的,检查的地方也只是不让负数通过,没有留意到上限,哎,十分尴尬
问了下其他项目,似乎也没有通用校验的,有点囧 rz 先写个通用校验函数吧
8 - 当lua_sharedata碰上上限
最近在使用sharedata共享配置表的时候遇到了问题,报了stack overflow,最小复现的例子贴在这里了。之前因为忙,没有细读过sharedata 的代码,这次事故正好临急抱佛脚读一遍,匆忙记点笔记,以后好回忆起来。sharedata是为了不同服务之间共享配置表而诞生的,通过sharedata接口拿到的是一个 c 的代理对象,并不直接持有配置表本身。正是通过这个代理,实现了配置表的无感热更,以及服务之间的配置内存共享。对于字符串来说,这个C代理持有的并不是字符串本身,而是一个索引,指向lua栈上的一个位置,真正需要的时候,再去lua栈上去拿这个字符串。在初始化的时候,会用一个 table来做字符串的去重,如果是一个新的字符串,则推到栈上并将栈的位置记录下来。以后这个字符串再次出现,也只会用同一个索引来代表,有点类似lua本身的短字符串共享。
正是这个实现,引入了一个上限,配置表里的字符串,数量不能超过lua栈的上限(100万个)。要解决这个问题,可以改lua栈的上限,或者用lua table/userdata重新实现一遍,不依赖lua栈,不过,性能可能差一点。我们最后直接分离配置来解决,100万的上限是针对一次sharedata.new("foobar", big_table),那我多搞几个key就好了
9 - debian12安装nvidia驱动
事缘公司使用4年的台式机可以自购了,第一时间买回家准备搞本地大模型。奈何死活装不上NVIDIA驱动,搞的我都emo了。最近娃丢回老家了,正好有空研究一下
显卡驱动需要编译后加载到内核中,而Intel牵头搞的SecureBoot则通过主板固件检查内核是否被篡改,通过SecureBoot启动的内核,也会同步校验内核模块是否签名,未签名的模块就禁止加载。原理大概就是这样,但是debian官方教程没解释,基本就是让apt装个nvidia-driver的包就完事了……看了很多教程都是在纠结Nonveau的屏蔽上,这次发现其实官方已经都弄好了的。建议参考这篇教程时光机,我自己是直接关掉内核签名检查来解决的,这个教程比较细致,是导入mok(Machine Owner Key)来做签名的,感觉会比较好。
但是,顺序很重要!装了nvidia的包以后,才生成了mok来给我们导入mokutil,而导入不是一次性的,需要重启后打密码确认的,那个界面依赖图形驱动,而nvidia驱动这时候还没有签名,不能启动,死循环了,所以我只好关SecureBoot了……供参考
当然用Nvidia官方的教程应该也可以,但是用nvidia的教程最好先固化内核版本,他那个不会随着内核升级而升级,内核接口改了就容易挂
10 - 项目上线啦
历时 3 年半,项目终于上线啦,打开 tig 翻到仓库的开头,看看提交历史,还是有点感慨的,实在没想到要花这么久。简单聊点线上问题吧
这次上线最刺激的是,开服前半小时,发现昨晚压测的服务器崩掉了,原因是聊天服务内存太大导致 OOM。于是用 memlimit 紧急止血,出问题的方法挂到模块上方便后续线上热更,然后打包,重启,紧赶慢赶在开服前几分钟搞完,提前开服错峰。真的非常非常刺激,当然,线上也没有出现这个问题,我们压测的例子相对比较极端,一大堆人每 30 秒集体跳场景,注册场景聊天的地方又做了锁来保序,平台响应聊天只要有点延迟,就会导致堆积,超时设的 10 秒也有点太长了
上线不久,就发现了黑产在活动,常规操作充值 1 块,然后修改订单金额为 648,这种小伎俩当然是拦下来了。没想到物品合成的地方差点出事故。这个接口一般是客户端发来要合成某某物品,数量为 N。然后服务器拿到 N 和配置里的数目相乘,计算最终所需物品数量,交给背包系统做扣除。为了避免被整,第一版代码我就添加了数量不能为负的限制。结果,线上日志发现有人传了一个巨大的 N 过来,乘以配置中的合成所需数量,就会溢出至负数,也就是合一个物品不仅不扣消耗,还反过来给消耗。幸好,背包里做了扣除物品数量不能为负数的设定,兜底成功
另一个是中间件同学反映的问题,晚间活动的时候游戏的包量骤增,导致 goscon 集群负载到达较高水位,CPU 占了一半,系统软中断占了一半。后面通过临时提高硬件规格解决了问题。晚上脑洞了一下解决方案。之前 goscon 是作为完全透明的一层组件叠加到游戏链路中来的,万一有问题可以马上撤掉,不影响业务。但是公司发展到现在,goscon 已久经考验,赢得了大家的信任,自研的线上游戏基本都经过了 goscon,这时候可以考虑做侵入式的改造了。毕竟,“ 软件架构部分取决于公司组织架构 ”XD
比如一个 boss 移动一下,需要将 100 字节左右的包广播到大几百人的连接上,现在是 skynet 反复写几百个 fd,然后 goscon 再读几百个 fd,再分发出去。游戏人数越多,goscon 和 skynet 的连接数越多,同一帧的广播包数量越多,而连接数和包量到达中高水位的时候,机器的性能下降会比较厉害,没法继续线性增长
脑洞中的解决方案,可能是先做一个特殊的 gate server,负责建立 goscon 之间的通讯,暂时叫 goscon gate。skynet 业务写的时候还是按原有方式写,skynet 业务拿的不是 fd,只是一个整型句柄,这个整型可以交由 goscon gate 解析成 goscon 中对应一个客户端的一个标记。短期目标是业务还是写很多个句柄,但是经网络发出去的时候只会经历有限个连接,比如 10 个连接,包体也经过 goscon gate 做装箱再发送,由 goscon 再拆箱分发,避免发送大量小包。长期目标是提供广播接口给业务,业务直接让 goscon gate 给这数千人发指定包,这样业务只要提交一次,goscon gate 往外也只有一个包,goscon 的收包数量就能直接砍半了
涛神提到我们可以自己做合包,比如攒个 0.5 秒再发。这种会增加延时,之前在 M1 也尝试过,效果不太理想,CPU 比较高。不过也可能是思路不够好,当时是房间里的每个人设置一个发送队列,包先发到这里,定时器定期来检查,有包就发出去。可能好一点的是做两套,非战斗状态下,直接发送,不经过定时器;战斗状态下再走定时器这一套。如果攒的包数量不够,还是会出现小包特别多的情况。攒的太多则会导致包体延时过大,人物移动出现拉扯。还是比较难搞
目前项目内部的消息链路是按广播对象做的合包(参见旧文),发一个消息给网关说给 uuids 发包 payload,但是网关还是需要反复提交到网络。注意这里没有严格保序,房间战斗的信息广播和 box 上的业务包,先后顺序是不确定的,但是网络本身是有序的,所以没法多线程给一个客户端发包,得排队等锁,效率还是不够高
线上事故里自己犯过一个比较蠢的,暂时没想到比较好的检查办法,也记录一下。有个玩法是升级的时候检查下所有图纸,看看有没有后续图纸满足等级解锁的,有就解锁掉。代码大概长这样:
写完中间那坨条件后,就忘记了不能直接往被 pair 遍历的 table 里塞元素了,unlock 里嵌套了好几层,最后就是塞个元素进去 orm。线下和 QA 尝试很久都复现不出来,但是现在已经有经验了,凡是只有部分人出现,不是必出的 bug,大概率是哪个位置有个 pair 出问题了。比如指定的遍历顺序会出问题,而每个人在不同的 box(agent)上,内存中的遍历顺序是不固定的。再比如上面这种某个条件满足了会往 pair 中的 table 插入元素,这时候 next 函数的行为是未定义的,有可能没有影响,也有可能跳过了一些元素。如果能够在遍历 orm 的时候,给 orm 打上一个标记,在往里插入元素的时候再检查是否在 pairs,可能就能解决了
上线后,为了应对线上问题,周六加班,又为了处理客服问题,周日又值班了,于是连续上了 12 天班,同时还在赶一个线上匹配的功能,压力非常大,每天晚上都失眠,好崩溃。幸好老婆一直在支持我,不然我就坚持不下去了 …… 算是一段难忘的经历吧 ……
11 - 首次付费测
游戏终于走到了付费测试阶段啦,头几天遇到了一些奇奇怪怪的问题,记录一下
首先是内存问题,压测没有测到反复登录的情况,线上发现内存占用逐渐上升,到了一个玩家 40M 的惊人水平。正想着手查哪个模块耗的内存多,涛神下来讨论问题,让我先看一下 uniqtask 的返回,结果好家伙,基本上每个 agent 服务上都挂了 400 多个协程在上面,review 下代码发现每个协程都拿着一个角色,导致内存没法释放。兹事体大,没有立即解决挂起的协程了,先热更修复这个代码的问题,然后降低 agent 的复用次数,等玩家自然退出,销毁 agent 来释放内存试试。这里暴露出几个问题:
- 对 agent 内模块的内存占用,目前没有分析手段
- 协程管理不够完善,玩家下线的时候没有强制关停所有挂起的协程
- 原有的 agent 释放机制是按接待的玩家数量来的,达到 limit 后退役对应 agent,面对模拟器一直挂机的玩家会失效,需要重新考量
其次也还是内存问题,轮到 goscon 了 …… 上篇文章 提到 goscon 的良好实现,没有写就不会读,但是线上出现的是可以写,但是没有 ack =_= 看系统内存占用,goscon 的机器才用了 30% 的内存,但是阿里云的告警电话居然打过来了,喊上阿里云的小伙伴一起看,短时间内也没看出个由头。运维同学果断摘掉机器流量,再慢慢抓包查了,排查到最后发现是 goscon 的 Send-Q 偏高,这部分内存不算在进程上,所以容器和进程监控都没报警,用 top 看 goscon 的内存占用也很小。后续监控要加上 Recv-Q 和 Send-Q 这两个指标了。到这里才发现之前压测的时候没理解清楚,我以为现有心跳会超时踢人,结果发现不会,后续要加上踢人的;系统这种奇怪的表现回头也得看看,TCP 连接没有断,滑动窗口也还能写,写出一个巨大的值,对端还会一直没 ack
12 - 压测周
最近一周做压测,发现了几个 skynet 使用上的问题,记录一下
目前的进程大概分成 center、login 和 room 三种,login 用来承接玩家连接,做一些单机玩法,center 做一些玩家间的附带玩法,比如公会、排行榜,room 处理房间相关的战斗逻辑和 aoi 剪裁
首先发现的问题是建公会相关的。压测的时候居然不是 center 进程挂了,而是 login 进程先挂掉了,公会服务负载还比较低;还附带副作用:建立的公会多了,就再也起不了服务器,center 一定会在启动的时候挂掉。用中间件针对 skynet 开发的 top 去观察内存,发现居然是 Sharedatad 吃掉了大部分的内存和 CPU。排查了一下相关调用,在实际调用 sharedatad update 的地方,fork 了协程做延时 update,并打印 update 的 res 名字。发现到动态玩法开关会频繁的更新 sharedatad,导致内存猛涨,而 sharedatad 的回收会比较慢, 看代码 每次 update 要 1 分钟才会回收。对于频繁更新这种场景,可能换用 datacenter 会好点
其次是压一个 5000 人的房间玩法,居然不是 room 进程挂掉,而是 login 进程挂掉了。全链路是施压机 ->goscon->login->room,具体房间逻辑是 room 处理的。看 skynet 的 sys_list,是用来转发房间广播的 room sender 服务 cmem 偏高。花了不少时间去 review 这块代码,以为是自己写的 C 扩展出问题了,具体优化可以看 《Skynet 广播优化小记》。CM 提示有可能是对端读不过来,用 netstat 看一下积压的队列情况。在 login 侧是 Send-Q 偏高,而 goscon 侧是 Recv-Q 偏高,施压机则是两者都不高。而 goscon 的内存和 CPU 都不高,考虑是不是 goscon 不干活了
多压了几次看问题,然后 SA 找上门了 =_=川 说把 nat 网关压爆了,影响其他项目,让换个地址再试试。于是得知全链路是施压机 ->nat 网关 ->goscon->login->room。nat 网关是项目间共用的,之前定的性能规格不够高,我们压测才 40MB/s 不到,居然也吃掉了大部分性能了 …… 去掉 nat 网关用内网地址访问后,问题就解决了。这样看来 goscon 的实现是正确的,发现写不出去的时候,就不再读新包了,所以 Recv-Q 偏高。这里不太理解的是,goscon 写不出去为啥没有 Send-Q 变大,难道是 goscon 写的都发出了,但是内核没有可写信号给 goscon,所以就不会往里写,不会积压
周末好像想明白了为啥 Recv-Q 和 Send-Q 单位是字节,因为没发出去的时候,还不知道该怎么分 TCP 包,所以这里不是包数量,而是 buff 大小
13 - 视频分析
最近 AI 因为 ChatGPT 大热,正好找个由头玩一下,家里为了看娃装了个摄像头,一周拍的录像大概 20 多 G,可以拿来练练手。之前都是老婆人肉一个个看的,我这次先筛选出有动静的片段,后续老婆再看
最初的想法,是使用 haarcascades 分类器的,毕竟是老牌分类器,又是 opencv 自带的,公司用了一段时间也还行。但是 full_body 和 frontalface 都试过了,家里光线和环境比较复杂,误报很多。无奈换成了有动静才保留对应视频,这里参考了 利用 OpenCV 过滤监控视频,定期删除静态视频 这个方法比我之前逐帧分析高效太多了,是跳着看的,中间也能利用 GPU,就是不确定是高斯模糊用上了 GPU,还是图像对比 findContours 用上了
最终代码大致如下:
写完后发现,有人写了个 Python 包做这个事情,叫 DVR-Scan,不用自己写代码了。。。回头试试用一下。话说 ChatGPT 3.5 真的比较弱,这个话题反复问也没给到很好的解决方案。。。
14 - 43 周回顾
很佩服阮一峰每周出一篇网志,我也尝试着每周写一篇杂萃,记录一下本周遇到的有趣网文
Netflix 作为流媒体领域的巨头,在刚过去的 2022 年 Q3 上线了超过 1000 集电视剧,而幕后默默支撑 Netflix 帝国的缓存服务器却鲜为人知,这次发现悄悄的开了一扇窗 :)
Google Chrome 作为市场占有率第一的浏览器,也是众多黑客的重点关注对象,这次修复更新已经是今年内第 7 次 0day 漏洞修复了,有点害怕 😱
Python 3.11 进一步增强了 AsyncIO 库的功能,提供了任务组的抽象封装,管理一组执行类似任务的协程更方便了。 中文手册
真是大开眼界,出Bug不要紧,只要你的应用足够吸引,操作系统甚至会为你调整内存分配器XD 即使你写出了一个释放后马上使用同地址内存块的bug,操作系统还能给你留着这块内存,先不分配给其它人
15 - SSH 产生公钥
github 最近新增了 ssh 公钥签名的展示,正好可以试一下。结果发现使用多年的私钥已经找不回匹配的公钥了 …… 记录一下免得以后又忘了:
git 设置使用 ssh 签名:
16 - 折腾 HTTPS 的一点笔记
最近,在同事多次推荐下,终于将家里 NAS 的 Nginx 换成了 Caddy,顺便看了一下相关的各种资料,写篇文章记录一下
为什么要申请 HTTPS 证书?
因为 http 是明文的,从客户端到服务器会经历多跳路由,其中任意一个开启捕获模式,都会将 http 的明文会话记录下来。为了避免密码明文在网上传输,以及照片、文本被窥视,还是套上一层加密比较稳妥。之前我的选择是用 ssh 隧道映射端口到本地,再用普通的 http 访问。但是 iOS 的后台保活时间比较短,ssh 隧道很容易断,而 ssh 建立连接的步骤又比较多,在移动网络等复杂环境下,体验很差,有一次在坐小火车去公司的路上,拉个 RSS 多次断开链接后,一怒之下决定换装 https 了
HTTPS 证书如何申请?
之前就折腾过 Let’s Encrypt 的证书,用的 certbot 做证书申请,当时自己搞了个域名,用的 HTTP-01 方式完成 ACME 挑战的。ACME 是 Automatic Certificate Management Environment(自动证书管理)的简称,ACME 挑战是为了验证申请人对证书附带域名具有所有权。常见的方式有两种,一种是 HTTP-01 方式,需要在服务器的 80 端口提供服务,在指定路径下放置指定密文,密文验证通过后即可获颁证书;另一种是 DNS-01 方式,需要对域名设置 TXT 记录,在记录中包含密文。后一种方式权限更高,可以申请通配符证书(应对二级、三级域名)。因为是自用, 家庭宽带不适宜直接在 80 端口和 443 端口提供服务 ,所以我选择了 DNS-01 方式做验证
顺便说一下,联合创办 Let’s Encrypt CA,发起 Let’s Encrypt 和 HTTPS Everywhere 的计算机科学家 Peter Eckersley,已经在 9 月 5 号去世了,RIP
HTTPS 证书一般由什么组成?
跟 ssh 的公钥私钥有点像,也是有公钥和私钥的区分。私钥一般是一个后缀为 .key 的文本文件,里面记着 RSA 的私钥。公钥一般是名为 fullchain.cer 的文本文件,包含了完整的证书链,即个人站点的证书由中间证书的公钥签发,验证通过后证明个人站点证书非伪造,的确来自中间商,然后中间证书一般由各大根证书商签发,各大根证书商的证书是预装到操作系统和浏览器里的,可以轻易验证
为什么用 Caddy?
Caddy 的全自动 HTTPS 很方便,只要你的域名提供商支持 API,而 Caddy 有对应的插件,填上密钥后 Caddy 就会自动申请证书了。不过之前证书都申请下来了,目前没有使用这个功能。主要是 Caddy 的配置简化一点,不需要针对 Websocket 额外配置,反向代理也不用像 Nginx 一样配一堆 proxy_set_header。Caddy 令我最惊喜的是 v2.6.1 已经支持了 HTTP3,即以前 Google 开源的 QUIC 协议
HTTPS 的未来
最早的 HTTPS 协议只是在 HTTP 协议上套上了一层 TLS 加密,但是实际使用的场景只有银行、政府等领域比较多一点,因为速度比较慢,不仅要经历 TCP 的三次握手,应用层的 TLS 还得做一次握手,每次请求资源都握手一遍,那肯定受不了了。虽然根据 HTTP 1.1 协议,一个连接可以发多个请求,握手时间平摊到每个请求上能显得小点,但是必须等一个请求完成后才能发下一个,如果请求涉及数据库查询,比较耗时,那还是得等。Google 为此推出了 SPDY 协议,即后面的 HTTP 2,支持了多路复用,针对 HTTP Header 做了 HPACK 压缩,冗余数据不用发,同时连接实现了复用,不会因为一个耗时请求阻塞后续请求的发送,提升了性能。HTTP 2 剩余的问题是 TCP 层面的,一个是 TCP 固有的三次握手,其次是偶尔丢包时 TCP 拥堵调度算法的慢启动(Google 为此开源了 BBR 算法并进入 Linux 内核),以及 TCP 丢包引起的类似 HTTP 1.1 耗时请求的 head of line blocking(HOL blocking)。换成 QUIC(后面标准化后的 HTTP 3)协议,可以省掉 TCP 层握手的时间,直接进入 TLS 握手和业务数据的发送阶段。同时,后续可以更具灵活性的做拥堵控制算法了。没有了固定连接,也就不会有 TCP 的 HOL blocking 问题了。还能通过前向纠错以一点带宽为代价,将偶尔丢的包补回来,减少时延
那怎么知道一个服务器能不能支持 HTTP 3 呢?可以通过 HTTP 2 查询,不过开销会比较大,所以后面 DNS 记录新增了一种 HTTPS 记录,用来记录是否支持 HTTP 3 及服务的 UDP 端口。客户端同时发送 HTTPS 记录和 A/AAAA 记录查询,如果有 HTTPS 记录则针对对应的端口做访问,目前 HTTP 3 已经正式标准化,支持 HTTPS 记录的客户端还没完全跟上,有兴趣可以 阅读这篇文章
17 - 流量压缩
最近中间件组开始尝试推送 goscon 流量压缩的更新,继上次用 libev 改写 goscon 提升效率后,又是一大改进了。可惜我们没机会上了,CM 觉得我们没有带宽的压力,引入更新只会增加潜在风险。站在团队角度看,我很能理解这个理由啦,但是单纯的从技术追求角度看,又心痒痒的很想上,纠结 ing
中间件组的实验报告很有意思,中间提到了一点,sproto 的 pack 算法反而会降低最终的压缩率,sproto 的 pack 是针对二进制串里连续的 0 做的压缩,应用层做了压缩后,反而影响到压缩算法的全局压缩效率了。目前为了快速实现,只是针对每个协议来单独压缩,而且选的是成熟的经典算法,如果换成 zstd 应该能更好一点。而且 zstd 能够预训练字典,对于 sproto 协议这种数据量相对小的样本,应该能取得更好的压缩比,zstd 的解压速度还特别快,完美!剩下的疑问是要不要搞成流压缩,流压缩可以根据前一段字节流来调整字典,有可能取得更好一点的压缩比,但是出现比特翻转的话,会导致后续的协议都解不开。如果上行不压缩,只压缩下行的,这个问题可能可以忽略,毕竟服务器都用上了 ECC 内存,而上行的协议流量也比较少
updated: 看了中间件同学后续的报告,用字典只有非常非常微小的提升,可能是因为sproto里就没有大段大段固定的字节吧,如果是msgpack之类的,字段名应该能用字典方式压缩不少
18 - 沉迷 docker
最近抵不过同事的热情推荐,用上了 docker 来部署一些私有应用。得益于 Docker.app 对 MacOS 的原生支持,终于不需要再额外跑一个虚拟机了。搭配着 portainer 做 web 端的管理,使用起来相当方便
之前对 docker 一直不太感冒,docker 提供的隔离性对我没感觉,总觉得软件来源是可信赖的商店就行了,包管理器可以做到一键安装,卸载干净,同时安装的时候会挑选依赖少、尽量单一二进制包的应用。现在通过 portainer,用上了 docker-compose 来安装应用,才渐渐理解了隔离性的重要。首先,软件包来源即使是可靠的,也不一定没有 bug,多一层隔离总是好的;其次,docker-compose 这类工具提供了定义应用资源的一致性界面,可以通过统一的方式绑定端口和磁盘等资源用量,不用再细看应用说明手册来找配置改端口;再次,是应用本身可以有不一样的依赖了,允许各自有各自的数据库类型与版本,带来更高的灵活性了
其实一开始想部署的,是私有网盘,但是机器只是外挂的硬盘,稳定性不够高,搭建私有网盘意义不大。于是先找几个应用练练手看看,同事推荐了 RssHub 用来做 RSS 的汇总,我自己挑了 miniflux 做阅读器,实际用下来体验还不错。还搞了个自动签到的,顺手给各大网站签到玩玩。这年头需要不被应用追踪,就只好自己动手,丰衣足食了
19 - 代码扫描
最近犯了一个很蠢的错,Code Review 的时候觉得非常丢人,决心不再犯第二次了,同样的错误不再犯第二次,才能不断进步XD 于是写了个小工具来检查。但是实际跑起来,才发现 Lua 这里设计得不太好,留下了一个合法但很容易犯错的坑
具体错误非常简单,就是 for _,item in ipairs(seq) 写成了 for item in ipairs(seq)。而且由于 seq 里的值某些情况下会包含 1,2,3... 的序列,所以还不容易发现异常。花了一点时间写了个扫描器,主要还是调一个正则出来,扫描 for.*in ipairs 的用法。如果只用了第一个变量,那多半是写法有问题。通过这个扫描器,的确抓出了几处写错的地方
看完了所有异常警告,发现有些地方确实是用来做索引的,虽然很蠢但是结果上还是对的,有点蛋疼。明明 i=1,#seq 能够很好的代替 for i in ipairs(seq),只是写了后者也不能说写错了,很抓狂。中间还发现有人写了段很蠢的代码:
既然都用了 table_insert 代替 table.insert,说明对代码的速度还是有点追求的?那明明缓存一下 #cfg 就可以反复用了,为啥每次都创建一个临时 table…… 真是想不明白,看来只能靠团队约定了
语法设计上,ipairs 返回 index 和 val 应该是为了和 pairs 对称。但是允许了只访问 seq 的 index 这种写法,就容易滋生 bug,毕竟只要 index 的话用 i=1,#seq 就能做到,还能快得多。如果加 enumerate 呢,又觉得多增加了一个需要学习的特性,不雅观,设计真难。。
20 - sproto 添加版本号
明明需求都做完了,硬要拉着人家去公司加班,真是变态 ToT
最近想推动一下协议版本号的事,版本号不一致的禁止登录。理论上,只要改了某条协议的定义,而客户端因为各种原因没有更新到协议文件,就有可能导致协议解析出错,服务器拿到异常数据。因为 sproto 的定义是放在 spb 文件里,而不是在网络字节流中,所以拿到数据后用不一致的 schema 去解开,真是无法预期会拿到什么,如果还直接拿这个数据去存盘了,就更危险而难以修复了
之前没有出过问题,可能是客户端更新机制做得比较健壮。客户端上线先拉取版本号,如果拉取失败就不允许上线,拉取后版本号不一致也不允许上线,必须完整更新后才能上线。这就保证了前后端协议定义的一致性。也有可能是逻辑写得比较复杂,并不直接存盘请求数据,而是用配置表和玩家状态对请求做了一定的校验,最后再保存玩家状态。当然,也可能是需求很少迭代,对外的功能要么没啥收入,渐渐被废弃掉,要么比较能赚钱,策划也不敢改。。。顶多往上层层垒新功能。客户端没有新增协议一般只会没法使用新功能,不至影响数据安全性
QC 同学对这个比较抵触,他们担心开发期协议改动比较频繁,而客户端内网打 patch 总是比服务器更新要频繁的,只要有不兼容修改(改字段、删协议、改协议号、改字段编号),那就登不上服务器。在 QC 同学的期望里,应该只有外网包才打协议版本,内网即使打也不超过一天一次。他们也提到能不能将协议版本定细一点,比如每个协议都有一个版本,双方收到协议时先校验版本,不一致就不解析。内网的需求之前是客户端同学提的,觉得内网很多报错都是因为协议没有更到最新,所以协议不一致就不应该能登录,或者报错的时候多给个提示说协议有问题。看起来一个 namespace 一个版本号也可以?
21 - Skynet 广播优化小记
最近和 QC 同学共建一套自动化压测的框架,希望能够确定游戏的性能基线,通过自动化定期回顾,看看有没有引入性能劣化的代码。压测过程中,发现广播性能不够强,搞的清明假期也在家想问题,写篇博客记录一下
为了让房间服务能腾出手专心处理战斗相关内容,我们针对性的改进了打包和广播,分离到一个与房间 1 比 1 配置的 sidecar 服务上去,期待能多利用一个核的算力来实现。在维持客户端链接的 login 节点,我们也做了类似 Skynet 的 cluster 模块的优化,拆分开一个 gate 和多个 sender,sender 负责实际的写 socket,配合 Skynet 的 direct_write,可以实现多线程写 socket。整个链路如下:
多亏了子熏老师搞的火焰图,可以快速定位到热点函数。配合 top 工具,先定位到 CPU 占用最高的热点服务,再抓到耗时最多的函数,发现是在 sender 上运行的广播函数。功能是将输入的一堆玩家标记数据及包数据,发送到对应的 fd 去。我有点想当然认为是 Lua 与 C 频繁交互的锅,于是写了个多播的 C 接口,外面先用 Netpack 打好包头,只调用一次 C 接口,由 C 全部完成数组的遍历与 socket API 的调用。
实际效果的确不错,但是单独测试过 for 循环遍历 table 后,我发现原因主要并不是减少交互。在单独测试中,C 遍历 lua table 只有 10% 左右的性能提升。真正起作用的,应该是省略了多次 Netpack。之前的实现是面向单个玩家设计的,每次发送前都要对相同的数据包调用一次 Netpack,无形中多拷贝了很多数据。优化后,sender 的 CPU 占用虽然也在 80% 左右,但是每秒处理的包量从 5000+ 到 9000+ 了
还能更快吗
sender 优化完后,轮到 gate 的性能吃紧了。我第一反应也是搞个 C 接口,cm.yang 觉得我们可以先在 Lua 层优化一波。通过将最终用户的 fd 上推到 sidecar 里,简化 gate 和 sender 的分发逻辑,实现精细化管理,真的能有效吗?在之前的实现里,gate 是遍历所有收包玩家的标记,找出需要发送的 sender,再给 sender 一个一个的发消息的。因为 sender 只有 6 个,我觉得还不如直接给 6 个 sender 都发了,因为 sender 自己还有一层类似判断,通过遍历标记找属于自己管理的 fd,不怕发重了的。结果 gate 的负载没有优化掉,反而 sender 的包更多了
于是,我们上了精细化管理的改造。gate 拿到了每个 sender 对应的 fd 列表,对每个 sender 精准推送需要发的 fd 和协议包。gate 本身省掉了遍历玩家标记找 sender 的过程,发送给 sender 的参数也可以变短,从所有需要发送的玩家,到该 sender 所属的玩家。提升效果非常巨大,gate 的 QPS 已经到了 4w,CPU 占用在 90%,而省掉了分拣逻辑的 sender,也上升到 1.2w 的 QPS 了
还有办法更快吗
压测后发现 CPU 被用完了,虽然性能很高,但是对总体 CPU 消耗还是太大了,撑了几分钟就挂了。当前的压测机器用了 8 核,gate 和 sender 已经占了 7 个,高负载的情况下的确有点离谱。我又去 review 了一遍压测机器人的代码,发现与客户端的实际行为还是有偏差的。真正的客户端并不会关注那么多玩家,本身终端性能就不支持画那么多角色。。。接下来应该会降一下关注数量的硬上限,减少广播包的数量
恰好遇上一个清明假期,忍不住花点时间研究下,还能不能继续提升广播性能。节前波波同学提到用 Skynet 的 multicast,优化下 gate 和 sender 的通信。写起来是挺快的,但是要额外绕一层 multicastd,而且发给 sender 的消息需要退化成老版本,每个 sender 收包需要一致,再自己分拣需要发出的 fd 列表。我琢磨了一下,还不如直接用 multicast 底层的 C 库。猜想是压力在于 Skynet 的服务间消息通信,需要反复拷贝字符串,那我将需要反复拷贝的部分改为发指针不就好了。但是折腾过 multicast 的代码后,还是不明所以,觉得很绕
multicast 的示例代码里,首先是用 Skynet.pack 将 lua 数据变成一个指针和长度,然后用 mc.pack 将数据放进一个带引用计数的 package 里。这个 mc.pack 返回了一个指向 package 指针的指针和 package 指针的大小,接着用 Skynet.tostring 模拟成一个 lua string。再调用 mc.bind 来设置 package 中的引用计数,顺便就将这个指向指针的指针 free 掉了!我不理解,为啥要用 Skynet.tostring 来模拟 lua string,难道这样才能跨服务发指针?另外一头是怎么解压 tostring 的结果的呢?我也没看懂,难道 Skynet.redirect 配搭 mc.unpack 就行了?mc.unpack 的输入是指向 package 指针的指针和 size,tostring 可以模拟第一个参数,那第二个 size 是怎么来的呢?
放假期间就在各种折腾,基本将 gate 和 sender 两边的打包解包排列组合都试了一遍 …… 最后自己折腾了一个方向,加了一个 pack_reference 的 C 接口用于打包并设置引用计数,以及另一个直接从 package 指针解压数据的 new_unpack,配合使用暂时没啥问题,回头压测看看性能。通过这组接口,gate 只需要打包一次数据,然后各个 sender 负责解包,解包过程只是指针操作,不需要拷贝字符串,应该能释放更多性能。最后通过 mc.close 来减引用计数并释放内存块
折腾期间经常有种冲动,如果我将 fd 列表用自己写的 C 打包格式来打包解包,是不是用起来更快了?但是这样会导致侵入量过多,和 Skynet 设计初衷不太相符。现在这套协作方式应该还是以 Lua 为主的,Lua 驱动主逻辑运行,性能关键部位用 C 写,所以所有的 C 模块交互,都是通过和 Lua 交互完成的,而不是直接调用另一个 C 模块的接口。对于目前的广播场景这种热点,希望部分参数不经过框架层打包解包的,毕竟还是少数
update: 请教了大佬们, 用Skynet.tostring是为了方便管理,发过去解包的时候,会用个void*指针指向这个字符串,正好就是mc_package**了
引用计数管理协议字节块没体现什么优势,可能包太小了,接下来试试将conns打成字符串再发送,C层直接解析这个字符串成fd列表,看看性能
22 - proxychains4.16 的新行为
proxychains 用来转发命令行工具的流量十分趁手,但是最近升级到 4.16 后没法上 github 了,于是好好研究了一下新的配置,写篇博客记录下
proxychains 是利用了 LD_PRELOAD 的方式抢先加载,然后将命令行程序的网络流量都按 Socks5 或者 HTTP 代理的方式转发出去。如果访问的是域名,则还需要进行一次 DNS 解析,再用 socks5 代理或者 HTTP 代理直接链接 IP 进行访问。当然,为了更完整的隐私保护,一般会在配置文件里打开 proxy_dns,由 proxychains 负责转发域名查询请求
之前的版本里,DNS 解析这个事情是透过 proxyresolv 这个小脚本完成的,不仅因为要额外 fork 进程而变慢,这个脚本里默认的 DNS 服务器还是 4.2.2.2, 一个不再对外提供服务的 DNS 服务器。新版本里改进了 DNS 解析的方式,提供了三种方式:
- proxy_dns 用一个额外线程做 DNS 查询,并且按 remote_dns_subnet 的配置分配一个假 ip,当目标程序访问假 ip 的时候,再将流量转发到真正的服务器
- proxy_dns_old 采用老的 proxyresolv 脚本来进行 DNS 查询代理
- proxy_dns_daemon 在后台自己跑一个 proxychains4-daemon 进程,优点在没有线程分配
当采用 proxy_dns 的时候,curl 工作的很好,但是以 ssh 方式 git clone 却出现了问题。换成 proxy_dns_daemon 后解决了。猜测是 ssh 工作的时候,需要先查询域名对应的 ip 是否满足白名单,然后再进行连接,而 DNS 查询相对比较慢,还没查到 ip 的时候 ssh 就终止了,提示查不到域名。当采用独立进程的时候,返回的是一个假 ip,ssh 查到 ip 后进行连接,proxychains 就直接转发流量了,所以没有问题
验证这个假设可以用两种方式完成,一种是通过查看 ssh 的日志本身。通过 GIT_SSH_COMMAND="ssh -vvv" proxychains git clone xxx 可以让 ssh 打出详细的调试日志,这边看 proxy_dns 方式的 ssh 日志,的确是 lookup 的时候就中止了。另一种是用 strace 将系统调用打印出来,但是中间干扰比较多,proxychains、git、ssh 这三者都有大量的读文件操作,可以用 -e trace=’!%file’ 表示过滤文件相关的 syscall。当然,最后还是没看出来到底啥问题,于是去查了下 issue,发现最近的一个 issue 描述了 ssh 的问题 。Linux 内核 5.9 添加了新的 close_range 接口,openssh 用这个接口替换了以前的 close 接口,直接把 proxychains 里查询 ip 线程的 fd 关掉了 …… 作者推荐了两种解决办法,一是通过 proxy_dns_daemon 查询,二是通过编译开关关掉 openssh 对 close_range 接口的使用
去openssh的源码里看了一眼,close_range接口是封装在close_from接口里的,看起来就是close_from(start_fd)关掉从start_fd开始的所有fd,回头看strace的日志,具体调用参数是close_range(3, MAX_INT, 0),好吧,原来只是为了将stderr及其他文件fd关掉……
23 - 使用 jemalloc 的潜在问题
今天读到一篇 关于 Firefox 内存优化的文章 ,里面提到使用 jemalloc 时遇到的一个小问题,不知道有没有现成的 API 可以统计,回头看看。
Jemalloc 是用来减少内存碎片化导致的内存损失的。内存碎片化是指可用内存被分成了一片片碎片,虽然总量够用,但是无法按需求分出指定大小的块。操作系统是按页(page)进行内存管理的,每页被浪费的内存会成为空洞;另外,部分释放回来的内存会在已分配内存间形成碎片,比较大的内存申请也塞不进去碎片里,导致内存损失
比如上图里一共有 7 个单位的可用空间,但是被分为了 3 和 4 个单位,当需要分配 5 个单位时就没法分了
Jemalloc 的技巧就是将内存分配规整为不同大小的类别,然后将这些不同大小的内存块分配到连续的内存空间上。当内存释放后,相似大小的请求可以复用旧内存块,减少碎片。这种设计会因为分配请求对齐到 2 的幂上而浪费一部分空间,极端情况下会浪费 50% 的空间。比如,17 个字节的分配请求会拿到 32 字节的块,1025 的请求会拿到 2048 的块。为了统计内存使用情况,arena 留了一部分字做簿记信息,导致 4KB 的内存申请总是拿到 8KB 的块
按理说 jemalloc 不应该犯如此低级的错误,看 jemalloc 的手册 能确认的是 17 会对齐到 32,但是 1025 只会对齐到 1280 的,不知道是不是将这个 Bug 修好了。回头试试将内存分配的请求都打印下来跑个统计看看
update: 找到作者Nicholas Nethercote的原文了,好想要NN那个内存分配日志的脚本。。。
又及:云风也写过一篇类似的blog,有空还是自己打下日志看看,估算一下slop的大小吧
24 - golang编译问题
最近中间件来了一位新同学,帮忙将goscon的重构了,着重提升了goscon的网络读写性能。这个修改通过cgo的方式引入了Linux的epoll,比golang原生的网络读写好多了。但是在QC同学的祖传ubuntu 16.04镜像上,死活编译不通过,网上也没找到资料,所以留一篇记录,方便以后查询
报错信息:
用export LC_ALL=C 可以将中文报错信息转换成英文报错信息:
最后在goscon的编译指令上加上了-ldflags="-s"暂时解决了,-s是disable symbol table,还不清楚为啥要关闭符号表才能编译通过。我猜是gcc版本太低,因为我在ubuntu 1804上,gcc 7.5可以顺利编译过的,在ubuntu1604上带的gcc 5.3死活过不了。本来想升级gcc来验证这个想法,无奈祖传镜像不认ppa的证书,算了
25 - CPU 画正弦曲线

周末终于有时间尝试在树莓派上写代码,好久没写 Rust, 写了个正弦曲线玩玩 :)
大致思路就是先定好取样点数量,以 300 毫秒为一个单位,算好 2*PI 周期的正弦曲线值,CPU 需要忙多少毫秒,闲多少毫秒,然后死循环跑就行。通过 while 循环不断检测经过的时间是否满足条件,满足后直接 sleep 过去。这里还需要用到一个第三方的库 core_affinity,将线程锁在第 2 个 CPU 核心上(第一个核心应该是 Linux 调度器所在的核心,避免影响它)
不得不说,树莓派 4B 的性能也很孱弱,我已经超频到 2GHz,在编译 Rust 的时候,还是找回了当初在校 586 编译 Turbo Pascal 的感觉。。。我现在最希望等到 SDM 845 mainline Linux 成功,我收个二手 OnePlus 6T 拿来当主机用,性能比这强多了,至少不至于编译的时候上网查资料还会卡。。。祝各位周末愉快 XD
26 - 发布 pysproto
今天是个值得纪念的日子,我终于将适用于 Python 3 的 pysproto 成功上传到 pypi 了,顺便写一篇博客吐槽下 Python 的打包发布系统
依稀记得之前将 C 文件都放在 src 目录里,结果死活编译不过,于是都散装放在根目录了;然后 Pypi 要先发布测试包,再在网页操作一下,发布成正式包。setup.py 作为包的描述文件,long_description 字段还得用 reStructure Text 的格式写,不然就提交不过。pysproto 这个模块需要头文件,但是屡屡打包都没打进去。感觉打包模块在这里是 broken 的, 有个 stackoverflow 的回答精确描述了我的感受 : 在 sources 字段列举头文件会导致无法编译,distutil 不能区分 .h 文件,会试图编译对应的 .o 文件;在 headers 字段列举头文件会被忽略;在 setup 函数的 headers 字段里列举头文件能识别,但是不会被打进包里;在 Extension 函数的 include_dirs 里列举头文件,也不会打进包里。最后还是用了最高赞答案的 MANIFEST.in 文件里写一行 graft 头文件路径 , 终于解决问题。。。
要测试打包是否工作,可以试试用 python3 -m build 来测试,需要安装 venv 和 build 模块。这个命令会新建一个虚拟环境,然后打包成源码,再在虚拟环境里编译安装源码。不过最后还是真机测试了一下,修正了 Python.h 头文件写死绝对路径的问题。。。
还有一个奇怪的点,pypi 的网页版不支持直接新建项目,新建 token 的时候却要选择项目。于是,被迫在 ~/.pypi 里新建一个高权限的 token,将包上传上去,建立一个项目,再删掉 token,新建项目专用 token,相当别扭。。。而且为啥上传包居然是用 twine,不是用 setuptools?
好吧,从 2017 年到 2021 年,总算将包上传上去了。。。
27 - 折腾Makefile
最近有同事写了个 shell 脚本,可以通过比较源文件和目标文件的时间戳,实现部分编译的功能。我觉得这个是 make 的本职工作,于是花了 " 亿点点 " 时间研究了 Makefile 怎么写,简单记录点笔记
make 主要用来做自动化构建工作,只要我们在项目文件夹内定义 makefile(或者 Makefile)文件,make 就会按照规则来做构建工作。makefile 的一个简单示例:
这个例子里定义了一条规则 main: main.c,规则生成 main 可执行文件,我们称 main 为一个构建目标;该规则依赖 main.c 源文件,如果 main.c 发生了修改,就会自动重新编译 main 文件。gcc main.c -o main 表示一条构建命令,用于构建 main 目标,注意这里需要在行首添加一个 tab,不然没法区分是不是构建命令。我们在目录里执行 make,不需要指定目标,就会自动执行 main 的构建工作,因为 make 会自动执行遇到的第一个构建规则
在前面的 Makefile 基础上,我们再添加一个目标 clean:
以后敲 make clean 的时候,就会移除 main 文件了。但是 clean 并不是一个文件,一般对这种目标我们会定义一个伪目标,比如:
简单的构建规则这样就够用了。困扰我的是这次需要编译的源文件,是不固定的,后期会新增,所以没法在 Makefile 里清晰指定,需要用到一些隐式规则和变量展开的知识,比如:
上面的例子里,定义了一个隐式的规则 $(BINS): $(OBJS),表示 .bin 文件依赖同名的 .obj 文件,比如 base.bin 依赖 base.obj 文件。然后定义了一个伪目标 map,这个目标依赖所有的 bin 文件。问题在于初始化的时候,还没有生成 bin,我怎么要生成哪些 bin 呢?这里就用到了一些文件名处理的工具函数了。$(wildcard *.obj) 表示找出当前目录里所有的 .obj 结尾的文件,patsubst 表示 pattern substitute(模式替换),将 .obj 替换成 .bin,就得到了我们想要构建的所有 .bin 文件的文件名了。最后一个点在于生成工具 gen,只接受不含后缀的文件名,所以需要用 basename 处理一下,比如 base.bin 只会取出 base
最后执行的结果多多少少有点出乎意料,gen 工具本身其实是支持多个输入参数的,但是按这个规则构建时,每次只会获得一个参数进行构建。相当于 make 自动找出需要构建的 .bin 文件,然后每次只构建一个,好处是可以用 make -j 做并行化处理,同时用上所有的核心吧
参考资料:
28 - Skynet require 的更新
最近升级项目依赖的中间件,中间件组的同学强力推荐(打发XD)我去看看 skynet.require 的修改,很有趣,而且是其中一个比较大的不兼容改动,我重新看了 Skynet 的代码 确实比以前更好用了,这里简单分享一下
服务启动的时候,往往会用到 sharedata 服务来全局共享一份数据表。sharedata 服务的 API 初始化时会使用 skynet.call 来调用 sharedata 服务,因为 call 最终会调用 yield,而 require 是一个 C 实现的函数,无法在其中 yield,就会报错。为了解决这个问题,一般是将这段 call 放进 Skynet.init 包裹的匿名函数中运行
对于启动时就需要读配置表的文件 foobar 而言,require 了 sharedata 的 API 并不代表就可以直接使用了(可能还没跑 skynet.init 中的函数)因此,必须将 require foobar 的初始化流程也包在 skynet.init 中,同时保证先调用到 sharedata 服务 API 的 skynet.init,再调用到 foobar 的 skynet.init,这样最后跑 skynet.init 函数链的顺序才是正确的
新版本用 Lua 版本的 skynet.require 替换了 require, 从而允许在 require 过程中也可以发起 call 了。严格来说,是在官方 require 后,再由 lua 层跑完 skynet.init 里的函数链,再返回原有 require 的流程继续执行。这样,用到 require sharedata API 的逻辑,在跑完 require 后,得到的就是一个可用的 API 了,不再需要自己控制 skynet.init 来保证顺序的正确性了
再次感谢涛神的分享哇 XDD
29 - Lua54 兼容性
最近在搞迁移,准备将项目依赖的 Lua 5.3 迁移到 5.4 上面去,先翻译一下手册的第八章,强迫自己读完, 原文地址
这里我们列出了从 Lua 5.3 迁移到 Lua 5.4 可能会遇到的兼容性问题
你可以通过设置参数重新编译 Lua(详情参考 luaconf.h),来避免其中的一些兼容性问题。但是,所有兼容选项都会在未来被移除掉。当这些选项被移除时,兼容性问题就会暴露出来。所以,当你有机会的时候,你应该尝试用没打开任何兼容选项的 Lua,来测试你的代码。这样会让迁移到新版本 Lua 的过程变得更容易
Lua 版本间有可能发生 C API 的变更,前提是这些变更不会引起程序源码的改变,比如数值常量或者将函数以宏实现。因此,你永远不应该假设不同 Lua 版本间,二进制是兼容的。使用新版本时谨记重新编译使用 Lua API 的客户端
与之类似的还有预编译代码块,Lua 版本间可以改变预编译代码块的内部表示方式;预编译代码块在不同 Lua 版本间不兼容
官方发布的标准路径,在不同版本间也有可能改变
8.1 语言上的不兼容性
- 字符串到数字的强转,在算术运算和位运算中被移除出核心语言了。string 库通过字符串元方法,为算术运算提供了类似的操作(但不支持位运算)然而,与之前版本不同,新的实现保留了字符串中隐含的数字类型。比方说,“1” + “2” 的结果现在是整型而非浮点了
- 溢出的文本化的十进制整数常量,现在会按浮点处理,而不是回绕。如果你需要回绕,可以使用 16 进制来表示这些常量(这样就会将他们用做整型)
- 移除了使用 __lt 元方法来模拟 __le 的行为。需要 __le 时,必须显式声明 __le 方法
- 整数 for 循环的语义有细节上的改动,控制变量永远不会回绕了
- goto 语句的标签不能在同一可见域内定义两次,即使其中一个标签是在一个封闭语句块内
- 当回收一个对象的时候,Lua 不会忽略不是函数的 __gc 元方法。只要存在 __gc,无论 __gc 是何值均会被调用(不能调用的值会产生一个警告信息,正如调用析构函数时产生的其他错误一样)
8.2 库的不兼容性
- print 函数不再调用 tostring 方法来格式化参数了;而是硬编码了这个功能。你应该用 __tostring 来定义如何格式化这个值
- math.random 使用的伪随机数生成器,现在改用了一定程度上随机的种子,也使用了另一个随机算法
- utf8 库的解码函数默认代理值(surrogate)为非法代码数。这些函数有一个额外参数,可以让其变得对代理值更宽容
- collectgarbage 的 setpause 和 setstepmul 选项被废弃了。你需要用新的 incremental 选项来设置它们
- io.lines 函数现在返回 4 个值而不是 1 个值了。当 io.lines 用于其他单参数函数时就会出错,比如 load(io.lines(filename, “L”))。可以将调用藏进括号里来调整返回值的数量
8.3 API 的不兼容性
- 完整的 userdata 现在可以有任意数量的 user value 了。因此,lua_newuserdata, lua_setuservalue, lua_getuservalue 将被 lua_newuserdatauv, lua_setiuservalue 和 lua_getiuservalue 取代,他们有一个额外的参数。出于兼容性的目的,老的名字可以宏的形式继续工作,默认只处理一个 user value。注意,新的 API 下不含 user value 的 userdata 会更节省内存
- lua_resume 有一个额外参数。这个参数返回协程压栈了多少个值。(在之前的版本里,这里是栈上所有的值)
- lua_version函数现在直接返回一个版本数字,而不是版本数字的地址了。带有静态链接Lua核心副本的库应该能和Lua核心正常工作,没有必要确认他们是在同一个地址空间
- LUA_ERRGCMM常量被移除。析构器里的错误永远不会被传播;他们只会产生一个警告信息
- lua_gc函数的LUA_GCSETPAUSE和LUA_GCSETSTEPMUL选项被废弃了。你应该使用新的LUA_GCINC来设置他们
30 - 一些吐槽
感觉被周六加班榨干了,累的不想写博客。非常佩服其他同事,996 还看不出来有啥异样的,太强了。。3 月 4 月连续加班后,5 月终于可以放松一下,不用加班了。五一假期陪老婆回了老家,过了愉快的 5 天,后面补班就非常累了。。。
上月月底请新同学帮忙做了一次压测,发现了一处内存泄漏。我们战斗部分的代码是仿照 ECS 的方式写的,按帧驱动系统更新,但是怪物死亡的时候没处理好,AI 停止后有可能又重新加上 tag,导致场景里只有几百个怪,实际却有几千个 AI 在跑。用 CPU 火焰图看就是 AI 部分占用的 CPU 过多,但是触发 AI 的根源都是正常代码,没发现问题,还是最后靠 Code Review 发现的
搞完这个问题后,我们将压测机器人的数量上调了一下,单独针对移动压测了一轮,结果又爆了。吸取了之前项目的经验,这次已经将 AOI 相关的逻辑都抽离出一个独立服务进行处理了,但是压测发现这个服务还是过载了,CPU 到 98%,下游的 cluster sender 之类的分发服务也是顶不住了。起初我觉得是临时消息太多,透过内存火焰图,发现了一处分配大量临时内存的代码,新同学做了池化处理,元表也改为只用一个了,但是性能还是不够。后面做了合包处理,原来的设计里,一个人进入 100 人的视野,会产生 100 条信息,现在将这一百条信息合成一个包,减少链路上的压力,到靠近客户端的终端再做分发处理,终于将性能消耗降下来了
最近还搞了一轮大改造,目标是绝大部分的业务代码都可以热更。战斗系统因为用 ECS 构建,所以更新起来还是很方便的,基本就是替换 table 里的函数就完事了,稍微有点复杂的是面向玩家的 agent 服务,需要改造下事件和计时器相关的逻辑。上次 内部月刊分享的那篇文章 对我们触动很大,我们自己用 skynet 开发了这么久,居然一直没搞开发期热更,实在是难以启齿的笨。。。
期间压测还测出了一些和中间件组磨合的问题,压测的时候日志级别忘记调整了,结果写满了磁盘后,中间件组提供的容器直接挂了,也没收到相关告警,囧 rz 我们团队还缺乏动态扩容的经验,不知道以后能不能给中间件组提供自定义策略,适时启动更多节点去缓解高峰期压力
31 - 技能系统
技能系统的功能在于管理能不能打,能打谁,能打多远,打多少目标,以什么方式打这些关键问题。作为战斗系统的中枢,技能系统充当着胶水层,粘合了外围的 AOI、属性计算、碰撞检测、子弹、buff、ai 等系统。从使用者的角度看,技能分为怪物技能和人物技能两部分,下面主要讲讲人物技能
技能系统决定技能能不能打,这里有两个方面,一是从各种成长系统过来的技能,经过整合计算,得到战场上可用的技能列表,再加上战场本身给的技能,决定了玩家能放什么技能;二是技能的当前状态,是否处于 cd 中,包括 gcd、技能本身 cd、同类技能的 cd 等配置限制,从时间维度上控制了战斗的节奏
能打多远,是技能本身的施法距离判断,用于控制战斗场面的大小,配合移动速度和视角,影响着战斗规模和节奏。能打的前提是能看见攻击目标,所以一定程度上还受到战斗场景 AOI 范围的限制
能打谁,是说技能对目标的筛选作用,当前技能是治疗还是攻击,涉及的是目标阵营的筛选;特殊技能只能针对特定怪物,则是目标类型筛选。这些条件更多是起到过滤器的作用,过滤掉不想要的攻击对象。结合攻击数量的限制,就会引起一个潜在的问题:该技能只能打 10 个目标,根据技能的作用范围,圈出来 10 个目标,结果筛选后都不能打,导致技能落空。但是,说不定该区域人数特别多,只不过前面限制了数量,导致其他潜在符合条件的对象被过滤掉了
在上一个项目中,采用了放宽数量限制的做法,比如数量上限放大 3 倍,如果这里面都没有符合条件的,就直接忽略了,简单粗暴,但大多数战斗都是 5v5 的小规模作战,野外基本没有战斗,这么做没有问题。对于现在的项目,策划希望做大战斗场面,一部分野外也放开战斗,原有的做法就显得有点粗糙了。目前,通过将丰富的角色数据下沉到底层碰撞检测,我们实现了较为多样的条件查询,现在不仅是搜指定点附近的 n 个目标,还能搜索指定点附近的友军,碰撞类型是怪物,从而简化掉 Lua 层的过滤,提升了速度,也解决了漏目标的问题。这种做法的挑战在于往后会添加更多的查询,能不能全部放在底层实现,会是一个巨大的挑战
技能系统的核心部分是时间线,时间线类似于技能动作编辑器,安排了技能时间内以特定顺序实现各色技能效果。时间线的最小单位是一个功能单元,比如上 buff、召唤子弹、放嘲讽、单体攻击、放治疗等。实际配置时,使用的是单元的实例,固化了一组单元所用的参数,可以通过复用单元实例减少技能的配置量
时间线的另一个作用,则是配合客户端的技能效果展现。服务器出于性能考虑,技能组件的 update 频率是大大低于客户端的,如何配合这两套不同节奏的离散事件系统,实现较好的技能效果和打击手感,是需要策划同学花点心思的。一般的原则是服务器先行,客户端按美术表现来播放相应效果。其中比较难搞的是子弹攻击与飘字,服务器没有实际计算客户端子弹的飞行轨迹,也没法做到客户端播完子弹打击特效后,刚好塞一个扣血协议到客户端进行飘字。为了实现子弹打击效果和飘字的配合,服务器侧会先行计算,将飘字提前发到客户端进行缓存,客户端依次播放即可
一般技能的持续时间都比较短,为了实现更长的状态效果,便引入 buff 来处理状态间的互斥、顶替、叠加。状态类的效果包含了属性效果的加成削弱,也包括了眩晕等禁制效果,还有一些诸如吸附、击退等强制移动的效果,也有纯展示用,给客户端标记两个特定对象,以方便客户端做效果的。总的方向是 buff 只管理 buff 间的顶替规则,在创建、销毁等时机发事件,具体效果应该交由其他模块实现,目前并没有很好的做到这一点
除了人物技能外,还有怪物技能。由于人物技能策划和怪物技能策划希望实现的效果差别比较大,怪物技能用到的技能部分比较少,相当于一个阉割版的技能系统,只负责其中造成伤害的部分。技能释放的校验函数需要跳过,技能的前摇(预警)特效也要根据 AI 逻辑做差异化,所以这里技能系统只是充当着战斗公式模块的一个基石,提供一下属性对抗的数据而已。以后做更复杂的技能对抗,可能会有坑,比如之前做的技能打断,就需要怪物技能将前摇后摇都塞回技能里,不然连 AI 都需要处理技能打断效果了
32 - Pixel 刷入 Android10
2021 年 6 月 1 日后,Google 相册的高画质存储也会算入存储空间,Pixel 手机除外 ,趁着优惠入手 Pixel 来薅羊毛 :) 机器到手后刷下官方系统
- 开机后点击设置 - 关于手机 - 版本号,点击 7 次后打开开发者选项,点击系统 - 高级 - 开发者选项,打开 usb 调试和 OEM 解锁
- 从官方网站下载镜像:marlin ( 选最新的)
- 从官方网站下载 platform-tools:https://dl.google.com/android/repository/platform-tools_r30.0.5-linux.zip
- 解压 platform-tools:
unzip platform-tools_r30.0.5-linux.zip - 进入 platform-tools 目录,插入数据线,检查是否连接正常:
adb devices这里应该能看到手机 ( 注意检查数据线,有些线只能用来充电 ) - 进入 bootloader:
adb reboot bootloader - 解锁 bootloader:
sudo fastboot flashing unlock - 将镜像解压到 platform-tools 目录,将 flash-all.sh 中的 fastboot 改为 ./fastboot,执行
sudo ./flash-all.sh
33 - opencv 学习
最近换了新机器,在打游戏之余顺便用来学习一下 OpenCV,好好享用算力 :) 仓库在这里 目前写了个例子,用 OpenCV 官方提供的人脸识别模型,利用 usb 摄像头做人脸识别,还是蛮好玩的
34 - 新年快乐 2021
没想到疫情期间在家办公,从心率上看是最好的一个月了,祝各位身体健康,万事胜意。最近用到 gost 作 DNS 代理,相当趁手,还能各种转发,对于 gem install 这种 proxychains 搞不定的,配合上 export http_proxy 还是挺好用的
最近喜欢上 QRCP 这个小工具,既可以当普通的 http 文件服务器,作简单的上传下载之用,又可以分享文本,比手机、电脑都装 IM,然后在里面发来发去的好。我在 自己 fork 的分支里 还提供了反向扫码打开的功能,手机扫码后将链接贴上去,然后在电脑打开,方便在电脑看长文章,不过作者不想合进去,觉得用 shell 脚本就可以搞定了
35 - goroutine 数据竞态
最近写了个 小玩具 ,用来去掉 goscon 相关的握手细节,这样压测程序可以透明的连接游戏服务器了。单连接测试的时候没问题,但是当连接数上去后,会出现莫名其妙的数据解析错误。感觉是出现了竞态条件了,于是用 go build -race 来重新构建,再测试的时候就有异常栈抛出可供分析了,还是蛮方便的
贴一段报错的堆栈:
先看修复前的代码:
golang 的 data race 检测提示 77 行的 scon.Read 与 112 行的 conn.Write 有竞态,112 行正在读的时候,77 行写了,导致数据异常。想了一会终于想明白了。。。82 行的赋值并没有拷贝过程,只是创建了一个 Slice,这个 Slice 指向 scp_buf 这个字节数组。当 writePipe 从 writeCh 中读出 data 后,75 行的 go 协程就能继续跑了,于是 scon.Read 继续修改 scp_buf,而 conn.Write 在读指向 scp_buf 的 data,导致数据异常。
针对这种情况,大致想到3种解决办法:
- 可以对 scp_buf 加读写锁
- 可以多复制一份 data 数据出来,供
writePipe读 - 或者通过 Ring 环形链表来实现两个 buf 替换,
scon.Read写其中一个的时候,writePipe读另外一个,Ring 的大小就是缓冲区的大小,从 goscon 读和写入客户端的速度相差较大的话,可以多搞点缓冲区
目前采取的是方案2来解决,GC压力可能会比较大,到时候再酌情更换方案3或者方案1
36 - [译]Redis 探险之旅的结束
本文是[Redis开发者@antirez引退](http://antirez.com/news/133) 一文的翻译
10 年前,当我创立 Redis 项目的时候,我正处在职业生涯中最兴奋的时刻。我的联合创始人和我一起,成功的上线了两个主要提供 Web 2.0 服务的意大利语网站。为了让他们变得可扩展,我们需要发明很多新概念,其中大多数是计算机领域里已经探索过的,但我们并不清楚,我们也不着意检查。有问题?那就找一个解决方案。我们虽然想解决问题,但我们更想拥有乐趣。这是 Redis 诞生时充满可玩性的环境
令人难以致信的是,现在 Redis 已经是很多东西的主要部件。年复一年,我的工作已经从构建 Redis,变成了让它尽可能有用和可靠。最近这些年,我每天的注意力已经花在阅读其他开发者的报告,关于 Redis 的代码,关于如何优化,如何让 Redis 跑得更快、更安全、更正确。但是,我从来没想坐一个软件维护者
我写代码的初衷是表达我自己,我认为我写的代码是一件艺术品,而不是单纯的工具。我认为写出来的东西刚好有用,只是一个副作用。我的第一目标是创造一些美的艺术品。本质上,我情愿人们记住我是个蹩脚的艺术家,而不是一个优秀的程序员。现在,这个如此重要的项目所创造的氛围,驱使我抑制表达自我,更多的维护项目。这的确是 Redis 现在所需要的,但这不是我想要的,过去这些年,我已经勉强够了
所以,亲爱的 Redis 社区,今天我会从 Redis 维护者的位置上退下来。我的新位置将会是 Redis 实验室的一个理想化人物,为了提供新的 Redis 的可能性,我会继续保留 Redis 实验室咨询委员会的位置。另一方面,我可以腾出手来,干点别的,可以是写代码或者不写代码的,谁知道呢,我现在不想做计划。但是我严重怀疑我将来会完全不写代码,毕竟这实在太有趣了 :D
我将 Redis 交到 Redis 社区的手上了。我请我的同事 Yossi Gottlieb 和 Oran Agra 从今天起继续维护项目:他们是近些年来对我帮助最大的,而且尽了很大的努力,去遵循我非常主观的看法,我对于 Redis 的跳跃性的愿景。因为我不想为新的 Redis 开发模式定型(这是维护任务的核心,也是我尽可能避免的事务),我会让 Yossi 和 Oran 自己去对接其他 Redis 开发者,寻找一个可持续的开发模型,你可以从 这篇博客 直接听到 Yossi 和 Oran 的想法
我相信我不但将 Redis 交到一群资深开发者组成的社区手上,还将 Redis 交托给最关心 Redis 社区精神的人手上。在 11 年里,我希望我能够提供一个观点,一个被特定的人所理解的,关于编写软件的另一条路径的观点。我希望 Redis 的演进能够考虑到这些观点
Redis 是我的职业生涯里压力最大的东西,很有可能也是最重要的。我不太喜欢底层编程世界这些年的变化,但尽管这不是一趟轻松的旅行,我还是拥有了和一众优秀开发者交流和协同工作的特权。感谢你们的宽容和帮助,以及你们所教会我的。这里恕不一一点名。我也向支持 Redis 的公司和公司里的个人致谢,谢谢你们允许我每天写开源软件,持续了这么多年,同时给予我自由,去做我认为对用户有益的事。Redis 实验室,VMware 和 Pivotal,谢谢你们的慷慨和莫大的帮助
正如我所说的,除了参与 Redis 咨询委员会,我并不十分清楚我的将来在哪里。我猜在某些时间里,只是到处看看,不参与太多工作,会是一个不错的想法。我想更多的探索一下我的个人爱好。写博客也是我想做的,但因为时间关系做得越来越少。最近,我发布了意大利语的视频,向公众解释技术概念,我收到不错的反响,也觉得其中有不少乐趣,可能我会更多的干这个。无论如何,我相信你们中的一些人已经知道我在 Twitter 的账号 @antirez 很活跃,如果你们好奇一个又老又古怪的程序员,接下来会干什么,欢迎关注我
37 - skynet.call 调用
上次 写了一篇文章讲 skynet.send,最近想起一个 call 的问题,流程跟 skynet.send 差不多,再记录一下
虽然官方 wiki 并没有记录,但是 skynet.call 一个不存在的服务,并不会报错的,最神奇的是当你真的起了同名的服务,这个服务就真的能收到这条消息。skynet.call 本质上还是 skynet.send,只是 send 完以后将 session 号和 coroutine 记下来,然后自己调用 yield 将控制权交还给 skynet。按上篇文章所述,给一个不以 . 开始的名字发消息,会经过 service_harbor.c 的 remote_send_name 函数。该函数先从 harbor 服务记录的名字哈希表里查找,找不到就新建一个 queue,将消息堆在里面。等同名服务起来后,就可以收到这条消息了
38 - skynet 火焰图的新方法
最近 子熏同学 搞定了新的抓取火焰图的方法,他觉得改动有点多,不方便开源出来,不过我觉得思路很好,写篇文章记录一下
skynet 自带的魔改版 Lua,即使 Lua 代码在死循环,也能通过 gm 指令让 vm 停下来,看看出事的地方是哪里。这是通过引入 lua_checksig_ 来实现的。在 lvm.c 里,重点的几个 OPCODE: OP_JMP, OP_CALL, OP_TAILCALL, OP_FORLOOP 都会调用 lua_checksig 进行检查,如果设置了开关,就会通过 lua_error 中止运行。新的火焰图也是用类似方法实现,当目标服务检测到开关打开,就会将当前栈帧到 base_ci 的部分抓取下来,序列化成文本,放进一个全局指针里。然后另一个服务就会去读这个指针,将数据序列化到文件里,后续用 flamegraph.pl 进行火焰图的渲染
这里目标服务和检测服务之间没有用平常的消息机制进行通讯,因为死循环的时候已经不会再消费消息了。取而代之的是直接改对应 skynet_context(目标服务)的状态开关,当服务运行到检查点,就会自然将自己的栈抓下来,并将状态改成已抓取。待检测服务读取完后,将状态改成未抓取,至此完成一次栈帧捕获。检测服务可以自定义抓取的频率,定期修改目标服务的状态开关即可。这两个服务的通讯有点 golang 的 channel 的意思,相当于一个大小为 1 的 channel,消费者(检测服务)未消费,则生产者(目标服务)处于阻塞状态,不会继续抓取
本来想集成到线上项目里的,可是最近新项目进度比较忙,一直没时间搞。。。子熏的测试是只有 2% 左右的性能损失,非常高效。这种方法不需要以前 systemtap 那种切到内核空间里去,应该是会高效很多的
39 - shadowsocks 重定向攻击
最近看了一篇关于 Shadowsocks 重定向攻击 的论文,觉得很有趣。但是仓库里的 poc 代码没法直接用,自己重新抓了包,结果出了点问题,做了一通宵实验,才折腾出来,写篇博客记录一下
ss 的数据流如上图,ss-local 对浏览器而言,就是一个普通的 socks5 代理。为了简化实现,shadowsocks 协议和 socks5 协议的地址表示方式是一致的,浏览器发给 ss-local 的请求,可以去掉 socks5 协议里的 VER CMD RSV 头三个字节,就直接拿来用。ss-local 收到请求后,直接发起 tcp 链接到 ss-server,包的内容是 [IV][remote_host_addr][payload],这里 [IV] 是 16 个字节长度的随机字符串。接下来的 [remote_host_addr][payload] 是经过加密的,用的是用户自己设定的加密算法和加密密钥。ss-server 收到后,会连接 [remote_host_addr],发送 [payload] 内容。ss-server 的回包结构则是 [IV][payload]
本次 POC 针对的,就是特定的 stream cipher 加密方法,比如 aes-256-cfb 之类的,基本上非 AEAD 系的都会中招。理想状态下,加密后的 [remote_host_addr][payload] 应该极难解密。但是,对于特定的流式加密和特定的数据包,可以通过精心构造的包体,让 ss-server 连接到恶意 [remote_host_addr],发送解密后的 [payload],主动给攻击者解密。流式加密的加解密流程:
假设我们知道明文 p1 是什么,我们就能在不知道 key 的情况下,将 p1 对应的密文 c1,变换成 c1’,同时不破坏后续的解密。形如:
因为 ss 用来上网浏览比较多,我们可以假设抓到的是一个 http 的流。那么服务器的回包内容多半是 HTTP/1.1 开头的。利用这一点,我们可以将服务器的回包 resp 抓下来,稍加修改构造成客户端的请求包 req,发给 ss-server 给我们解密。resp 的结构是 [IV][payload],req 的结构是 [IV][remote_host_addr][payload],我们只要将 resp[16:16+7] 的内容,替换成我们控制的服务器 s1 的 ip 地址,ss-server 就会发起 tcp 链接到 s1,并将解密后的内容发过去
自己做实验的时候,需要将原来仓库里的 attack_with_http_pocket.py 里的 c,换成自己抓的服务器包返回值,然后发给同一个服务器 ( 或者相同密码的服务器 ) 解密,只有知道密码的服务器才能解开包。另外,tcpdump -i lo src port 8080 -X 抓下来的是 ip 包的 hex,还不能直接用,最后用 wireshark 转换了一下才搞定
40 - 二叉平衡树之 AVL 树
最近折腾了一下 AVL 树,留点笔记给未来的自己看看 :)
二叉树是基本的树结构,有左右两个孩子。一般情况下,查找可以做到 O(log n) 的时间复杂度。但是对于极端情况,可能恶化成 O(n),这相当不妙。当输入的数据是线性的,新增的子节点就会都在左子树(递减情况)或者右子树(递增情况)。如下图:
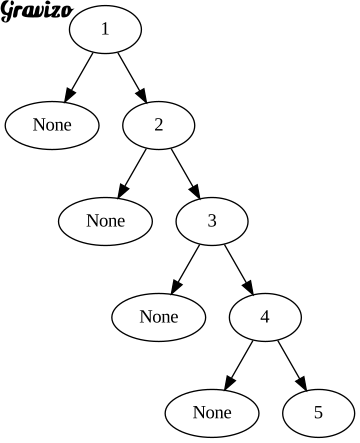
为了让查找继续维持在 O(logn) 的复杂度,我们需要让树长得更平平衡一点。我们先来看看,为了达到不平衡,最少需要几个节点。如果只有两个节点,那无论怎么折腾都一样,谁做根节点都没有区别。所以至少得有 3 个节点,才会出现不平衡的情况。如下图:
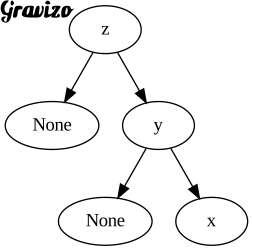
z 的左子树和右子树最大高度差大于 1,视为不平衡。这三个节点里,x 和 y 各有左右两种情况,所以一共是 4 种情况。下面分情况讨论一下。
情况 1:

这种情况相当简单,只要向右顺时针方向旋转一下 y 节点,就能达到一个平衡状态:

注意,旋转完以后,w2 节点还是在 y 节点的右子树,z 节点的左子树,没有破坏二叉搜索树的结构。上述的顺时针操作记为 right rotation
情况 2:

这种情况稍微复杂一点,需要经过两次转换才能变成平衡状态。我们先对 x 做一个 left rotation:

现在看起来跟情况 1 就非常像了,只要再来一次 right rotation 就行了:

情况 3:

是不是和上一种有点镜像的感觉呢?所以也是需要两次旋转操作的,这次反过来,先对 x 做 right rotation:

然后再对 x 做一次 left rotate 就完事了:

情况 4:

最后一种情况其实是情况 1 的镜像,所以只需要一次旋转操作就行了 :

要定位到 z 节点,可以比较插入新节点后,左右子树的高度差,当高度差大于1的时候,说明当前节点就是z。然后根据左右子树的高度,就可以分出来是上述4种情况的哪一种了。还需要注意的,是做旋转操作后,需要更新原来父节点的高度,否则后续的操作会出错
41 - 博客中英文间添加空格
因为新冠病毒肺炎疫情,春节在家待了 11 天了,百无聊赖之下,想着优化一下老博客的排版。准备在中英文间补上空格,显得更美观一点,结果一篇博客都没改完就觉得累死了。。准备写工具来搞
搜了一下有 现成的代码 ,但是依赖 Pelican。作者还提到可以用 MPT 优化,但是我看了一下 MPT 的介绍,是类似前缀树的东西,每次取一个字符分析的话,是不会取到一个串的,前缀树用不上,倒是可以用二叉树简化一下区间查找。于是读完了 GeeksForGeeks 的 interval tree 介绍 ,自己实现了二叉平衡树(AVL),再将 interval tree 的功能加上去,以便快速实现查找。最后去掉了不断 += 字符的操作,用 ''.join 代替,避免频繁的字符串内存拷贝
代码放在 github 上 ,关于 CJK 字符的范围来自 cjk-auto-spacing 的代码,在此致谢。这个命令行工具没有添加遍历目录的功能,只会从命令行参数读入一个文件名,然后添加空格并原地回写文件,建议只用于有版本控制的文档,方便随时回退修改。至于遍历所有文件的功能,可以用 fd 命令实现。比如 :
fd 会启动一个线程池,取出匹配的路径,然后执行指定命令,类似于 GNU Parallel, 速度很快 , 点个赞
42 - skynet 中隐藏的单点服务 : Harbor
昨晚和同事一起看 skynet 的代码,对于 skynet 实现的按名字发送消息比较好奇,走读了一下代码,特意写篇文章记录一下
Skynet 服务间通信,比较常用的是 skynet.send,该接口在 skynet/lualib/skynet.lua 中,实现则是 skynet.core 模块的 send 方法。skynet.core 是 skynet 提供给 lua 的一个 so,代码在 skynet/lualib-src/lua-skynet.c,它用了一个巧妙的注册办法:luaopen_skynet_core,将自己注册成 skynet.core 了。它提供的 send 方法就是 C 代码里的 lsend,也就是 send_message 方法。对于目标服务地址是字符串的,就会用 skynet_sendname 实现发送
skynet/lualib/skynet.lua:skynet.send->skynet/lualib-src/lua-skynet.c:lsend->skynet/lualib-src/lua-skynet.c:send_message
skynet_sendname 是来自于 skynet/skynet-src/skynet_server.c 的核心方法,猜测这里是用到哈希表之类的结构,将名字转换成整型 id 的。仔细看代码,如果字符串开头是 :,那就是约定的 16 进制字符串地址;. 是本节点专用的名字,相当于局部变量,跨节点不可见的,skynet_handle_findname 这个方法就是查找哈希表的,符合预期。至于通用的字符串名字,就走最后一个 else 语句了
可以看到, 这里 构造了一条远程消息,然后以 skynet_harbor_send 丢给 harbor 服务了。该接口在 skynet/skynet-src/skynet_harbor.c,只是转用了 skynet_context_send 以 PTYPE_SYSTEM 的方式发出去而已。这个操作就是往 service_harbor.c 的消息队列里塞了一个消息
service_harbor.c 是一个纯 C 服务,代码在 skynet/service-src/service_harbor.c。处理逻辑都在 mainloop 函数里,对于 PTYPE_SYSTEM 类型的消息,处理如下:
看起来是通过 remote_send_name 做查找了,果然,第一行就是 hash_search 函数。同节点的服务启动时,会调用 cdummy 服务(cluster 组网模式)的 register 接口,最终落到 skynet/service-src/service_harbor.c 的 update_name,将名字注册好,所以 hash_search 就能找到最终服务的地址,以 remote_send_handle 的方式发送出去
目前项目里都是用 cluster 模式组网,跨节点通讯都会丢到 clusterd 再派发到其他服务,远程部分的处理在 cluster 完成,本地部分就用 harbor 了。所以所有用名字做目标地址的调用,还是会经过 harbor 服务做名字转整型地址的操作,这里是一个单点,有可能有性能问题。还是建议各自服务缓存远端的 id 地址,后续发送不再做转换操作了,参见 skynet 的 wiki
43 - git 与 redmine 联动
现在留给开发的提交权限越来越少了,qc 同学为了保证测试覆盖,让搞了个钩子,提交信息里必须写单号,没有 qc 单子的提交会弹钉钉警告,提错版本的也会被警告,心累。最近一周比较闲,决定用 Python 脚本做个类似的检查辅助一下
代码仓库 fix_issue 是用来关单的,redmine 的页面开着,一段时间后做完,手动标记完成时,如果中间有人改动过,就会将其他人的改动冲掉。。用脚本关就只会改状态了。同时,每个单子的完成状态都不一样,对于功能开发的单子,会比 bug 单多几个状态。。。
check_push 是用来做钩子的,用于检查提交的信息里有没有单号,单号的版本对不对。每一次提交如果有单号,都会去 redmine 检查一次(#0 除外)。如果单号对应的版本,和当前提交的分支版本不一致,就会提交失败。最后还利用 difflib 的字符串相似性,从自己的所有单里找一下,看看有没有标题类似,而版本正确的,自动提示正确单号。这样,从主干 git cherry-pick 一个提交过来,即使单号错了,也会被拦下来,提示正确单号,只要动动手 git commit --amend 改掉就行
all_issue 是列出当前指派给自己的所有单号,配合 fix_issue,可以批量关闭 redmine 单,比较好用。例如:
就能批量关单了
最后搞了个 fix_conflict,在大提交 git cherry-pick 以后很容易有冲突,冲突后要手动一个个文件打开,编辑冲突,然后 git add 一下。这个工具可以帮忙自动调 $EDITOR 环境变量来打开冲突文件,最后帮忙 git add。~~ 已知的缺陷是,a 文件在分支 1 还在,但分支 2 删掉了,在分支 2 上 cherry-pick 分支 1 的提交,冲突文件里就会有 delete by us 的冲突,最后导致错误 git add。目前尚未解决 ~~ EDIT: 已解决 spin6lock/git_with_redmine@d1c83b6
博客将评论系统从 Disqus 换成了 utteranc,还是老外的比较注重权限和隐私。国内的类似插件要求评论者给访问权限,还是整个账号的,太危险了。(说的就是 Gitalk)
44 - jemalloc 内存占用问题
最近,有部分越南的服务器内存不断上涨,怀疑是内存泄漏,因为框架提供的内存报告里,C 内存和 Lua 占用内存都不大,和 ps 里看的差好多。总内存在 12G 左右,C 和 Lua 的加起来约 4G,两者相差了 8G
经过一番排查,排除了混用 glibc malloc 和 jemalloc 的可能。于是 写了一个多线程的测试程序 ,由多个生产者 - 消费者线程对组成。生产者分配一个随机大小的内存(在 SIZE 范围内),然后 memset 将内存遍历一次,再将指针通过管道发给消费者。消费者拿到指针后,读一下指针的值,然后释放指针对应内存块。这个模型模拟了 skynet 的一个线程分配内存(消息),发给另一个线程消费(释放)的情况。在没有设置 jemalloc 的参数的情况下,这个例程的内存会逐渐涨到一个峰值,然后不再增大,但也不再减少。如果设定了例程里的 ABORT_COUNT,过了指定次数后不再进行内存分配,内存过几个小时也不会下降,这跟线上的情况类似
通过 MALLOC_CONF 环境变量,设置了 dirty_decay_ms:0,muzzy_decay_ms:0 以后,内存的峰值变低了,观察 top 命令的 RES 内存,明显低了不少。将选项换成了 background_thread:true,则例程即使不再分配内存,内存占用也会逐渐降低了。dirty_decay_ms 表示内存块从 dirty 状态移动到 muzzy 状态的时间,muzzy_decay_ms 是 muzzy 状态到释放给系统的时间。设为 0 以后行为会不一样,比如我两个参数都设置 10000ms,并不是 20 秒后就会还给系统。。
往后打算设置一下 background_thread:true,让内存不再使用时慢慢还给系统,避免 OOM Killer 找上门来杀进程
45 - 罕见的 coredump 了
最近,项目在越南版删档测试的时候,发生了罕见的 coredump,简单记一点排查日志
目前的敏感词过滤是在 C 层做判定的,先后经过几个项目考验,模块算是比较稳定了。越南版有个需求,需要将敏感词里的空格去掉。比如敏感词是 abc,现在不能说 abc 了,但是玩家可以输入 a b c,所以需要过滤掉空格。有同事就对 C 层改了一下,判断 rune 是 32 的时候,就继续判断后续字符,出事的代码大致如下:
这里会跳过 lua_pop 语句,导致之前 lua_rawgeti 的结果残留在栈上。但这个缺陷不会马上让进程挂掉,而是将栈弄坏一点点。我们来看 Lua 的栈定义:
lua_State 的 stack 是一个指针,指向一个动态申请的 TValue 指针数组。这个栈不仅是 lua 和 C 交互的时候,用于双方交换数据;lua 函数调用的时候,也会将函数参数压栈(当然,调用关系不在这个栈上,而是通过 CallInfo 指针组织的双向链表来记录)Lua 默认会给函数初始化 20 个格子,也可以通过 lua_checkstack 函数去增加栈的大小。L->top 指向的是栈上的第一个可用空槽,L->top 在正常使用的时候会小于 L->ci->top,lua 自带有 api_check 来检查。之前为了压榨性能,api_check 也关掉了,所以没检查出 stack overflow。
当一个 C 函数不断往栈上 push 函数,超过栈的大小后,会写坏什么内存就没法确定了。出事的时候,写坏的是另一个协程的 stack,另一个协程正准备 resume 回来,但是栈上存的 ci->func 是 TValue(正数 32),不是一个函数类型,就 coredump 了。
稳妥起见,以后改 C 代码还是走一下 code review 吧,自己也打开 api_check 检查一下。。查这个问题花了很久,还有一个原因是其他同学搞混了线上版本,我看的是有问题的版本,结果另一个分支上的是没问题的版本,以为正式服上跑的是没问题的版本,查了好久。。。
46 - iPhone 惊爆史诗级漏洞?漏洞细节解析
最近 @axi0mX 提到 iOS 有一个不能修复的漏洞,命名 checkm8(读 checkmate),可以击穿 iPhone 4S 到 iPhone X 间的所有 iOS 设备。而且由于这个漏洞存在于只读的 bootrom 中,苹果应该没法通过系统更新来修复掉。他发布这个漏洞是为了让大家可以安全的在最新系统下越狱,这样系统更安全,开发者也有更大的空间。
好奇 看了一眼 GitHub 仓库 ,作者两天前提交了一份
47 - 线程数与游戏卡顿
在某天凌晨,欧美服出现了卡顿,但是服务器的 CPU 并不高,内部服务监控日志来看,是 clusteragent 的 mq overload 了,网卡 IO 从流量上来看,也没达到瓶颈。后来,对方 SA 说是参数配错了,8 核的机器配了 24 线程,改成 8 线程后重启,就不卡顿了。这里排查的时候用到了 tracetag,虽然有点麻烦,还是值得的。
后来,又再一次出现了同样的问题。反复调参后,发现 center 配 4 线程就有问题,配 6 线程就不会卡顿。子熏怀疑是 线程权重设置有问题 ,前面的 -1 都改成 0 就解决了,改成 0 以后即使再配 4 线程,也没有问题了。出问题的代码如下:
这里线程创建的时候,会定义一个权重数组,4 核的时候,相当于每个线程权重都是 -1,权重的用途 可以看这里 :
这里 10 行的 n 表示 mq 的未处理消息条数,n 右移 -1 位就是 0,下面 22 行的 dispatch_message 就只会执行一次。右移 0 位,就表示有多少条消息,就处理多少条消息,右移 1 位,就是只处理(未处理消息条数 /2)这么多。skynet_mq_pop 是说从 mq 里尝试弹消息,成功返回 0,mq 是空则返回 1。如果第一次进入 for 循环,mq 有未处理消息,这时候权重为 0,就会处理当前积压的消息。即使处理过程中来了新的消息,因为第 8 行的代码不会重复跑,所以会归并到下次消息调度来处理。
子熏提到可以将权重改成 -1,0,-1,0 这样排布,目前项目是直接将最低线程数改成 8 来解决的,不用改代码。远期来看,可能引入优先级比较好,高优先级的多处理一下。子熏提的另一个问题值得思考,线程每次处理一个消息,然后切换出去,跟每次处理完当下所有消息,再切换出去,不考虑切换开销的话,工作量是不变的。为什么现在会出现 CPU 不高的情况呢?而且消息处理明显慢了很多
我觉得这从侧面反映了当前的测量体系是有问题的,CPU 不高不能反映游戏就正常运行了。有可能是线程总是在切换 ctx,所以 cache miss 比较高,效率就比较低了。最好是能够搞出来一个工作模型,里面跑的是跟线上业务类似的工作负载,每条消息处理不会太快也不会太慢,然后比较一下处理一条就切换,跟处理完再切换,两种不同调度的吞吐量区别。
参考阅读:
http://www.brendangregg.com/blog/2017-05-09/cpu-utilization-is-wrong.html
CPU Utilization is Wrong 作者认为 CPU 使用率指导意义不大,应该看的是 Instruction Per Cycle,小于 1 的话往往是 memory 限制了 CPU 运行效率。吐槽下 virtualbox,没提供相应的计数器,在 perf 里看不出来。。。
后续
上次子熏提到,如果消息很多处理不过来,CPU 不可能这么低。最后,子熏在卡顿的时候直接用 gdb attach 进去了,发现卡顿的时候在调 poll。捋了一遍代码,结果是连接平台的 mq 用了 block 住线程的 poll 接口,然后最近合服,跑了多条 mq。。。应该一条 mq 注册多个 serverid,而不是每个 serverid 单独起一个服务,每个服务都去连平台 mq 的。
调了权重后能极大改善,是因为 mq 服务卡了几个线程,剩余线程每次只处理一个的话,吞吐量就不够了,换成 0 会改善很多,但是如果 mq 服务更多(合服数量更多),还是会有同样的问题的。
这里用 gdb 有点蛋疼,如果 attach 进去没遇上那个窗口,就比较难看到了。可惜用 systemtap 对系统要求太高了,装完一堆东西,还是这个没有那个没有,没法跑出来看。最后发现 strace 可以看到,strace -k -fp 进程 pid -T -tt -o /tmp/strace.log 可以打出来系统调用,还有每个调用的耗时,-k 可以打调用栈。-k 依赖于 libunwind,我是自己编译后的版本才有的。。
48 - 技能问题引发内存泄漏
最近,在国服上的新职业技能,包含了一个弱点标记技能。玩家用技能打怪的时候,有一定概率给怪挂上弱点,下次攻击时用另一个技能攻击弱点,能爆出更大伤害。弱点的生命周期大约半分钟,过了以后弱点会消失,玩家退出场景后,弱点也会消失。
实现的时候,弱点命中情况记在了受害者身上,同时注册监听了一个玩家死亡事件,方便玩家死亡的时候,清理受害者身上记录的玩家命中弱点信息。但是实现的时候,漏掉了反注册监听事件,导致怪物虽然死亡,但是事件管理器上还一直引用着这个对象,引发内存泄漏。
万幸的是,对于场景服务,之前加上了 skynet.memlimit 的 2G 内存限制。同时,因为同一个场景有多个分线,玩家没法进去的时候,会自己切换到另一个分线继续,所以没酿成重大事故。内存满了的服务,不会再接受 call 请求,所以玩家继续 call 的话,会变成玩家上的 task 堆积
这个问题修了两次才修好,需要引以为戒。第一次修的时候,换了一套事件管理器,以为新的管理器会自动在怪物死亡时,清理它监听的事件。同时,看日志的时候只看到 gc 后内存小了,没有具体打印出怪物的数量来排查,测试的时间也比较短,需要一段时间才能看出来漏没漏的。。第二次添加了反注册监听事件就好了
还有值得改进的,是以后开发这种复杂对象相互引用的,还是能用 id 就用 id,避免错误引用住复杂对象。同时,事件管理器也可以优化一下,a 对象关心 b 对象的事件,当 a 或者 b 死亡的时候,就应该清理注册的 a 关心 b 的事件,避免手残引起内存泄漏。。
49 - PullRequest 找原作者做 review
最近对代码库进行了一次全局替换,改了 150 个左右的文件,发了 PR 后需要找原作者确认一下,于是写了个工具做 git blame, 地址在这里
写完发现一个问题,如果只是新增一个函数,没有调用,是应该不用找原作者的 …… 但是,要识别出新增一个函数,没想象中容易,需要基于 ast 来做 diff,才能发现。也就是说,这个工具对于批量替换的功能,才比较好用,其他改动不太合适,蛋疼
50 - Nginx 超时设定
最近针对公司的 goscon 网关发了一个 PR,新增了握手阶段的超时判定。现在回顾一下 Nginx 的所有超时判定,看看目前还缺少哪些判定
**client_header_timeout (默认 60 秒)**
**client_body_timeout (默认 60 秒)**
**keepalive_timeout (默认 75 秒)**
**lingering_timeout (默认 5 秒)**
**<strong>resolver_timeout (默认 30 秒)**
**send_timeout (默认 60 秒)**
上述参数对应的行为如下:
**client_header_timeout**对应的是客户端发送 http 请求头的行为**client_body_timeout**对应的是客户端发送 http 消息体的行为**keepalive_timeout**对应的是 http 1.1 协议里的保活时长**lingering_timeout**是配合**lingering_close** 使用的,就是说关闭 socket 前,客户端还有数据发给服务器的话,**lingering_close** 用于设定要不要等客户端继续发,<code>**lingering_timeout**决定等多久。这里是一个等待 - 读取 - 抛弃数据的循环,有可能重复多次,但是每次等待都不会超过**lingering_timeout**设定的时长- **
<strong>resolver_timeout**对应的是域名解析的时长 **send_timeout**对应的是发送 http 响应给客户端时的超时。这里对应的是两次写操作之间的时长,经过了**send_timeout** 的时间后,还不能写的话,就关闭连接。
对应到 goscon,目前的超时参数,是 reuseTimeout 和 uploadMaxDelay。reuseTimeout 会在 read/write 操作异常的时候生效,度过 reuseTimeout 时间后,goscon 保持的连接对就会被释放,里面的缓存数据都会丢掉。从行为上看,有点类似 Nginx 的 keepalive_timeout。
uploadMaxDelay 是用在给 socket 设置读超时上的,只要设置了这个参数(和 optUploadMinPacket),每次从 socket 里读数据都会设置一个 deadline。超过 deadline 后,会返回错误。这里漏了一个写的超时,留了个 SetWriteDeadline 的接口,但是没有调用。每次写操作也应该有类似的流程,超过 delay 后 write 就返回 error,Timeout()==True。这个参数类似于 Nginx 的 send_timeout,针对的是两次成功写操作的间隔。缺陷是对方依然可以每次读 1 个字节,然后等满一次 timeout 来占用资源。
这次 goscon 新增的握手阶段的超时(handshakeTimeout),类似于 client_header_timeout+client_body_timeout+send_timeout,包含了服务器对客户端的一次读,对客户端的一次写。之前只要连上 tcp,不进行握手操作,不会有任何超时机制,目前新增的超时可以针对这种情况做处理。
51 - Rust 对协程的思考
最近和同事聊起来,觉得 lua 缺乏编译型语言的类型校验功能,还有变量拼写检查之类的,导致线上总是有低级错误出现。比如最近有一个是变量名拼写少了一个字母,导致某功能没开启;还有一个是变量传参时,之前测试多加了一个参数,测试完成后忘记删了,导致参数顺序不对。之前看过有个 TypeLua,没想到现在已经不怎么维护了,去搞了 Titan-lang,然而 Titan 也是 4 个月没动静了。。。
目前也没想到什么好的解决办法,于是顺带看看 Rust-lang,开阔一下思路。我最佩服 rust 这帮人的,是他们有点壮士断腕的勇气,已经写好的 runtime 和协程,认为和 rust 的定位不妥,就直接砍掉了。 相关的 PR 在这里 ,rfcs 在这里 。rfcs 里面关于协程、线程模型的讨论相当到位,我简要翻译一下,权当记录。以下是译文(节译):
背景:线程 / 任务模型和 I/O
很多语言 / 库会提供任务,任务一般有别于操作系统的原始线程。任务的特性可以按以下几个维度区分:
- 1:1 vs M:N 最根本的问题是一个任务是不是总是对应到一个 OS 级别的线程(1:1 模型),或者是通过用户空间调度器,将任务映射到 worker 线程上(M:N 模型)。有一些内核,比如 Windows,支持用户空间调度的 1:1 模型,结合了这两者的优势。
- - 分段栈(segmented stacks)允许栈随着时间增长,意味着任务可以有自己的栈,而且依然保持轻量。但是,分段栈有 [ 明显的性能问题和复杂度开销 ](https://mail.mozilla.org/pipermail/rust-dev/2013-November/006314.html)。
- 在没有自己的栈的情况下,任务要么无法在工作线程间迁移(例如 Java 框架里的 [fork/join](http://gee.cs.oswego.edu/dl/papers/fj.pdf)),或者只能用 CPS(continuation-passing style)实现,即每个阻塞操作都用一个闭包保存自己的工作状态。(CPS 一般将用到的栈保存在闭包里)好处是这些任务特别轻量,基本只是闭包的开销。
- 在 Rust 的绿色线程模型里,任务是按 M:N 进行调度,有自己的栈。最初,Rust 使用了分段栈,后面改成了预分配的栈,这样 Rust 的绿色线程就不是轻量级的了。对阻塞的操作下文再叙
- 在 Rust 的原始线程模型里,任务是 1:1 的和 OS 线程匹配的。
- 二进制大小。任意二进制文件里都包含了整个 I/O 系统的实现,因为他是 libstd 标准库的一部分。
- 任务局部存储。目前的任务局部存储是可以无缝在原始线程和绿色线程间切换的。但是性能会有影响,即使可以改进,也比直接采用原始的线程局部存储要复杂得多。
- 动态分配和调度。当前的设计下,所有 I/O 操作都需要动态调度,大部分的内存分配操作也是。但是,绝大部分情况下,
Rust 的现状
Rust 从绿色线程模型(即协程模型)转向了原始线程模型:
(节略)
问题
强制的共同演进:绿色线程模型和原始线程模型必须提供相同的 I/O 接口,但是有部分接口只会在其中一种模型里有效。比如,轻量级
开销:目前的 Rust 模型允许运行时将绿色线程模型和原始线程模型混合使用。但是实现上有如下缺点:
问题重重的 I/O 交互:
嵌入式的 Rust:
维护困难:
52 - Python 的定时执行
最近手把手教妹子写 Python,被一篇博客误导了,这里记录一下。
妹子需要的是一个定时闹钟,到点往钉钉群里推个消息。她一顿搜索猛如虎,参照着其他人的博客,搞了一个 while:
这种没啥技术含量的代码,居然有人堂而皇之写在博客里,简直是误导嘛。。。跑起来以后 CPU 一个核就在空跑,等着时间到了,跟 睡眠排序 的 xx 程度可以一拼
于是先让妹子搞好发钉钉的代码,封装一个给文本就能推钉钉机器人的小函数出来:
接下来就是定时器的部分,之前我是想着给她开一个 Linux 用户,然后用 crontab 跑。后来发现 Python 有个模块 sched,可以定时执行,示例代码:
这里调了:sched.scheduler、s.enter、s.run 三个方法。第一个方法是创建一个调度器,采用 time.sleep 阻塞等待,time.time 返回当前时间。s.enter 是插入定时执行事件,第一个参数是需要等待的时间,第二个参数是优先级,时间相同按优先级执行,第三个是需要执行的函数 action,后面的参数是传给 action 的参数。第三个 s.run 是执行阻塞,等待事件执行
最后,只要结合 time.mktime 来算下目标时间的时间戳,然后和当前时间相减算下等待时间,交给 sched 去执行就行了 😄 如果需要循环执行,可以考虑用 schedule 这个第三方库,语法比较友好
53 - Mesh 内存分配器的 mmap 小技巧
最近看了 一篇内存分配器的论文 ,原理很简单,但是里面的数学论证还没看懂,这次先简单写一下原理和用到的 API。
内存分配器是用于封装操作系统提供的底层 API,给应用程序提供动态内存的。内存不断申请释放后,往往会形成内存碎片。当需要申请一段较大的内存时,当前剩余内存总量是够的,但是被当前申请的内存块隔断成一个个小隔间,内存分配器无法给出指定长度的内存。这时就只能向操作系统重新申请,或者对应用程序返回分配失败了。
 ( 图片来自这里 )
如上图所示,不断申请内存后,内存占用如 Figure 2 所示。应用程序释放部分内存后,形成 Figure 3。前面的两个空闲内存块,就只能用来放小的内存对象了。即使总内存足够,也因为中间内存对象的隔断,无法分配出足够大的内存。
为了避免内存碎片增多,Mesh 提出了内存页合并的想法。在现代的 Linux 系统上,内存页一般以 4K 大小分配,假设页 A 有碎片,页 B 也有碎片,但是页 A 和页 B 的碎片相对于页头的偏移刚好不重叠,那就可以将两者合成一页,腾出完整的一页来分配较大的内存。见下图:
 (图来自论文)
这种合并的方法有一个问题,c/c++ 的应用程序可能直接存下了对象的地址,所以内存合并后,原有分配对象的地址不能变。作者用了一个巧妙的方法来解决这个问题:
作者用内存文件系统创建了一个内存文件(mkstemp)
通过 mmap api 创建一个 1:1 的内存映射,将第一步的文件映射为一块内存(mmap,这里需要设为 MAP_SHARED, 如果设为 MAP_PRIVATE 则重映射后 B 页内容会丢掉)
假设算法发现有 A 和 B 两页内存可进行合并,则将 B 中存的对象用 memcpy 拷贝到 A 里去(memcpy 或者普通的赋值操作)
通过 mmap api 将 B 页重新映射到 A 页对应的文件偏移上(mmap,这里需要设为 MAP_FIXED,表示新的内存映射就用这个地址开始)
这样应用程序依然可以通过原有的内存地址访问原有的内存对象,而对象实际上已经移动到新的位置了。
上面的步骤 我做了个小实验 验证了一下,的确可行。作者论文里提到修改页表来完成,之前纠结了很久为什么应用程序可以改页表,不是操作系统维护页表的吗?可以改页表不就可以碰物理内存了?才知道原来 mmap 可以这样玩 233333
54 - 尝鲜 svnup
最近有同事折腾了一下 svnup 的编译,终于可以在 Mac OS X 和 Linux 上面编译通过了, 仓库在这里:https://github.com/lvzixun/svnup/
看 subversion 的代码,他是封装了一个 libsvn_client 的库来做实际逻辑的。update 的时候一个一个请求的发,是因为有可能需要处理冲突的情况,一个一个处理冲突,对于 frontend 来说比较简单吧
所以 svnup 其实相当于一个爬虫,根据版本号直接批量将文件下载下来,不管本地文件有没有修改,有没有冲突,直接统统覆盖掉建议慎用 :)
55 - HTTPPostmultipartform-data 支持
最近需要向平台发送录像文件,但是 Skynet 没有 multipart/form-data 的 Post 请求支持,写篇 blog 记录一下
所以只能有最原始的 httpc.request 方法了。请求头比较灵活,可以自己设置为 Content-type: multipart/form-data; 除了这个,还需要设置一个 boundary,用来分割需要同时上传多个 field 的情况。每个 field 长这样:
其中 ————————–d74496d66958873e 这个就是 boundary,最后会加上 – 表示结束。
特别鸣谢 cURL 的文档:https://ec.haxx.se/http-multipart.html,里面写的非常详细。还提到了一个 Expect 参数,让服务器可以用 100 continue 来让客户端继续传,如果因为身份认证等问题出错,可以直接返回错误码,中断客户端上传,避免上传了一大堆然后发现没权限的浪费。
对于多个 field 的编码,可以用这个库:https://github.com/Kong/lua-multipart,会帮你将 body 编码好
56 - MongoDB 慢查询性能分析
57 - redis 的 LRU 算法(二)
前文再续,书接上一回 。上次讲到 redis 的 LRU 算法,文章实在精妙,最近可能有机会用到其中的技巧,顺便将下半部翻译出来,实现的时候参考下。
搏击俱乐部的第一法则:用裸眼观测你的算法
Redis2.8 的 LRU 实现已经上线了,在不同的负载环境下经过测试,用户没有抱怨 Redis 的清理机制。为了继续改进,我希望能观察到算法的性能,同时不会浪费大量 CPU,不增加 1 比特空间占用。
我设计了一个测试用例。导入指定数量的 key,然后顺序访问他们,好让他们的最近访问时间顺序递减。再添加 50% 的 key,那么之前的 key 有 50% 就会被淘汰掉。理想情况下,被淘汰的应该是前 50% 的。如下图:
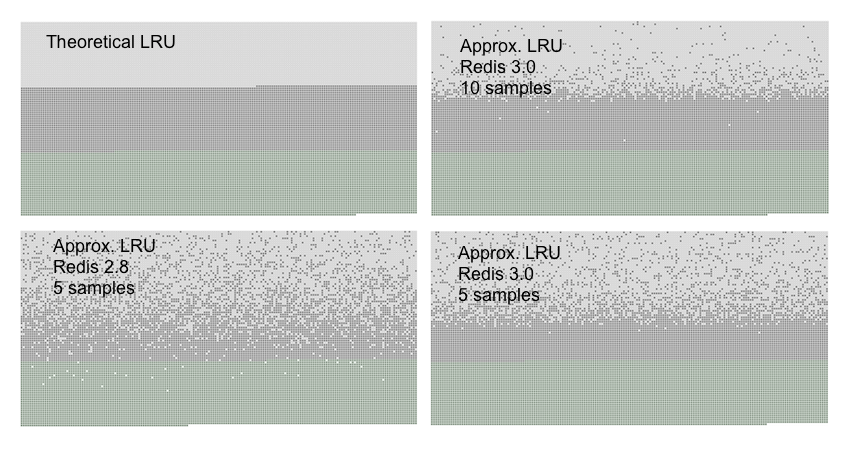
绿色的是新添加的 key,灰色的是第一次添加的 key,白色表示被移除的。
LRU v2:不要丢掉重要信息
当采用了 N-key 取样时,默认会建立 16 个 key 的池,将里面的 key 按空闲时间排序。新 key 只会在池不满或者空闲时间大于池里最小的,才能进池。
这个实现极大的提升了性能,实现又简单,没有大 bug。只要一点点性能监控和一些 memmove() 就完成了。
同时,新的 redis-cli 模式(-lru-test)支持测试 LRU 精度,可以更接近真实的负载来看新算法的工况,尝试不同算法的时候,至少可以发现明显的速度退化。
最近最少访问(LFU)
我最近又部分重构了 Redis cache 的换页算法。这些工作源于一个 issue:当你在 Redis 3.2 有多个数据库的时候,算法总是做局部选择。比如 DB 0 的所有 key 都用的很频繁,DB 1 的所有 key 都用的很少。Redis 会从每个 DB 里丢弃一个 key。理性的选择应该是先丢弃 DB 1 的 key,丢完以后再丢 DB 0 的
Redis 用作 cache 的时候,通常不会跟不同 DB 混合用,但我还是开始着手改进,最后将 db 的 id 包括在池里,然后所有 DB 都共用一个池,这个实现比原始先快 20%
这次改进激起了我对 Redis 这块子系统的好奇心。我花了好些天进行优化,如果我用一个大点的池子,会好点吗?如果选择 key 的时候考虑了流逝的时间,效果会不会更好?
最后,我终于明白到,LRU 算法会受到取样数量限制,只要数量足够,效果就很好,很难再改进。正如上图所示,每次取样 10 个键,已经和理论上的 LRU 几乎一样准确了。
因为原始算法难以改进,我开始想其他办法。回顾前文,其实我们真正想要的,是保留未来最有可能访问的 key,即是最常访问的 key,而不是最新访问的 key。这就是 LFU 算法。理论上 LFU 的实现很简单,只要给每个 key 挂一个计数器,我们就可以知道给定的 key 是不是比另一个 key 访问更多了。
当然,LFU 的实现上有几个通用的难点:
LFU 里没法使用链表法转移到头部的技巧了。因为完美 LFU 需要 key 严格按访问量排序。当访问量一致时,排序算法可能劣化为 O(N),即使计数器只变了一点点
LFU 没法简单的只在访问时对计数器加一。因为访问模式会随着时间发生变化,所以一个高分的 key 需要随着时间流逝而分数递减。
在 Redis 里第一个问题不是问题,我们可以沿用 LRU 的随机取样方法。第二个问题仍然存在,我们需要一个方法来递减分数,或者随着时间流逝将计数器折半。
24bit 空间实现的 LFU
在 Redis 里,我们可以用的就是 LRU 的 24bit 空间,需要一些奇技淫巧来实现。
在 24bit 空间里,需要塞下:
某种类型的访问计数器
足够的信息来决定何时折半计数器
我的解决方案如下:
8bit 用来计数,16bit 用来记录上次递减的时间
你可能会认为,8bit 计数器很快就会溢出了吧?这就是技巧所在:我用的是对数计数器。具体代码如下:
计数器的值越大,真正加一的概率越小。上述代码算出一个概率 p,介乎 0 到 1 之间,计数器越大,p 越小。然后生成 0-1 之间的随机数 r,只有 r<p 的时候,计数器才会加一。
现在我们来看看计数器折半的问题。转成分钟为单位的 unix 时间,低 16 位会存在上面保留的 16 位空间内。当 Redis 进行随机取样,扫描 key 空间的时候,所有遇到的 key 都会被检查是否应该递减。如果上次递减实在 N 分钟之前(N 是可配置的),并且计数器的值是高分值,那计数器就会被折半。如果计数器是低分值,则只会递减。(希望我们可以更好的分辨少访问量的 key,因为我们的计数器精度比较低)
还有一个问题,新的 key 需要一个生存的机会。Redis 里新 key 会从 5 分开始。上面的递减算法已经考虑到这个分数,如果 key 分数低于 5 分,更容易被丢弃(一般是长时间没访问的非活跃 key)。
58 - Skynet 服务热点火焰图分析
最近花了一周时间对场景服务进行热点分析,利用 以前的火焰图工具 做了一点微小的贡献,分享下心得(仓库地址在 https://github.com/spin6lock/skynet_systemtap_set)。
Skynet 是一个轻量级的多线程在线游戏框架 。线程作为 worker,从服务的队列中抽出有消息的,然后处理上面的消息。服务间通过发消息来相互通信。目前服务主要是用 Lua 进行编写。
以前做的火焰图工具,没法单独看一个 skynet 服务的堆栈,只能看到整个进程的。要想针对单个服务做优化分析,需要抓出 skynet_context 的地址,才能取到服务的 id。一个服务对应的是一个 Lua VM,在这个 VM 里,snlua.so 会悄悄的将 skynet_context 地址塞进去 REGISTRY。那么,我们只要将 skynet_context 取出来,然后判断 skynet_context->handle 即可。这看似简单的东西,在 C 里就一句话:
但是,翻译成 stap 脚本后,就变成了:
感谢 gcc -E,帮我展开了一重重的宏
这个过程无比蛋疼,要将 C 翻译成 stp 脚本。stp 可以保护新手,避免搞挂内核,但是随之而来的就是晦涩的指针运算魔法了。接下来打算试试用 bcc 写了
Anyway,折腾出来一个火焰图:

火焰图取材于在内核取样的数据点,纵向切一刀,表示当前时刻的 lua 栈。横向表示统计时间内,各个栈帧的占比。横向越长,时间越长。纵向越深,调用越深。颜色没有关系,可以忽略
可以看到里面有个堆栈很高,说明调用深度很深,另外宽度也很大,说明调用频次占比高。后来定位了一下这个函数,发现是多调了一次 aoi 同步

优化后栈的深度变浅了,剩下的基本是压测脚本跑的内容了。栈深度还能优化一下,到 C 函数的调用层次不宜过多。
好了,睡觉了
59 - 内存爆灯
最近产品在韩国上线了,上线后的第一个周末,人数最多的一服内存爆了,被 OOM 杀掉宕机了,很郁闷
机器用的 4 核 16G,aws 的实例。周四开服后,每天零点左右的在线人数峰值,内存都超过了 80% 的告警线。但是运营方不希望停机,于是采取了定时通过 GM 指令调用 gc,15 分钟回收一次内存,希望撑过峰值。到了周六晚,白天加班回到家,有点松懈了,就没再盯着内存曲线看,结果一不留神就爆了。。。峰值从 78% 飙升到 91%,只用了 7 分钟,定时 gc 没赶上,就这样挂了
按之前内网的压测结果,支撑 3300 人同时在线是没问题的。现在回头看,这个性能指标没有考虑到玩家获得大量武将、装备的情况。初级玩家 3300 人是没问题的,但是上升到一定级别的玩家,就不好说了。国服上线没有问题,是因为国服求稳,开服前先将内存升到 32G,一周后再降配,外服直接上 16G,是有点大意了。
另一个是代码的问题。之前有几个服务用于缓存角色数据,避免重复从数据库里存取。后来分析了一下,这个缓存实在没什么用,玩家角色基本只会上线时自己读一次,以后写数据也是直写到数据库里的。还有一个比较意外的,是有个服务需要读玩家的基本角色信息,以及封禁信息。但是,当时写的同事大意了,直接将整个玩家数据查了出来,还缓存在服务里了。这两块优化了以后,实测内存降了几 G

然后是 GC 的问题。Lua 5.3 取消了分代 GC,要等 lua vm 遍历完所有对象后,才开始释放。当对象的数量特别多的时候,gc 就需要比较长的时间来 mark 完。另外,Lua 的 GC 感觉比较惰性,看了下 lvm.c 的代码,在新建 table、concat 一个 table、创建一个闭包的时候,才会跑一个 step。至于跑多少个 step 可以完成一次完整的 gc 呢?不确定然后有两个服务,占用内存比较多,也没有显式的调 gc,所以回收比较慢。
除了 GC,按 Skynet 社区的经验贴 ,jemalloc 的参数也可以调优下,增加后台进程,积极回收没使用的内存。同时,释放的内存和分配后剩余的内存,都改成立即回收。
60 - 时区问题
最近,游戏要上国外运营了,搞完就算告一段落了放下种种不舍,搞好时区的问题,好好的送它一程吧
受时区影响的问题主要分两类,一类是运营活动,一类是特殊玩法的开启。每天定时刷新的本来就有考虑时区,略过不表
运营活动设计的时候已经考虑到时区,每个活动设计的时候,都需要填写活动开启的日期、时间及时区,这方面问题简化了很多。中间需要修改的,是偶尔有几个活动自作聪明,没有用库提供的日期计算函数,自己拿秒数来算。换上考虑时区的函数之后,就没有问题了。核心代码如下:
其他特殊玩法设计的时候没有让策划考虑时区的配置,而是一刀切,一切按导表的时区来。策划填的年月日 - 时分秒,最后导出的是一个 UTC 的时间戳,这个是按导表时机器所在的时区来转换的。因为同一个打包环境,要打出国内外的包,所以稍微需要做点修改。这里有个讨巧的办法,lua 没有 API 可以取出系统时区,但是 os.date 通过传递不同参数,可以获得 UTC 时间和本地时间。这样就可以间接得到打包机的时区,再加上到目标时区的偏移就行了,核心代码如下:
61 - 与机器共生
最近写代码比较少,干脆分享一点八卦,博诸君一笑 :)
几年前,在 GitHub 上建了几个 golang 的项目,主要是练手用的,也没几个人关注。最近几天,忽然几个仓库同时收到 PR, 类似这样的 ,大意就是对仓库跑了下 gofmt,其他别的都没干,请合并修改。然后在 issue 里写明了项目的地址,原来还是用 golang 写爬虫做的。自动用 GitHub 的 API 爬取 golang 的仓库,clone 到本地,跑完 gofmt 后,看看有没有修改,有修改就提交 PR。
当时有点郁闷,仿佛多年黑历史被挖出来了 :( 但是 golang 的规范就是建议用 gofmt 的,这样大家写的代码风格一致,不用再为风格吵架,节省时间,方便阅读。于是除了一个仓库外,其他都默默合并了。去爬虫仓库里看了一下,居然没有任何 issue,看来还是新项目,立马给他 贡献了第一个 issue。作者回复说会检查是否已经有 PR 了的,会考虑到 open 和 close 了的 PR,不会反复提。还提到了爬虫里比较智能的地方,如果仓库里任何地方有提到 ROBOTS NOT WELCOME,或者 NO ROBOTS,就会自动忽略掉,这些关键词可以商量,有新的建议可以加上,比如 NOFMT。最后还教会了我一点小技巧,对于不想维护的仓库,可以放入只读模式,这样其他人就没法提 PR 和 issue 了。
默默跟踪了一下这个项目,最近又多了一个 issue。老外说话简单直接啊,标题就说你这个仓库不一定会受欢迎。具体是:1. 不同版本的 gofmt 格式会有细微变化,协作者之间不一定用相同的 go 版本,gofmt 的结果不可靠。2. 你这是自动化操作的,都没有看过人家的代码,就可以刷 GitHub 的小绿点,夸大自己在 GitHub 的贡献。你这是虚伪 3. 我有些格式是 golang 代码规范允许的,你这个机器人给我改坏了。
作者的回应也很精彩,建议大家读下原文。我简单总结一下:1. 你来这里发 issue 了,其他人也能找到这里来。我这个仓库就是提供一个讨论的空间,让不满和忧虑可以得到表达。我不开仓库,默默的用匿名账户提交,机器人跑完了事,才是虚伪。2. 我都是小批量的跑,跑完会人肉去跟进 PR,跟普通人一样,签 CLA(签名表明提交不涉及版权内容)、跟进代码覆盖和整理提交信息。3. 关于机器人,GitHub 目前已经有很多机器人了,比如 CLA 机器人、安全检查机器人、格式检查机器人等等,既然仓库主人都用机器人管理了,那有人用机器人提交 PR 也很合理。
回到标题,你说的对,没有办法可以令一个产品让所有人满意的。但是管理低质量提交是 GitHub 公开仓库管理者的日常啊,高质量的提交也不一定受欢迎,因为大家对架构、优先级、实现方式的构想也可能不同。具体到我这场实验,提出的 155 个 PR 中,关闭了 55 个,其中 40 个都合并了,成功率有 72%,所以总体而言,我还是受欢迎的。农夫如果用机械作业,就不配得到他的粮食吗?为什么要歧视机器人呢?
这次事件最大的触动是,以前会自己弄 CI,搞个机器人检查代码覆盖,单元测试通过率,代码格式化等等。现在,即使你不搞,依然会有人用爬虫逐个逐个遍历 GitHub 的项目,帮你搞完,给你提 PR。这一切还是自动化的,就好比你开源在 GitHub 了,就会有机器人鞭策你前进一样。学会与机器人共生变成越来越重要的技能了。另外,写作也是一个重要的技能,GitHub 上通过 issue 互动,也是重要的贡献方式。代码是很重要,代码承载的思想同样重要,你必须要有能力传播你的观点,感化更多人与你一道参与,开源事业才会顺利
62 - bug 狩猎
最近需求少了,终于有时间修一下底层的 bug,做一点工具方便查 bug,写篇文章简单记录一下。
一是优化了一个玩法进程的启动速度。这个玩法需要用战力做匹配,玩家按战力分段放进不同的桶里,每个桶用 skiplist 组织。启动服务器的时候,会遍历所有玩家,放进对应的桶里,方便正式开放的时候进行搜索匹配。之前是遍历策划配置的战力分段表,高端玩家几乎要遍历完整个表才能进到桶里。现在改成了二分查找,匹配速度提高了好多
二是隔壁组做 mmo 的同事,问了下有没有现成的查内存泄漏的工具。他们加班的比较凶,周六晚加完后,周一发现服务器被 OOM Killer 杀掉了。。。于是整合了一下云风的 lua-snapshot,做到 skynet 里面, 提了个 PR。原理比较简单,第一次调用 snapshot 的时候,对 VM 的内存对象做一次镜像。做了某个可疑操作后,再调一次 snapshot,前后镜像做比对。我对比较出来的对象按层次组织了一下,方便日志里打印。
三是修复了 gosproto 的 pack 函数。这个 bug 相当诡异,会打出来一个客户端无法解包的 sproto 包。 详情见 github 上的 PR,顺便读了下 sproto 的 pack 的文档 ,0xFF 后面接的 N 是拷贝 (N+1)*8 bytes 的意思,之前理解错了。。 unpack 应该还有问题,还在看。。。
63 - LessonLearned
最近,中兴 ZTE 违反美国商务部禁令,向伊朗出售敏感技术,被美国下达长达 7 年的禁止令,教训十分深刻。以诚待人,信守承诺,才能在商业社会站稳脚跟。
还是说说最近自己上的一课吧。上了港台服以后,奇奇怪怪的问题比较多。其中之一是玩家被异常登录了。现象是玩家登录游戏,提示账号被异常登录。这种现象本来应该在玩家顶号操作时,被顶号的设备上出现的。不应该在正在登录的活跃客户端上显示
回顾现在的登录过程,玩家连上游戏后,首先会创建一个 session。登录完成后,会产生 user 挂在 session 上。最后,会找到对应的 agent,在上面建立对应的 role。当发生顶号的时候,会调用 agent 的下线流程,下线完成后,清理 session。清理完成后,新玩家再执行正常登录流程
现在的问题是,下线过程中,某一步变得比平常慢非常多,结果踢人卡住了。然后再次登录,又继续走踢人流程,结果变成新用户收到了错误的顶号提示信息。。。
要彻底改掉这个问题,要么将顶号简化,变成只切换 fd,不走下线流程;要么加上保护标记,玩家在下线过程里再登录,明确提示正在下线,请稍后再试。目前准备先上一些临时的解决方案,用 gm 指令清除已登录的标记,让玩家可以正常登,到时候覆盖之前下线存盘的数据就好。
关于某一步登出特别慢的问题,想了一下,大概有两个方向,原因差不多。一个是离线过程里,agent 服务要向其他服务发起调用,如果 call 比较多的话,会多次挂起。每次挂起后,收到返回值,都要重新排到消息队列末尾,如果系统繁忙,这时候需要处理的消息特别多,就会出现下线的函数耗时非常久了。另一个方向,是下线的时候,要向一个热门服务发起调用,这个服务的消息队列非常长,导致响应下线请求很慢。这两个问题都涉及到协程调度的公平问题,某些场景下,协程会出现饥饿(starvation)的情况,得不到调度。如果要搞分优先级的调度,估计会变得很麻烦,这块还要再想想
64 - 下划线引起的血案
最近公司搬迁,所有虚拟机都要重新部署,累死了。然后 Python 一堆依赖以前没管理好,直接装全局位置,也忘记导出一份版本号到新机器来安装。这是祸根
换到新机器后,Skynet 和 Golang 相关应用都跑起来了。但是 Python 写的内部应用有点问题,网站认证后,认证用户名 valid_username 一直传不到应用里。检查过内部 Oauth 的代码,以及 Nginx 的转发配置,都没有问题。最终通过重放请求定位到是 Gevent 丢掉了这个参数。同事帮忙翻了下 更新日志 ,发现因为安全问题,带下划线的变量不再传递了,参考 issue 819 和 issue 775
819 很简洁的引用了 waitress 库 以及 Django,Apache 和 Nginx 的安全更新日志 。原来,这是一个下划线和破折号自动转换引起的 WSGI header 欺骗攻击。在 WSGI 环境下,所有 HTTP 请求头会全部转换为大写字母,所有破折号转换成下划线,并添加 HTTP_ 前缀。例如,X-Auth-User 会转换成 HTTP_X_AUTH_USER
这意味着,WSGI 环境无法区分带有破折号的请求头和带有下划线的请求头。比如,为了防止访客伪造请求,我写了过滤规则,将客户端发来的 X-Auth-User 变量都干掉。但是,对方有可能发的是 X-Auth_User,最后依然可以转化成 HTTP_X_AUTH_USER,从而绕过安全认证
这个攻击是 CVE-2015-0219,为了防止这种攻击,各大框架都加上了过滤下划线请求头的功能。内部应用还是用的带下划线请求头,所以触礁了。。。也就是说,以前的应用一直有安全漏洞,valid_username 请求头可能被伪造。当然,正常登录后,也是用 valid_username 来传递信息的,这个也要改掉,WSGI 不分敌我的干掉了。。。
Golang 里还是照样可以使用下划线,因为 Golang 没有 WSGI 这货,天然就可以作为 Web 服务器跑起来。 有篇爆栈的文章解释为什么 Golang 不需要 WSGI
65 - Intel 的 CPU 漏洞:Spectre
最近觉得越来越忙,写博客都没精力了。一定是太沉迷农药和刷即刻了
17 年年底,18 年年初,Intel 被爆出了 Meltdown(熔断)和 Spectre(幽灵)漏洞。等 Spectre 攻击的 POC 出来以后, 去 github 围观了一下 ,真的非常精妙,好想贴上来分享一下。
主要代码就在 Source.c 里面,实际生效的不到 100 行,真的很精致。victim_function 是用来越权访问的,看代码是没有问题的,x 不符合条件,就不能访问到对应的内存。但是因为分支预测器的原因,即使没有满足 if 的条件,若分支预测器觉得条件会成立,还是会一边执行 if 的条件判断,一边执行 if 内的代码。当然,判断 if 失败后,会将 if 内代码执行的结果抛弃掉的。妙就妙在这里,结果会被回滚,但是 cache 不会。于是只要测度 array2 哪里访问的比较快,就知道密文是什么了。
如何欺骗分支预测器呢?看这里:
跑 5 次满足 if 条件的调用,再跑一次不满足 if 条件的攻击。中间用位运算是为了避免额外的 if 语句会触动分支预测器。
测时间的逻辑在这:
用到了 高精度的 rdtscp 来计时,可以读入 CPU 计数器的读数。这里还硬编码了 167 和 13 进去,其实就是两个质数,目的就是让 cache 预读摸不着头脑,不会因为线性预读取干扰了测时。
为了对抗 Spectre 攻击,Google 推出了 Retpoline 方法 ,涉及到对可执行文件的二进制修改,还没看懂。。。
66 - git 和 redmine 同步
最近实现了 github 以及内部的 gitbucket 与 redmine 的同步。
redmine 是内部使用的一套工单系统,用于跟踪 bug 和需求,由于最近同时开发的版本比较多,在不同分支的提交容易漏掉。现在改为用 redmine 的工单跟踪需求和 bug 修复,提交的时候,只要在提交日志里写上单号,机器人就可以将提交信息同步到表单,可以方便的跟踪到提交有没有漏提交到指定分支。
实现上居然很简单,整个过程还是很愉悦的。gitbucket 方面比较简单,gitbucket 的仓库属主可以添加一个 hook,每次提交的时候 gitbucket 会调一下 hook。调用里会包含提交的详细信息,包括分支、提交信息、具体改动的网页版地址。只要用正则搜出单号,然后利用 redmine 的 rest api 提交到表单里,就完成任务了。
github 的动手前觉得困难一点,因为 github 在外网,工单系统是内网访问的。没想到 github 体贴的推荐了 ngrok 作为安全的内网穿透工具。指定好协议和端口号之后,启动 ngrok 客户端,会自动随机生成一个 https 的二级域名。对这个域名的访问,会落到内网的 ngrok 客户端上。中间的通讯是加密的。这项服务这么优秀,居然还是免费的!比国内的花某壳好多了。
打通内外网之后,剩下的步骤就和 gitbucket 的相差不多了。github 的好处是每个人都可以对仓库设置自己的 hook,还不止一个。遇到的小小的梗,是 github 的时间就是国内时区的,不像 gitbucket 还要从零时区算时间偏移。调试也很方便,每一次推送都可以在 github 上查阅到具体的请求内容,还能方便的 redeliver,调到合适为止。
以后可以在表单里写明需要提交到哪些分支,然后提交后隔一段时间自动检查,发现有漏提交就提醒程序或者策划,不过目前很懒,没有动力做这个 QAQ
67 - syslog 日志打印
68 - redis 的 LRU 算法(一)
最近加班比较累,完全不想写作了。。
刚看到 一篇有趣的文章 ,是 redis 的作者 antirez 对 redis 的 LRU 算法的回顾。LRU 算法是 Least Recently Used 的意思,将最近最少使用的资源丢掉。Redis 经常被用作 cache,如果能够将不常用的 key 移除,尽量保留常用的,那内存的利用率就相当高了。当然,LRU 也有弱点,考虑下面一种情况:
假设有 4 个 key,A 以 5 秒 1 次的频率被访问,B 访问频率是 2 秒 1 次,C 和 D 的访问频率都是 10 秒 1 次。因为 B 有最高的访问频率,所以 B 的空闲访问时间是最小的。它的上次访问时间也是第二最近的。但是 D 是一个特例,它的访问频率是 10 秒 1 次,但是它的访问时间是最近的。
当然,长期来看,这个算法还是不错的。通常访问频率高的 key 都有相对比较小的空闲时间。LRU 算法会换掉最近最少使用的 key,即空闲时间最长的。这个算法实现起来非常简单,我们秩序要跟踪一个 key 上次访问的时间即可,甚至有时候都不用,只要维持一个链表,有访问的就移动到表头,需要换掉元素的时候,就移除链表尾部的。
Redis 最早并不支持 LRU 替换。通过修改 Redis 对象结构,作者挤出了 24bit 空间来做这个事情。因为指针太大,也没有空间来用链表实现。24bit 用来存时间戳的低位已经足够了,可以支撑 194 天了,key 的数据刷新频繁,够用了。
如何选择最大空闲时间的 key 来换出也是一个问题,Redis 的 key 存放在一个平坦的哈希表里,添加一个额外的数据结构来完成代价太大。既然 LRU 是理想换页的一个渐近算法,我们何不尝试下 LRU 的渐近算法呢?
Redis 的原始实现非常简单:当需要换出一个 Key 的时候,选任意 3 个 key,,换出其中空闲时间最长的。相当于对整个 key 空间进行随机采样,并换出较好的选择。后来这个算法演变成 N 个随机 key,算法优化后,默认变成采样 5 个 key,速度没有损失。虽然实现是如此简单,但工作起来非常好。如果你仔细思考,你会发现你不可能用这个算法作出最佳决定,但是你也不大可能作出非常坏的决定。如果数据集里有一堆经常访问的 key,5 选 1 不大可能都挑中热的 key。
69 - skynet 的网络收发
最近,有位前同事在 skynet 仓库里提了个 有关网络性能的 issue,正好理一下 skynet 的流程。
70 - skynet 的火焰图
之前搞过一下 systemtap(systemtap 折腾笔记 ),可惜很快琐事缠身,没有继续搞下去。最近偷空搞了一下,有点意思。
章大大的思路,是用 perl 生成 systemtap 脚本,从 /proc/$pid/maps 里面扫出 liblua.so 的地址。然后 hook 这个地址里,以 luaL_* 和 lua_* 开头的 lua 虚拟机 C 函数。hook 住的函数里,都会有个参数 L,这个 L 表示 lua 的虚拟机。接下来就是按 lua 的 C 代码撸一遍,看看怎么从 L 的内存结构里,dump 出整个 lua 的运行栈。相当于在 systemtap 里,重新实现一遍官方的 debug.traceback。
换到 skynet 里实现,有几个不同点。首先,skynet 是把 lua 静态编译进去的,所以无法找到 liblua.so。其实这样问题更简单了,不需要扫 so 的地址,只要 hook 住 skynet 里的相关函数,一样可以拿到 L 的地址。其次,是 skynet 用的是魔改版的 lua,所以 proto 的位置与官方版有点不同,而且现在用的是 lua53 了,跟 openresty 的 lua51 比还是有差异的。我实现了一版给 skynet 用的 lua-bt,参见 skynet_systemtap_set 仓库里的 mini_lua_bt.stp

做出来的效果就是上图这样。因为没有用户登录,所以只有一个 exchange 服务在跑。这个服务是用于和平台通讯的,所以会定时处理一些消息。
目前还有点小问题,有时候同一个栈位置会打印两次,还没找到原因。另一个是目前打印的是文件名和行数,没有函数名直观。但是 lua 的函数其实只是一个指针,可以给这个指针绑定不同的名字,都是同一个函数,而且代码里还有大量的匿名函数,所以不好搞出来函数名。另外,从 skynet 的结构来说,其实可以找到更接近业务层的点。skynet 底层是 socket-server,然后用 sn-lua 跑 lua 服务,再用 lua-skynet.c 为 lua 服务提供 skynet 的接口。hook 住 lua-skynet 的 lcallback,应该就能看到 skynet 调 lua 业务的东西了。不过这个还没搞好
接下来再慢慢补充一下其他类型的脚本。。
71 - 伤感三月
带着我经历过两个项目的 boss 离职了,好遗憾。老同事过来我们组帮忙了,算是一个小小的惊喜。
最近看了《垃圾回收的算法与实现》,说实话,译者的水平比较有限,有几处明显的理解错误。不过,书里的插图还是很易懂的,看着伪代码和插图,勉强读了下来。读完会比较清醒的意识到,即使有 gc 帮助,还是有可能会有内存泄漏的。月中抽空压测了一下,的确发现了有泄漏。。
我们用的脚本语言是 Lua,Lua 采用的是标记清除算法,从根出发,搜索不可达对象并回收掉。如果有泄漏,一定是有资源被某个地方引用住了,没有释放。从根里出发,会创建大量的 role 对象,但玩家下线的时候,明明已经释放对象了的。刚好新加了 skynet task 指令,发现 task 只增不减,才找到方向。原来从根出发,除了 role 对象,还有大量的协程对象。这些对象用于处理计时器、消息队列等设施。消息队列没有消息的时候会将当前协程放入等待队列,有消息再唤醒。而 sub 消息的 handler,往往带有 role 对象,方便处理消息。玩家下线时,role 字典里已经清空对应的 role,但是还有沉睡的协程在引用,于是就有泄漏了。消息循环改为停止时唤醒所有睡眠协程,问题就解决了。或许我应该改成插入一个中断消息?
一周 6 天的生活什么时候到头呢?好想放空自己
72 - 加班月
本月都在埋头加班,没搞什么有趣的东西,就分享一篇 Cloudflare 捅的篓子吧 XD
Google 有个叫 Project Zero 的安全团队,成员 Tavis Ormandy 某天做一个语料库项目,突然发现 Google 缓存数据里出现了完整的 https 请求。排查发现这些请求都来自于 Cloudflare。Cloudflare 是业界闻名的 CDN,通过 DNS 解释的原理工作,不需要修改页面的资源地址,而是将代理资源的域名,解释到靠近访客的 Cloudflare 服务器上,以此达到加速效果。Tavis 怀疑这次事故跟 Cloudflare 的 ScrapeShield 产品有关。ScrapeShield 是一个页面改写的产品,用来在网页里混入不可见的随机字符串,以跟踪爬虫的来源;对爬虫改写正文里的 email,以防被批量爬 Email 地址发垃圾邮件。(参见 Tavis Ormandy 的 报告 )
Cloudflare 接到报告后,用了 47 分钟关掉三个特性,7 个小时后修复了漏洞。( 参见 Cloudflare 的报告 )报告非常长,我这里简单说一下。Cloudflare 使用了 Ragel 来处理 html 改写的任务,Ragel 通过一般的正则表达式描述有限状态机,并将其编译成 C 代码执行。因业务发展,Cloudflare 决定用新的 cf-html 来取代 Ragel。Ragel 和 cf-html 最终都是生成 nginx 的 C 代码模块,编译到 nginx 里面去。基于 Ragel 的分词器就有这个 bug,换 cf-html 潜在改变了 buffer 的用法,引发了泄漏。罪魁祸首是以下这段代码:
因为在某些情形下,p 有可能越过 pe,导致了内存越界读取。生成这段 C 代码的 Ragel 代码如下:
有意思的是,Cloudflare 在正文里提示用 ++p >= pe 就可以避免这个错误,但强调这个不是 Ragel 的问题(即使这句代码是 Ragel 生成的)。Ragel 的作者则在 评论吐槽说 ,Cloudflare 的报告毁掉了他的生意。而 Google 的大牛则花了整个周末帮忙清理 Google 的 cache,验证 Cloudflare 的漏洞是否已堵上,顺便发现了一款流行密码管理器明文传输密码(1password 已否认,剩下的 Lastpass、Enpass 不知道会不会表态呢?)随后,Ragel 的作者写了 一篇文章 ,解释了 Ragel 的正确用法。
Ragel 是一门描述状态机的语言,fgoto 语句用于跳转到状态机中的其他子状态。Ragel 允许用户定义 Action,在各种情形下执行。Error Action 是正常处理流程无法继续时执行的 Action。它们一般在两种情形下执行:1. 错误发生在当前字符 2. 状态还没到达最终状态,而输入已经结束。如果错误发生在情形 1,是否 fhold 来回退指针无关紧要。但是情形 2 里,因为输入已经结束,这时候必须回退。现有的 Ragel 代码需要检查自己对情形 2 的处理。
73 - theevolutionofLua 全文翻译
终于赶在春节前将论文全文翻译完,以后有时间将前面三章重新翻译一次,因为刚开始的时候没打算全文翻译的。。第一次每天花 25 分钟完成这么长的一篇翻译,证明滴水可以穿石,哈哈哈
中文地址:Lua 的演进
祝各位新春快乐,鸡年大吉,恭喜恭喜
74 - 2016 年终总结
今年写了 14 篇博客,比去年的 18 篇要少,没有什么新技术,有点遗憾。倒是读了几篇好文章,比如 Linkedin 团队分享的 The Log,还有 The evolution of Lua。看了一下去年的 年终总结 ,发现目标基本都没完成。゚ヽ (゚Д`)ノ゚。 只有坚持博客这点算是完成了。关于 TCP/IP 协议,其实很想就 Google 家的 BBR 写一篇短文,等下试试。建站这点完全提不起动力,买了域名和 VPS 之后,就搭了个 Google 网页代理就算了。。
2016 是第一次感觉到年纪大的一年。渐渐感觉到反应变慢了,特别是和别人讨论的时候,但是一旦理清了需求,就比以往更清晰的看到问题所在,更快找到解决办法。真是好坏参半的变化呢。
今年相比去年的进步之处,在于实现了更好的知识管理和时间管理。知识管理上,更频繁的利用印象笔记了,将值得收藏的文章放入笔记里,可以不受网络限制,随时随地阅读。还有大量的写作工作日志,特别是服务器部署相关的,下次部署就方便多了。(其实做 fabfile 更好,可惜虚拟机每次都不一样。。。)每天写日志,每周写周结,每月写月结,这样才好写年结。另外,总结可以迫使自己进行回顾,从而做出时间跨度更大的思考,以完成更宏大的目标。时间管理上,除了继续坚持使用番茄工作法管理注意力,还使用了 moment 监控手机使用时间,sleepbot 来监控睡眠时间(后来转了 autosleep)。atimelogger2 不错,只是我需要的是标签云,而不是有严格归属的类目录结构。
2017 年的展望比较简单,能够继续坚持自己的 sideproject 就好。最近的 sideproject 是智能家居,有点好玩 O(_)O 年度具体目标不好定,先定三个试试:1、 游戏成功上线 2、 看完 Google BBR,掌握 TCP 优化技巧 3、翻译完 The evolution of Lua,掌握 Lua 实用技巧
75 - 《The Evolution of Lua》翻译 part2
Lua2 1990 年的时候,面向对象迈向巅峰,对于 Lua 没有面向对象的支持,我们受到了很大的压力。我们不想将 Lua 变成面向对象,因为我们不想 “ 修复 ” 一种编程范式(fix a programming paradigm)。特别是,我们不觉得 Lua 需要将对象和类作为基础语言概念,我们觉得可以透过 table 来实现(table 可以保存方法和数据,因为函数是第一类对象)。直到今天,Lua 也没有强加任何对象和类模型给用户,我们初心不变。很多用户建议和实现了面向对象模型;面向对象也是邮件列表里经常讨论的问题,我们觉得这是健康的。
另一方面,我们希望允许 Lua 可以面向对象编程。我们决定提供一套灵活的机制,让用户可以选择对应用来说合适的模型,而不是修复模型。1995 年 2 月发布的 Lua2.1,标志着这些灵活语义的问世,极大的增加了 Lua 的表达能力,从此,灵活语义就变成了 Lua 的标志。
灵活语义的一个目标是允许 table 作为对象和类的基础。为了实现这个目标,我们需要实现 table 的继承。另一个目标是将 userdata 变成应用数据的天然代理,可以作为函数参数而不只是一个句柄。我们希望能够索引 userdata,就好像他们只是一个 table,可供调用他们身上的方法。这让 Lua 可以更为自然的实现自己的主要设计目标:通过提供脚本访问到应用服务和数据,从而扩展应用。我们决定实现一套 fallback 机制,让 Lua 把未定义行为交给程序员处理,而不是直接在语言本身实现这些特性。
在 Lua2.1 的时候,我们提供了 fallback 机制,支持以下行为:table 索引,算术操作符,字符串拼接,顺序比较,函数调用。当这些操作应用到 “ 错误 ” 的类型上,对应的 fallback 就会被调用到,允许程序员决定 Lua 如何处理。table 索引 fallback 允许 userdata 和其它值类型表现的跟表一样。我们也定义了当 Key 不在 table 时的 fallback,从而实现多种形式的继承(通过委托)。为了完善面向对象编程,我们添加了两个语法糖:function a:foo(…) 就好比 function a.foo(self,…) 一样,以及 a:foo(…) 作为 a.foo(a, …) 的语法糖。在 6.8 节我们会讨论 fallback 的细节。
从 Lua1.0 开始,我们就提供了值类型的内省函数(introspective functions):type,可以用来获取 Lua 值的类型;next,可以用来遍历一个 table;以及 nextvar,可以遍历全局环境。(正如第四章所述,这是为了实现类似 SOL 的类型检查)为了应付用户对完整调试设施的强烈需求,1995 年 12 月发布的 Lua2.2 引入了一个 debug API 来获取运行中的函数信息。这个 API 为用户提供了以 C 语言编写自己的内省函数工具链的手段,比如编写自己的调试器和性能分析工具。debug API 刚开始的时候相当简洁:debug 库允许访问 Lua 的调用栈,访问当前执行的代码行行数,以及一个可以查找指定值的变量名的函数。根据 M.Sc. 的 Tomas Gorham 的工作,debug API 在 1996 年 5 月发布的 Lua2.4 版本里得到了完善,提供了函数访问局部变量,提供了钩子在行数变化和函数调用时触发。
因为 Lua 在 Tecgraf 的广泛使用,很多大型的图形源文件都是用 Lua 写的,作为图形编辑器的输出格式。加载这些源文件会随着文件大小变得越来越大和越来越复杂而变的越来越长。从第一版开始,Lua 就预编译所有程序到字节码,再执行字节码。大型代码文件的加载时间可以通过保存 bytecode 来缩减。这和处理图形源文件特别有关系。所以在 Lua 2.4 版本,我们引入了一个外部编译器 Luac,可以编译一个 Lua 文件为字节码并保存为二进制文件。这个二进制文件的格式经过精心选择,可以轻松加载同时体积小巧。通过 luac,程序员可以在运行期避免词法分析和代码生成,这些操作早期还是比较耗时的。除了更快的加载,luac 还允许离线的语法检查,以及随意的用户改动。很多产品(比如模拟人生和 Adobe 的 Lightroom)都是透过预编译格式发布 Lua 脚本的。
在 luac 的实现过程里,我们开始将 Lua 的核心重构成清晰的分离模块。于是,我们现在可以轻易移除词法解析的模块(词法解析器,语法解析器和代码生成器),这些部分占了大约 35% 的核心代码,剩下的部分可以加载预编译的 Lua 脚本。这种代码剪裁,对于在移动设备、机器人和感应器这些小设备里嵌入 Lua,是有显著意义的。
从第一版开始,Lua 就自带有一个库来进行字符串处理。这个库在 Lua2.4 之前功能有限。但是,随着 Lua 的成熟,Lua 需要进行更重量级的字符串处理。我们认为,沿革 Snobol,Icon,Awk 和 Perl 的传统,为 Lua 添加模式匹配是自然而然的。但是,我们不想将第三方的模式匹配引擎打包到 Lua 里面去,因为这些引擎通常都很大,我们也希望避开因为引入第三方库带来的代码版权问题。
1995 年的第二学期,作为 Roberto 指导下的学生项目,Milton Jonathan,Pedro Miller Rabinovitch,Pedro Willemsens 和 Vinicius Almendra 为 Lua 写出了一个模式匹配库。那个设计的经验引导我们写出了我们自己的模式匹配引擎。1996 年的 12 月,我们在 Lua2.5 中添加了两个函数:strfind(最早职能查找纯文本)和新的 gsub 函数(名字来源于 Awk)。gsub 函数可以用来全局替换符合指定模式的子串。它接受一个新的字符串或者一个函数作为参数,函数参数会在每次遇到匹配时调用,并预期该函数返回新子串以供替换。为了缩小实现的规模,我们没有支持完整的正则表达式。我们支持的模式包括字符类,重复,以及捕获(但是没有可选或组匹配)除了简洁性,这种模式匹配还十分强大,是 Lua 的一个强有力的补充。
那一年是 Lua 历史上的转折点,因为 Lua 获得了全球的曝光。在 1996 年 6 月,我们在《Software:Practice & Experience》杂志上发布了一篇 Lua 的文章,为 Lua 带来了外部的关注,至少是学术圈子的关注。在 1996 年的 12 月,Lua 2.5 刚刚发布后,杂志 Dr.Dobb’s Journal 也发表了 Lua 的文章。Dr.Dobb’s Journal 是一本面向程序员的流行刊物,那篇文章为 Lua 带去了软件工业界的关注。在那次发布之后,我们收到了很多消息,其中一条是 1997 年 1 月收到的,来自 Bret Mogilefsky,LucasArts 出品的冒险游戏 ——Grim Fandango 的首席程序员。Bret 告诉我们,他从 Dr.Dobb’s 上读到了 Lua,他们打算用 Lua 代替自己写的脚本语言。1998 年 10 月,Grim Fandango 发布,1999 年 5 月 Bret 告诉我们 “ 大量的游戏都是用 Lua 写的 ”。那个时候,Bret 参加了 GDC(Game Developers’ Conference, 游戏开发者会议)的有关游戏脚本的圆桌会议。他谈到了 Grim Fandango 应用 Lua 的成功经验。很多我们认识的开发者,都是在那次事件里认识到 Lua 的。在那以后,Lua 在游戏程序员之间口耳相传,变成了游戏工业里可资销售的技能。
因为 Lua 的国际化曝光,向我们提问 Lua 的信息越来越多。1997 年 2 月,我们建立了邮件列表,好更有效率的处理这些问题,让其他人也能帮忙回答问题,并开始建设 Lua 社区。这个列表至今发布了超过 38000 条消息。很多热门游戏对 Lua 的使用,吸引了很多人到邮件列表里。现在已经有超过 1200 个订阅者了。Lua 列表十分友善,同时又富有技术性,我们对此深感幸运。邮件列表逐渐变成了 Lua 社区的焦点所在,也是 Lua 演进的动力源泉。所有的重大事件,都是首先在邮件列表里出现的:发布重大通知,请求新特性,bug 报告等等。
在 Usenet 新闻组里建立 comp.lang.lua 讨论组曾经在邮件列表里讨论过两次,分别是 1998 年的 4 月和 1999 年的 7 月。两次的结论都是邮件列表的流量不能保证创建一个新闻组。而且,更多人倾向于邮件列表。随着多个阅读和搜索完整邮件存档的 web 界面问世,创建新闻组变得无关紧要了。
76 - 《The Evolution of Lua》读书笔记 1
lua 的优点:
* 可移植性
* 容易嵌入
* 体积小
* 高效率
这些优点都来自于 lua 的设计目标:简洁。从 Scheme 获得了很多灵感,包括匿名函数,合理的语义域概念
lua 前身: 巴西被禁运,引入计算机软件和硬件受限,巴西人有强烈的民族情绪去创造自己的软件。三名作者都是同一个实验室 Tecgraf 的,这个实验室与很多工业实体有合作关系。成立的头十年,重点是创造交互性的图形软件,帮助合作伙伴进行设计。巴西石油公司是其中一个重要伙伴。有大量的遗留数据需要处理。于是诞生了 DEL,一个领域专用语言,主要用来描述数据流图的数据的。后来人们对 DEL 需求越来越多,不止是一门简单的数据描述语言可以解决的了。
lua 为解决实际问题而生,受到三位作者学过的语言影响。自己创造的是 ..(两个句号)连接字符串。自豪的是,在 13 年的演进里,lua 的类型系统只修改了两次。lua 诞生的时候,基本类型包括 nil,number,string,table,C function,Lua function,userdata。97 年的时候,Lua3.0 将 C function 和 Lua function 合并了。03 年的时候,提出了 boolean 值类型,增加了 thread 协程类型。
1993 年,第一版 Lua 由 Waldemar 在 Roberto 指导下完成。词法分析用了 Unix 上经典的 yacc 和 lex。解释器将 lua 代码翻译成针对一个基于栈的虚拟机的指令。C API 很容易扩展,因此最早只有 5 个函数(print,tonumber,type,next,nextvar)和 3 个库(input/output, string, math)。
Lua 的历史 lua 的发布模式和其他社区不一样。alpha 版本已经相当稳定,beta 版本几乎可以作为 final 版,除非是用来修复 bug。这个发布模式对于 lua 的稳定性有很大帮助,但不利于尝试新特性。因此,从 5.0 版本开始,添加了新的 work 版本。work 版本是 lua 当前开发版的 snapshot,有助于 lua 社区迈向开源社区的哲学:早发布、多发布。
lua 的标准库被刻意保持在一个很小的范围,因为大部分需要的功能都会由宿主或第三方库提供。4.0 对 C API 重新设计了,C API 有很大改动,之后就向着完美一点点前进了。结果是不再有任何内置函数,所有标准库都是基于 C API 实现,没有通过特别的后门去访问 Lua 内部结构。
Lua 的 vm 在 4.0 版本以前一直是基于栈的。在 3.1 版本,我们对多个指令添加了变量来提高性能。后来发现这个实现复杂度很高,性能提升不明显,于是在 Lua 3.2 版本去掉了。从 Lua 5.0 开始,vm 改为基于寄存器。代码生成器因此有更多机会去优化和减少常见 Lua 程序的指令数了。
Lua1 Lua 的成功使得 Lua 被大规模用在数据描述上,而预编译 Lua 代码为 VM 字节码的特性,迫使 Lua 编译器必须非常快,即使是对于大型项目。通过将 lex 产生的 scanner 替换为一个手写的版本,我们几乎让 Lua 编译器的速度翻了一倍。同时,我们修改了 Lua VM 的 table 构造函数,构造一个大型的表不再需要一条条指令传参数进去了,可以一次调用完成。从那以后,优化重点就变成了预编译时间。
1994 年,我们发布了带有这些优化的 lua 版本:Lua1.1。这次发布和第一篇描述 Lua 的设计和实现的文章是重合的。之前从未公开发布过的版本,就被称为 Lua 1.0(Lua1.0 的一个 1993 年 7 月的 snapshot 在 2003 年 10 月发布,以此庆祝 Lua 十周年)
Lua 1.1 最早以源码方式在 ftp 提供下载。这远在开源运动兴盛蓬勃之前。Lua1.1 有限制性的用户协议,对于学术用途是免费的,但是商业用途则需要协商。那部分协议没有凑效:尽管我们有一些初始联系人,从没有商业使用是经过协商的。其它脚本语言(比如 Tcl)的免费促使我们意识到,限制商用甚至会反过来影响学术用途的发展,因为一些学术项目是打算最终走向市场的。因此,当发布 Lua2.1 的时候,我们将 Lua 作为无限制免费软件发布了。我们天真的以一种学院气的口吻对之前的协议重新措辞,并觉得新协议写的很直观了。稍后,随着开源许可证的散播,我们的协议文本变成了干扰着一些用户的噪音:我们的协议没有清晰的说明是否和 GPL 协议相容。在 2002 年 5 月,在邮件列表里进行了冗长的讨论后,我们决定将来发布的 Lua 版本(从 Lua 5.0 开始)都使用非常清晰直观的 MIT 协议。2002 年 7 月,自由软件基金会(FSF)确认了我们之前的协议是 GPL 兼容的。但我们已经决定采纳 MIT 协议了。对我们协议的疑问从此都消失了。
77 - 《一个 Go 程序系统线程暴涨的问题》结论
原文地址:https://zhuanlan.zhihu.com/p/22474724
作者的结论没写好,我来说两句。。
78 - 空中换心
最近一周在做一件非常刺激的事情,刺激到不想再干第二遍了 T_T。。。还有一个月就要内测的时候,换掉服务器架构,而且还要同时做需求,无异于对空中的飞机换引擎啊
8 月末的时候,老大开了个会,服务器架构要重构一下,将以前的逻辑分服改成物理分服。之前的架构里,开新服很简单,但因为是大服结构,任何一个逻辑服挂了,都会影响其他服的玩家,隔离性不够高。同时,做单服的服务时,处理逻辑需要考虑不同服的影响,添加了额外的心智负担,不容易做对。于是,架构决定改成这样:
每个 game 是一个进程,这样任意 game 挂掉都不会影响其他服务器了,适合策划们大量开新服,每周清理关停老服的洗量玩法。设计的时候,希望各个进程之间是松散的结合到一起的,甚至 center 都没有直接 call 到 game 的接口。取而代之的,是一个消息队列。game 上线之后,就在 center 上创建一个消息队列,center 需要发消息给 game,就丢一个消息到队列里。最终的目标是,center 即使短暂挂掉,也能快速重启,只造成短时间新玩家无法登录,已经登录游戏的玩家应该能继续游戏。同时,center 的结构足够简单,几乎不会挂掉。
上周老大和另外一位同事做了一周,这周就决定切换到新架构来了。因为我的工作主要是写逻辑,基本都是在玩家身上,挂在 agent 上的玩法,所以改动的地方不多,修好聊天和邮箱服务即可。于是,一边消化策划的新需求,一边参与迁移新架构。实际结果喜忧参半,喜的是新写的逻辑因为都在 agent 上,可以完全复用;忧的是时间非常紧迫,然后还要处理一些迁移架构带来的 bug。幸而最后还是活过来了 XD
关于这次架构的变动,也跟其他组的同事讨论过,不过被吐槽说跟 skynet 的 master-slave 架构没什么区别 ^_^ 回来仔细想了一下,感觉还是可以辩护一下的。第一点,之前用的 master-slave,没有指定 slave 具体负责的逻辑服 id,每个 slave 都是相同的,都有可能被不同服的客户端连上。当然,这个问题可以改掉,改成跟现在架构类似的。第二点,之前的 master 挂掉之后,slave 虽然不会马上挂掉,但是公会之类的服务是放在特殊的 slave 上的,也会立即失效,而新架构都在一个进程内,还能继续工作。归根结底,是因为 master-slave 被认为是一个稳定的整体,skynet 不会处理内部的网络连接断开的。如果换成 cluster,用消息队列来连接,相对来说容错性就更高了
策划们最近学聪明了,也要搞隔离式设计了。出了十几二十种资源,基本都不互通,很多资源都是某个功能专有的,比如这种资源专用于升装备指定属性,那种资源用来升英雄特定属性。每种资源的投放到回收都隔离开来,不会相互影响。做设计的时候就可以不怎么动脑了,做错了大不了直接关掉这个系统,不需要为之前挖的坑埋单。对于这种快餐式设计,只能无奈叹气。程序做起来没什么难度啊,多一种资源不就多记一个变量。只不过这种水平扩展的系统,能不能给玩家带去更有层次感的游戏体验,个人对此表示怀疑。
79 - 阅读分享:游戏服务器的设计与面向日志的工作流
7 月的工作平淡无奇,除了 X 系统由借鉴 A 游戏改成借鉴 B 游戏,就没什么了,还是谈点别的吧。
最近看了 《游戏服务器端究竟解决了什么问题》,推荐给大家。作者关于烂框架的分析很有趣,框架定义角色时,不恰当的角色划分,会引起额外的复杂度,作者文章中后部分有分析。
作者对服务器消息流通的分析,相当见功力。游戏的服务器端,可以抽象的看成消息的生产者和消费者的集合。每一个生产者 / 消费者,就是一个服务。skynet 的优势,在于提供了服务这个封装,一组功能相对独立的逻辑,可以组合在一个服务内,通过 skynet 转发通信,为其他服务提供相应功能。常见的消息生产者,包括和客户端通信、解包的 gate 模块,skynet 提供的 timer 定时驱动。服务就是对这些消息进行响应,并通过和其他服务的互动,完成自己的功能。
在这个基础上,作者抽取出了消息 pattern 这个概念。常见的模式有 C->Gate->S, S->Gate->C, S->Gate->C*。相对的,因为服务的存在,作者还引入了额外的 MQ,来处理服务间的通讯问题。同理,有 Service->MQ->Service, Service->MQ->Service*。
对于玩家存档的问题,作者抽象了一个数据服务来做这个事情。对应于烂框架的 DB 代理进程,只能用跟项目高度相关的 API 进行数据读取,数据服务提供了更高层的功能:剥离游戏服务状态。剥离状态后,从 skynet 的角度看,所有 agent、service,都是做一些简单的计算、比较、排序,最后数据都会存到数据服务上。这样的好处是,剥离了状态的 skynet,随便挂,不会丢数据,对用户透明。这个思路非常棒,但是进程间通讯的代价比 skynet 内服务间通讯要大,怎么避免服务间通讯引起频繁的数据服务通讯,是一个值得思考的问题。
作者对我启发最大的地方,是文末推荐的那篇 《The Log》,作者是 LinkedIn 团队的开发成员。写 Log 是一件非常简单和入门的事,看完 the log,却发现一直忽视了对 log 这种数据流的视角。文章字里行间,还透着点日志式数据库的意味。这篇文章比较长,核心思路是 Table 和 Change Log 是可以相互转化的,一个 Table 反映了当前的状态,而 Log 则记录了 Table 一路以来的状态转换。那么,只要有 Log,其实 Table 不再重要,因为只要我回放 Log,最终就可以得到 Table。** 这是一个有状态到无状态的转化 **!然后 Log 这一块可以交给成熟的中间件处理,LinkdedIn 是透过卡夫卡(Kafka)来完成的。消费者的消费速度慢?不要紧,无状态服务可以无限水平扩展。消息产生了消息链?没关系,丢回到 Log 中,下个周期再处理,完美!
顺便推荐一篇对 The Log 的引用文章,来自于 Yelp 团队:《billions of messages a day》, 里面对利用 Log 进行解耦作了更深入的剖析,对兼容 Log 格式变更也有自己的解决办法,有空可以看看
80 - 六月小结
六月的最后一天,解决了一个服务死循环的问题。吐槽下 skynet,既然已经可以检测到 endless loop,为什么不直接做个调试器去打出死循环在哪里?而且默认不自带超时功能,死了以后基本上服务统计的 gm 指令都挂了。要做超时的 call,还需要自己套个代理服务上去。
这个月将手头的系统都开发完了,开始进入修 bug 阶段。月中的时候接替同事,跟了一下玩法方面的代码,熟悉了玩法的代码结构。排行榜现在统一交到一个服务上去做了,这个服务会创建跟玩家一一对应的 role,然后每个 role 还能饰演不同玩法的角色,参与不同的排行榜。这个抽象不错,避免了不同玩法分别实现一套排行榜,目前排行榜的区别只是榜单的 key 不一样,榜单长度不一样,其他规则是相同的,所以能很好的合到一起。
另外,玩法开启的初期,为了激活用户活性,会导入机器人。策划将机器人的各个属性配好,就可以复用机器人。同时,基于排行榜的玩法也不用特殊处理,基本不需要区分是否机器人,直接按同样的规则去匹配人和机器人。这个统一的抽象也相当优雅,但是上次策划有特殊要求,每次搜索都提供机器人减少玩家挫败感,这个不知道怎么实现。让策划大量配机器人可以解决 XD
好困,滚去睡觉了 😪
EDIT:
好吧,skynet 是有打断死循环功能的。。。参考 https://github.com/cloudwu/skynet/wiki/DebugConsole,我滚去测试一下。。。
81 - 忙忙忙
最近都在加班,没什么好写的。每周六天,没事也要过来,有点崩溃。
邮箱、聊天之类的都做成信道,尽量和数据抽离开,由具体系统处理对客户端的数据转换,但是 orm 那块不够灵活。如果不走 orm,担心数据格式不对,直接用字符串保存的话,又丢了格式,以后运营的时候不好查找数据。
玩法堆了几个,成长系统比较多,光英雄的就堆了 5、6 个了。战斗力计算没时间去理清,虽然都是简单的读表处理,但是各个系统之间有交互,不知道现在这套接口够不够灵活,会不会坑爹。另外,还有一些 buff 之类的,一直只有客户端维护,之前服务器是没有考虑到的,不知道战斗力会不会需要 buff 叠加。
卡牌的投放还是一个没有定论的事情。究竟要不要经历一个卡牌到英雄实例化的过程,这个过程要不要暴露给玩家,还是没想好。策划们似乎能接受,投放卡牌的地方也不多,应该能改过来。
成长系统里,很多系统都非常像,就是消耗改一点,或者升级加一点随机元素,改一下不读条直接升级,不知道这是什么设计。
手头的奥义做完后,成长这一块算是结了。想给这一块代码来个总体的 code review,但是都是读一下表,改几个数字,没什么逻辑,又不知道从何 review 起,有点迷茫。
结论是还是要好好读完设计模式
另,在 kick starter 入了 pebble time 2,但是又口水 google 家的 Project Soli,不知道什么时候有新品上。google 家的语音助理也很吸引,控制全屋家电棒棒的
82 - 回炉重铸 - 设计模式的领悟
整个四月都在回炉重造之前的英雄成长系统,就因为决定换一个方向,累死。回头看看去年,没想到也是 4 月 30 号写的博客。。。
重造的过程里,同时在看《head first 设计模式》这本书。作者加了很多有趣的插图进去,以前是很讨厌这么做作的书,但是现在读来觉得没那么累,挺好的,可能是老了吧。。。里面提到的开放 - 封闭原则很有启发意义。以前写代码,写的很老实,不够偷懒,总是一字一句把策划的文案搬进去,抽象层次不够,搞的人很累。开放 - 封闭原则就教导,写代码应该对扩展开放,以后策划有新需求,只要在少数几处地方加个入口就行。对修改封闭这个倒是没有想好,策划总是在改案子,而且很多时候改动的幅度很大,怎么实现不修改没想好。目前是抽取了一堆工具函数出来,将策划的需求拼凑成一张表格,然后逐项检查,有新需求加新工具函数。
《head first 设计模式》里还提到了对象工厂和观察者模式。观察者模式用的还是蛮多的,玩家身上会挂一个类似公告板的东西,让各种玩法在上面注册主题。比如玩家升级,充值 VIP,发起一次战斗,战斗胜利,完成造兵等等,然后其他新玩法和成就系统就可以监听这些消息了。日常任务、成就系统前后做了两版,具体玩法的代码都不需要修改,这个观察者模式挺好用的。
对象工厂在程序群里其实还被喷过几次,我以前也觉得很多余,尤其是对于 Lua 这种动态语言来说。没有编译期进行检查,调用接口的代码不跑到就不知道接口对不对。不用工厂,多 require 几个文件,自己调一下 new,没什么区别。现在觉得,抽象一个对象工厂出来,更多是一种减轻心理负担的做法吧。如果一个玩法的文件,里面密密麻麻的 require 了一堆外部文件,看起来就有点头皮发麻了。现在搞一个 100 行左右的工厂,将需要的类都放进来,增加创建方法,那么相关玩法的头部就可以简化了。
83 - pythonsproto 支持 64 位有符号整数
小伙伴需要 64 位整数做物品的 id,之前 python sproto 的判断有问题,写篇日志记录一下。
之前有问题的代码是这样的:
这里有两个问题。一,long 只保证有 32bit(via wiki),有可能 data 是 64bit 的,这个时候就会丢数据。二,vh 的定义是 int,这里会丢数据。vh 是 i 通过位移得到的,目的是判断高位有没有数据,如果只有符号位有意义,就不用 64bit 存了,可以转到 32bit 里放数据。但是,我把 vh 强转成 int,这样刚好就丢掉了符号位,然后让次高位充当了符号位,这时候得到的数据是错误的。
现在改成了这样:
看起来没问题了 :)
84 - pysprotobug 修复
最近,找隔壁组的同学测试了一下我的 pysproto,他们提了很多有益的建议,非常感谢。
在测试中,出现了一次诡异的 coredump。当数据变大的时候,就有很大的机率遇上 double free。在 sproto 和 python sproto 插件里插了一堆打印点后,发现 sproto 在解包的时候报错了。但是 unpack 的代码相当简单,下意识忽略过去了。找云大侠看了一下数据,发现的确有个长度数据错了。至于是在哪一层出错了,还是要再找找。接着我们尝试了直接用 lua 版的 sproto 解包和打包,都没有问题。包的收发也是在单机进行的,不存在问题。于是又绕回到 unpack 上去了。仔细想想,数据越来越大的时候才会出问题。有可能跟默认缓冲区的大小有关,这个大小设置为 1024 了,难道 Realloc 的时候出错了?
放狗搜索了一下,发现 Realloc 的用法的确有问题。对于内存已满的情况,没有做出错处理,之前的指针也被覆盖掉了,造成内存泄漏。改好这一块后发现,为 sproto_unpack 传入新的缓冲区的时候,忘记更新缓冲区 dstsz 这个变量了,导致缓冲区足够大,而 sproto 会认为不够。。增加单元测试后已修复~
85 - 最近设计的反思
最近完成了邮箱的功能。
邮箱的设计参考了 mmzb 的设计,基于一套 msgsrv 来实现。msgsrv 是一个消息中转的服务,这个服务是为了简化玩家之间消息传递的过程。比如邮箱要向一个离线玩家发信,为了避免对离线玩家的数据进行修改,会通过 msgsrv 发送到玩家对应的 msgbox 里。玩家上线后,会自动查询自己的 msgsrv,检索未读消息。当玩家上线时,会主动在 msgsrv 中发起订阅。每当有新的消息进入,msgsrv 会直接发送到玩家所在的 agent 上,实现实时通知。唯一例外的情况,是全局消息的发送。一条全局消息发送的时候,只是向一个全局的队列里插入一份数据。玩家只会在登录时检索一次这个全局队列,并记住自己的检索位置。缺点是全局消息的通知不及时,需要玩家离线再上线才能收到。需要实时的消息,可以通过聊天系统解决。
这个设计相对来说还是比较简单的。但是,这个功能的提交,涉及到 46 个文件。我提交 Pull Request 的时候,自己都惊到了。当然,这其中并不是全部都是代码的修改。这些修改可以简单的分为三块。一块,是配置之类的修改,比如新增服务的参数,新增服务的数据存储对应的数据库定义,玩家数据库对象新增的结构描述。这里占了 7 个文件。第二块,是在 lualib 里提供的新 api,为其他服务提供新功能的入口。其中还包含一些趁手的工具函数,方便以后功能的开发。这里占了 8 个文件。第三块是大头,实现了 msgsrv 的逻辑部分,以及邮箱的业务代码。这一块有 31 个文件,是这个 PR 的主要部分。
除了玩家自身的成长系统外,其他系统基本都涉及到两部分。一部分,是挂在玩家的 agent 身上的,另一部分,则是对公有数据的修改。先看看 agent 的部分。agent 身上需要有对应服务的 api,供客户端通过 sproto 协议来远程调用。还需要有对应的 api,供相应的 skynet 内服务的调用。一般还会有一套额外的 gm api,供客户端进行测试的时候使用。这三组 api,功能覆盖的面差不多,最终都会操作玩家身上的数据,通知到玩家的客户端。就这次提交的邮件 PR 来看,这些 api 占住了 7 个文件。玩家数据部分的管理,是由几个类完成的。这里占用了 3 个。总的来看,agent 身上一共改了 15 个文件,稍微有点多。
剩下的文件,集中在对公有数据的修改上,即 msgsrv 的主体部分。其中有 4 个是用于执行功能测试的测试脚本,暂且不提。剥开 msgsrv,首先是一层 command,然后是对全局消息的管理器,对个人 msgbox 的管理器,对这两者的管理器,以及管理 msgsrv 服务的启动脚本、退出脚本、gm 指令。这里的优化空间应该比较大,按照 CRUD 的四字法划分,个人消息管理器和全局消息管理器都有着多个 R,多个 U,正交性不够好,还要锤炼一下。
优化现有的设计,主要目标是希望修改能够更简洁而清晰。不再因为添加一个小小的功能,就产生数十个文件的修改。对我来说,涉及的文件数量太多,就经常记不住细节,导致 api 改动的时候,常常出现漏改漏测。目前看到的可以优化的地方,就是各种自发现。比如 lualib 里面提供一个通用的调用 api 封装,只要传入方法名和服务名,就能自动调用对应服务的 command api。数据结构的定义,能够实现自动发现,不需要修改引用文件。(待续)
86 - 服务器被发现存在未授权访问
今天下午,友商的同学突然发了个确认信息过来,让我们确认一下服务器的归属。然后就抛出了个大新闻:我司服务器存在问题,所有文件都可以任意访问。根据对方反映的信息,确认是之前玩票性质的一个项目:avalon 出了问题。https://github.com/ejoy/avalon/blob/master/lualib/staticfile.lua#L12-L17 这里没有做输入检查,就直接使用 io.open 了。
另外一个地方,是因为这个项目的玩票性质,所以 SA 同学随便找台空的服务器丢上去了,而且还用了根用户,于是所有文件都泄露了。。。本来这个也问题不大,avalon 的代码本来就是开源的,但是这台空闲服务器是测试服务器之一,于是上面还有几个私钥。。。简直是墨菲定律的绝佳例子!友商的原话:遍历了 ssh 私钥、hosts 文件、passwd 文件、shadow 文件、crontab 文件、iptables 文件、bash_history 文件等。触目惊心 =_=|||
经过这次事件后,希望能够对 docker 的推广起到推动作用。通过虚拟化实现应用间隔离,web 应用输入检查要做好,外网服务器不存放私钥。还有相应的一套管控体系,包括用户登录行为检测,登录 ip 异常告警(非内网 ip 登录)等等。。另外就是,其实没必要自己撸代码啊,撸也只要撸业务层就好,静态文件交给 nginx 啊喂
87 - RRDtool 简介
最近公司换了办公地址,新厂址的宽带质量不怎么样,于是用 RRDTool 布了一套网络质量监控的系统,来定位公司内部与机房的连接问题。RRDTool 是一套经典的工具,前身是 MRTG,因为其中的性能有所不足,绘图的灵活性不够,于是作者 Tobias Oetiker 又重新开发了一套 RRDTool。这套工具包含了日志记录和图表绘制两部分,可以满足各种指标监控的用途。
RRDTool 的 RR,指的是 Round-robin,
88 - 折腾域名的 dns
最近,购买域名的时候遇到了几个概念,刚开始不是很懂,最后都是直接找客服给我改好的,现在小结一下帮助理解。
DNS 域名管理是按后缀进行分组的,比如 .com 域名,作为最早的商用域名,有很高的推广价值。再比如各个国家的顶级域名,例如中国的 .cn,加拿大的 .ca,简单易记。我们购买的,是通常意义上,www 与顶级域名之间的部分,叫二级域名。
二级域名会挂在某个根域名下,各个根域名会分给各个承包商进行承包,各自销售。其中有个国际组织在掺和,叫 Internet Corporation for Assigned Names and Numbers (ICANN),负责协调域名包销相关事宜,所以每笔域名交易也要抽点水。
DNS 最主要的作用,在于用一个简单可记忆的字符串,代替一串无规律数字的 IP 地址,方便人们上网访问。对于一般的网站,我们添加两条 A 记录就好了。第一条 A 记录的 Host 域填 @,表示域名就是以二级域名开始。IP 地址就填入 VPS 对应的 IP 地址即可。第二条 A 记录的 Host 域是 www,表示用 www.yourname.info 访问时,应该查询哪个 IP 地址。我比较懒,www 都不想要,就可以设置 301 重定向,定位到 yourname.xxx。
另外,域名商一般都有自己的 DNS 服务器,如果懒的话可以直接用。追求国内访问速度的,可以试试 DNSPOD,据说效果拔群。域名商开始时会给内置几条记录,用来把刚买下的域名指向自己的宣传页。里面有一个是 CNAME 记录。CNAME 记录用来做什么的呢?还是用来偷懒用的。假设我有 ftp.example.com,ssh.example.com,media.example.com,如果我的主机 IP 地址变了,我需要改三次。如果我设置了 CNAME 记录呢,ftp、ssh 和 media 三个子域名都指向 example.com,那么我只要改 example.com 指向的 IP 地址就好了,其他都不用改,完美!
还有一个比较好玩的是 TXT,可以用来写一段话,比如对域名的简介。当然,现在这个域给机器人用的比较多,比如 Google 家为了让你证明自己拥有这个域名,会让你添加一条 TXT 记录,内容是一个随机字符串,然后再核对是否设置成功。
89 - 2015 年终总结
2015 年是我第一次感觉人生过得快的一年。这一年买房了,月供比较重,有种喘不过气的感觉。15 年的阅读量比 14 年少,主要是网络小说看的少了,人文类的阅读量上来了,比较耗费时间。另外,15 年计算机专业的书读的很少,那本《redis 设计与实现》还没看完,有点遗憾。15 年开始思考一些大问题,比如两性平等,科技进步带来的发展,比如文明发展为什么不均衡,主体与客体,人为什么会感觉愉快。
15 年的博客写了 18 篇,比 14 年的 15 篇多了一点点,基本维持在每月一篇到两篇的节奏,但是文章的质量相应有所下降。可能是去年对计算机探索的欲望减少了,空闲的用来玩代码和看新玩意的时间也少了。回顾博文,发现 11 月 -12 月和年初的 4 月真是事故高发期。。。去年出现了一次玩家回档事故,一次停服维护事故,影响还是比较大的,运营抱怨说日活跃玩家掉了好多。空余时间基本是在玩树莓派,云风的 sproto 相关的工具,bt 的私下玩的比较多,思绪繁杂,只写了草稿,没发文章出来。
16 年希望能够发掘更多的金钱来源,让生活过的宽裕一点。身边很多朋友的博客都停更了,我希望我能够坚持下去。计算机方面,可能是毕业的时间久了,很多底层的东西没有耐心去研究,太浮躁了,热门技术呢,服务器这块还是用的比较少的,不像前端、移动端,新语言新工具层出不穷。2016 年希望对网络底层,特别是 TCP/IP 这一块,能够搞懂一些,跟 SA 吵架的时候,能够理直气壮的说出问题所在 XD。另外,对多核的利用和性能测量,也盼望能有点小进步,掌握一点 CPU 和内存这套核心系统的性能优化技巧。然后开个自己的小网站玩玩,通过实际业务来掌握网站优化知识,可能到时候分享站长相关的东西会比较多。
90 - mmzb 游戏事故分析
最近一次线上更新,老项目挂了,遍地哀嚎,日活跃掉了好多,心痛。。。
这次维护时,SA 为了缩减硬件资源,做了一次数据库迁移。给到开发手上的 player db,只有一些索引数据,不带有任一玩家数据。玩家上线的时候,skynet 自动从 redis-persist 服务中拉取(redis-persist 是一个基于旁路监听的 redis 落地程序,相对独立,参见 之前的博文 )。这也是 RP 服务的第一次高强度使用。按之前的策略,每次玩家下线都会在 RP 服务中存档,三个月不上线的玩家,会自动从 redis 数据库中移除,以节约内存。当流失玩家再度上线时,skynet 先从 redis 中直接查询,无法加载到玩家的话,再度从 RP 服务中拉取,可以简单的将 RP 服务视作 redis 的一个二级缓存。玩家下线后,数据继续在 redis 中保留三个月。所以,设计之初,RP 服务就是作为一个低频服务存在的,没有考虑到大量加载玩家的情况。
这次开服前,SA 有同步到这个情况,我们以为只是玩家上线登录会慢一点而已,结果换来的却是惨痛的教训。上线后,因为 redis 里面空空如也,而各种排行榜和群雄逐鹿玩法,需要拉取玩家的基本信息,诸如名字、uid、等级、公会、性别等等基础数据。这是依赖于一个 profile 服务实现的。而 profile 加载玩家信息的接口,又跟玩家登录所用的接口不一样,没有实现从 RP 服务中加载。这是当时 RP 服务上线时,特地干掉相应接口的,因为当时已经考虑到 profile 服务会是一个高频访问,容易压垮 RP 服务。在策划的再三要求下,开发迫不得已把这个接口加回去,免得玩家信息空白。结果,上线一个小时左右,skynet 就因为占用内存太大,直接挂掉了。
事后分析,应该是 profile 服务太慢了,需要一个个从磁盘上加载玩家数据,虽然自身有缓存,但是压上来的请求数量太多,请求也没有做去重(比如同一个 uid,只对 RP 服务发出一次请求)。返回结果时比较缓慢,玩家就直接退出重新登录,之前查询到的数据作为临时表,已经没有接收者了(原有的 session 已经消失),于是变为 GC 的压力,最后把系统压垮了。再次启动上线后,关闭群雄逐鹿玩法,希望能减少 profile 服务的压力,结果轮到战斗搜索出问题了,线上搜索玩家进行攻击,依赖于 redis 里的数据,由于 redis 里玩家太少(只有刚刚登录上的),无法搜索到有价值的对手。开发这边就通过运营导出最近玩家数据,将热玩家数据重新导入 redis 里,解决问题。
这次事故里,profile 服务因为单点故障,备受诟病。但是,从一个高度依赖 redis 内存数据库的服务器里,转到主要依赖磁盘的数据库上,这个改动就不是一个小改动。不止 profile 服务,还有其他服务也依赖于 redis 数据库(比如战斗搜索),正因为 redis 的访问代价低,代码里的 cache 和预加载就可以少写一点。如果相关玩法的假设是,数据都从磁盘加载,排行榜和群雄逐鹿玩法就可以先单独从磁盘上加载好自己要用的玩家数据,不需要依赖 profile 服务了。相反,SA 部署新的 redis 实例的时候,将那部分热门玩家先加载到内存中,让 skynet 直接在 redis 就可以取到数据,不需借道 RP 服务,也可以解决问题。往后这数据加热,还是应该自动化完成,只是先前数据都在内存,不需要加热,就没这个问题。
退一步说,假设各个玩法依然从 profile 里加载基本信息,如果 profile 服务可以过滤重复请求,就可以释放掉 RP 服务的压力。这时候,压力就集中在 profile 服务的消息队列上了,由于磁盘加载速度慢,依然会有大量的请求积压。云风曾经提过 一个 skynet.call 的超时处理方案 ,如果这个方案再改动一下,发现某服务大量积压请求时,自动随机抛弃新请求,profile 服务就可以得到解放了。
91 - 为 sproto 手写了一个 pythonparser
这是 sproto 系列文章的第三篇,可以参考前面的《 为 sproto 添加 python 绑定 》、《 为 python-sproto 添加 map 支持 》。
这么简单的结构,正好拿来练手写 parser。Lua 的 LPEG 库实在太强大,于是先试了一下 pypeg2 去解决这个问题。尝试的过程参见:https://github.com/spin6lock/sproto_python_parser,最后失败了。回想了一下,PEG 文法其实跟上下文无关文法相当类似,只是不存在二义性,能够通过一个 token 来完全决定接下来的解析树。这个跟递归下降法有点类似了,便顺手撸了一发:https://github.com/spin6lock/yapsp
代码主要分成两部分,lexer 和 parser。lexer 辨别的 token 可以参见 常量定义 ,基本上用正则表达式搞定了,只花了一点点时间。Parser 多花了好一段,主要是忘了要封装一些方便的函数出来使用,比如 expecting 和 optional。Parser 实现的是一个基于递归下降法的语法分析器,由于 sproto 的语法特别简单,所以可以透过窥视下一个 token,便知晓接下来要解析的是什么结构,然后调用相应的方法解析即可。
92 - Lua 小技巧
来公司以后,业务逻辑都用 lua 写。写了好长时间了,到最近才觉得有点掌握了 Lua 的灵活。最近用 Lua 写了个类似集合一样的东西,如果两次向集合里放入同一个元素,就会报错,方便检查配置。代码如下:
由于 Lua 的 __index hook 不完整,只有在数据不存在的时候,才会索引元表的 __index,所以需要将数据藏起来。之前是用一个 key 为 data,value 是空表的子表去存实际数据,这样做会有一个隐患,当塞进去的 key 是 data,就会把其他数据覆盖掉。后来同事提醒,可以用 upvalue,先声明一个本地 table m,然后在元表方法里引用之,这样外层就不会误改数据域了。要找回 m,可以从元表中查回来。
93 - Techparty- 广州 10 月 31 日 Docker 专场沙龙后记
华为的童鞋技术能力很强,但是两位讲师的都没听进去。重点听了两个,一个是芒果 TV 的 Docker 之路,另一个是 Coding 的实践和思考。
芒果 TV 的主讲人是一直仰慕的 CMGS,从豆瓣出来后去了国企芒果台。因为内部阻力问题,无法实现 PaaS。转而实现了细粒度的调度。物理机 +Docker 为芒果台省了不少机器,而且性能还比 AWS 的要强。实践上,主要用到了 MacVLan,在二层网络上做网络调度。还有 Devicemapper,但是 dm 受镜像大小的影响比较大,超过 2G 大小的镜像就会有明显的性能下降。Docker 里跑的,主要是 Redis cluster。80G 的 redis 实例,分成了 80 个 1G 的 instance 来跑,分别错开 AOF 时机,避免触发 OOM。网络设置用的是 Eru-agent,自己开发的私货,同时负责监控。Docker 自带的监控在早期版本里,一直是个脑残,每秒取一次 metric 数据,严重影响性能。
Coding 的主讲人是叶雨飞。叶大吐槽了 Docker 的种种缺点,registry 废柴,dockerfile 和部署用的配置混为一谈,hub 上的镜像良莠不齐。然后鲜明的提出了三点:Build-Package-Run。对于运维人员来说,应该做的是运行一个 build.sh,然后把 packagebuild 出来。具体怎么 build,应该交回各项目自我管理自我实现。叶大现场还列举了 3 行的 dockerfile,实在是大开眼界。底包由内部每天更新,然后第一行 FROM 当日更新好的底包,第二行 add 相应的包,第三行直接 run 包。叶大对动态伸缩也有明确的认识,一般公司都用不着,很多东西可以依赖原有的部署系统实现,不需要另搞一套。灵活性越高,需要的额外工作越高。容器只是当作物理隔离用的东西,就够用了。镜像的 locale,timezone 之类的,甚至可以直接依赖宿主机。当然,也要保证镜像能够包得起,挪得动,可以封装物理机之间的差异,不会依赖某台特定物理机来跑业务。
具体的 ppt 还是要等 珠三角技术沙龙 的官网了
UPDATE:
94 - 1password 密码库格式更新
由于国内网络安全做的太差,经常发生被脱裤的事件,比如最近的网易邮箱(via 乌云 ),所以只好用 1password 这类密码管理软件,实现一站一密。昨晚半夜冻醒了,刷推刷到了这个:1password-leaks-your-data,整个人吓醒了 =_=# 作者有点标题党,脱水版可以参见 reddit 的 这篇文章 ,大意是 1password 的旧密码库格式叫 agilechains,大体是 json 结构,里面只有密码是加密的,密码项的名字和 URL 并未加密。官方提到历史原因,早期计算能力弱,只好加密关键部位。官方推出的密码库更新指南在此:Switching to OPVault format
但是,今天折腾了大半天,发现官方指南其实并没有考虑到同步的情况。我在 Win,iOS,以及 Mac OS X 上都有使用 1password,使用 dropbox 进行同步。官方对新的数据格式 OPVault 有版本要求,所有设备的 1password 都需要升级。升级完成后,官方没有办法直接转换到 OPVault 上来。需要先导出一个纯文本 1pif 格式,完全不带加密,然后创建一个新库,选择新的 OPVault 格式,再导入刚刚的 1pif 文件。因为之前已经有和 dropbox 同步,于是 1password 就自作主张将 dropbox 目录里的老库和新库合并,结果所有密码变成两份。。。由于 Dropbox 的版本控制只针对文件而非目录,我还要一个一个文件的回滚,崩溃了。。
以 win 平台为例,正确做法应该是这样:先停掉 dropbox 的同步。删掉 dropbox 里的备份文件,如果是 iOS 创建的 Dropbox 备份,文件位置在 Apps/1Password/1password.agilechains。然后创建新的密码库,格式选择 OPVault,文件保存在 Apps/1Password/1password.opvault。将原来的主密码库导出一个纯文本 1PIF 文件,然后删掉原来旧格式的主密码库,如果 UI 没有提供接口,就退出 1password,直接搜索所有的 1password.agilechains 来删除。删除时,注意使用 Eraser 来清理数据,不然就会犯陈冠希老师的错了。在新格式的 OPVault 里导入原来的 1PIF 文件,大致检查一下数量对不对,有没有漏的,没有的话就可以用 Eraser 将这个最容易泄密的 1PIF 干掉了。一切准备停当,可以打开 dropbox 同步,dropbox 这时候应该自动将新密码库上传上去了。
win 平台处理完,其他平台可以参考同样流程。不要依赖 1password 自己的同步,只要记住文件到了,密码库就在手上,利用 dropbox 完成同步即可。先把 iOS 的卸载掉,再重新安装,选择我是已有密码库的用户,导入 dropbox 里的密码库就搞定了。Mac OS X 稍微有点麻烦,直接删除 app 不会删除备份,而且貌似 1password 5 是使用了 sqlite 来作本地数据缓存。我们需要在 Finder 里,前往文件夹 ~/Library/Application Support/1Password 4, 删除里面的数据。最新的 OS X EI Capitan 取消了安全清除废纸篓,可以用命令行的 srm 代替。然后再打开软件,就可以像 iOS 一样,选择已有的密码库来操作了。
95 - SSL 加密与系统时间
最近,家里的神州老笔记本没电池了,要拆 C 面才能换主板电池,懒得动手,于是搞了个 Network Time 来做对时。主要是未搞对时之前,所有 https 的站点都用不了,老人家也抱怨炒股不行,崩溃了。。。这时候才知道,原来证书也是要验证时间的。
在 SSL 会话里,客户端需要验证服务器的身份,这是通过证书检查来完成的。证书验证中,会涉及跟时间相关的两点:
- 服务器的证书(及涉及到的其他证书)的有效验证时间需要包含当前时间。每个证书都有 notBefore(不早于)和 notAfter(不晚于)字段,当前时间必须落在这两者之间。
- 客户端需要验证证书的撤销情况。这是通过从 CA 获取 CRL(证书撤销链)来实现的。一个 CRL 只有在不太老的情况下才算是可接受的。同样,CRL 有 thisUpdate 字段,标记 CRL 生成时间,以及一个 nextUpdate 字段,大致相当于 CRL 的过期时间。
证书签发的过期时间对客户端的安全十分重要。假设服务器不幸被攻破,私钥被偷。通过 CRL 和证书自身有效期,大家可以及时修正泄密证书,防止被泄露的证书进行中间人攻击。所以,当主板电池挂掉的时候,安全往往难以受到保障。。
参考链接:What role does clock synchronization play in SSL communcation
96 - python 和 nodejs 的 aes128 加密对比
之前的机器人是用 python 写的,有同事想改写成 nodejs 版,但是验证一直通不过,于是帮忙爬了一下文档。
但是有个问题,nodejs 版加密出来的密文,总是比 python 版要长。感觉 nodejs 最后的 final 方法,输出了多余的东西。参考了一些网文,如果密文不够一个 block,update 是没有输出的,如果超过一个 block,update 只会输出一个 block,剩余的放在 final 里返回。用 python 版解密看了一下,原来 final 在密文刚好一个 block 的情况下,会返回 padding 字符串。。。。
97 - 9 月补记
9 月份本来打算搞一下 bt,可惜一直没时间完成种子下载的部分,暂此搁笔。
由于 XcodeGhost 肆虐,于是顺手搞了个 XcodeGhost 的服务器版:https://github.com/spin6lock/XcodeGhostServer,联系 SA 帮忙指向本机,结果公司里大家都更新的好快,只发现一位同学中招 :) 只是弹窗还有点问题,JSON 里面的字段都有了,不知道是不是 scheme 不对,所以 openUrl 的时候有问题,稍后再看看。
XcodeGhost 的三个域名:init.icloud-analysis.com init.icloud-diagnostics.com init.crash-analytics.com 【 来源参考 】
回顾了一下 XcodeGhost 的代码,canOpenURL 返回 No 就会自动 return,无法弹窗。理想的处理办法,是根据染毒的 app,分配特定的 scheme。但是如果对方是 ios9 以下,可以偷懒将 scheme 改成 wechat,统一跳转到微信。
99 - 旧梦重温
这个月主要在搞两件事,其一是:https://github.com/spin6lock/pydnsproxy,其二是一个 bt 客户端,用来搜索磁力链接,下载种子的,还没搞好。
除了 bug 修复,就是给 pydnsproxy 添加了 http dns 的解析方式,这种方式的优势,可参考企鹅的 【鹅厂网事】全局精确流量调度新思路 -HttpDNS 服务详解 。简单来说,就是抛开原有的 dns 协议,直接提供一个 http 接口,给出域名,返回对应 ip。额外参数还包括请求 ip,可以根据请求 ip 的不同解析出不同的 ip 地址。暂时看来,没有受到墙的干扰,可以一用。说到底,其实需要的是一根管道,可以顺利到墙外而不受干扰。具体的解析方式,反倒是其次了。像企鹅这种大公司,维持一条稳定的加密通道毫无问题,于是顺便利用其 httpdns 来避免投毒污染了。实现的时候,有考虑过 tcp 连接池的问题,貌似 urllib2 没有这么高级的功能,只有 urllib3 才提供 PoolManager。但是,实测发现,httpdns 的查询也就在 20ms 附近,虽然比缓存的 5ms 要慢一点,但完全可以接受,这个值得再观察一下。
100 - 树莓派改用中山大学软件源
**** 最近借了同事的第一代树莓派来玩,主要是想试试玩 SDR,之前听说可以上传一个月的航班广播(ADS-B 广播信息)就可以获得永久资格,随时查阅附近有什么航班飞行。后来发现 flightradar24.com 已经升级规则了,要持续上传数据。。。于是打算听听收音机算了,上手装了 raspbian,毕竟 debian 系统比较熟悉。国内网速着急,先换个源
** 使用说明 ** 编辑 /etc/apt/sources.list 文件,参考如下命令:
注释原文件所有内容,用以下内容取代:
编辑镜像站后,执行:
更新软件源列表,同时升级软件包。
101 - 翻译 lpeg 入门教程
原文地址:http://lua-users.org/wiki/LpegTutorial
简单匹配
LPeg 是一个用于文本匹配的有力表达方式,比 Lua 原生的字符串匹配和标准正则表达式更优异。但是,就像其他任何语言一样,你需要知道简单的词汇和如何组合他们。
最佳的学习方式,是通过交互式对话,熟悉基本的模式。首先,我们定义一些缩写:
如果你不想自己创建缩写,你可以这样写:
我不建议在工作代码中这样写,但是在探索 LPeg 的时候,则不妨试试,十分方便。
匹配是从字符串的 ** 起始点 ** 开始,如果匹配成功,则返回成功匹配子串的后一个位置,或者返回 nil。(这里我应用了一个简写:f'x' 在 Lua 里等价于 f('x') ; 单引号和双引号等价 )
看起来就像 string.find 一样,除了只返回一个索引。
你可以选择按 ** 范围 ** 匹配或者匹配一个 ** 集合内 ** 的字符 :
要匹配超过 1 个子串,可以用 ^ 操作符。 在这种情况下,匹配与 Lua 的 ‘^a+’ 等价 - 匹配一个或多个 ‘a’:
要按顺序合并模式(pattern),可以通过 * 操作符。 这等价于 ‘^ab*’ - ‘a’ 后跟着 0 个或多个 ‘b’:
到目前为止,lpeg 只是为我们提供了一个更为灵活的方式去表达正则表达式,但是这些模式是可以 ** 组合 ** - 他们可以由简单的原语组成,避免艰深的字符串操作。因此,lpeg 匹配可以比等价的正则表达式表现得更为易读。注意,你可以在构造 pattern 的时候保留显式的 P 调用。尤其是其中一个参数已经是一个 pattern 的时候:
+ 操作符表示 ** 任意 ** 一个 pattern:
当然 , S'ab'^1 会更简短 , 但这里的参数可以是任意的模式。
基本捕获
获得 match 后的位置非常有用 , 你可以随后用 string.sub 来取出匹配串。 不过,我们也有显式的方法直接获取子串 ** 捕获 **:
第一个就好似 ‘(…)’ 在 Lua pattern 里一样,( 或者正则表达式里的 ‘(…)’ )
所以要获得字符串,我们需要用 C 包裹模式。
这个模式没有覆盖到广义上的整型。因为整型可能包括 ‘+’ 或者 ‘-’ 出现在前面 :
不像 Lua 模式或者正则表达式,你不需要担心元字符的转义 - 字符串中的每一个字符都只代表自身 : ‘(’,’+’,’*’, 之类都只匹配他们在 ASCII 码表达里的同类。
有一类特殊的捕获,需要用到 / 操作符 - 他会将所有匹配的子串丢给一个函数或者 table。 这里我会向结果加 1,用来演示结果已被 tonumber 转换成 number:
注意,一个匹配也可以返回多个捕获 , 就像 string.match 一样。 等价于 ‘^(a+)(b+)’:
构建更为复杂的模式
考虑到更为常见的浮点数 :
这个 Lpeg 模式比正则表达式 ‘[-+]?[0-9]+.?[0-9]+([eE][+-]?[0-9]+)?’** 简单 ** 得多。越短越好嘛!其中一个原因,是我们可以将模式表达为 ** 表达式 **: 抽取出常见的模式 , 编写相应的函数来提高可读性,让模式使用起来更方便。另外,这样写并没有任何代价;lpeg 依然可以高效的分析文本!
这些基本构件可以组成更为复杂的结构。例如分析一个列表的浮点数。一个列表是指一个 number 接着 0 个或多个逗号和 number:
这样很酷,其实还可以更酷一点,直接将其转换为真正的列表。这就是 lpeg.Ct 长处所在; 它可以将所有的捕获归集到一个 table 里去。
默认的 Lua 不能直接打印 table,但你可以使用 [? Microlight] 来完成这个工作 :
这些值依然是字符串。最佳实践是定义一个 listf,让它转换成 number:
这种捕获列表的方法非常普遍,你可以将 ** 任意 ** 表达式放到 floatc 的位置上去。 当然,这个列表匹配还是有局限性,一般我们都希望能够直接忽略空格。
这里有个品味的问题,我个人喜欢将空格的匹配和 ** 匹配项 ** 写在一起 , 而不是和 ** 分隔符 ** ‘,’ 写在一起。
通过 lpeg, 我们就能成为基于模式编程的程序员,并重用模式 :
所以,一个列表的识别码可以这样写 ( 按平常的写法 ):
使用显式的 range 好像很老土,并且充满错误。一个更可移植的方案,是使用 lpeg 里的 ** 字符类 **, 字符类是独立于 locale 设置的 :
给出 列表 的定义 , 就可以定义一个常用 CSV 格式的子类 , 其中每条纪录都是一个列表,列表之间用换行符分隔 :
学习 lpeg 的其中一个理由,是 lpeg 的表现十分令人满意。这种模式匹配 lot 比使用 Lua 的原始字符串匹配要快得多。
字符串替换
接下来,我会演示给大家看,所有 string.gsub 可以做的 lpeg 都可以做,并且更具有一般性,更加灵活。
目前有一个操作符 - 是尚未展示过的 , 它可以表示 ’ 任一 / 或 ‘。 考虑双引号字符串的匹配。在最简单的情况下,一般是一个双引号接着其他不是双引号的字符,最后接上一个封闭的双引号。 P(1) 匹配 ** 任一 ** 单个字符 , 就好比字符串模式里的 ‘.’ 。 一个字符串可以是空的,于是我们应该匹配 0 个或多个非引号字符:
或者,你需要的是捕获字符串里的内容,不包括引号。在这种情况下,只要使用 1 来代替 P(1) 就好,而且这是一个比较常见的表达 ’ 所有不是 P 的 x’ 模式:
这种模式可以简单的普及到其他情形里去;结束符(结束模式)不一定是最终的模式:
现在,我们来尝试下把 Markdown 代码块 ( 反斜杠包裹的文本 ) 转换为 Lua wiki ( 双花括号包裹的文本 )。 最显浅的办法是抽取出字符串并连接成最终结果,但是这看起来很蠢,而且极大的限制了我们的选项(下文将解析这点)。
我们之前曾经用过 / 操作符,使用 tonumber 函数来转换 number。 它也有跟 string.gsub 极为相似的格式,比如 %n 表示第 n 个匹配。
这个操作可以被表达为:
优势是我们不在需要写自定义的字符串模式,并费神去转移元字符如 ‘(’ 和 ‘)’。
lpeg.Cs 是一个 ** 替换捕获 **,并提供了一个更一般化的全局字符串匹配模块。 在 lpeg 手册里, string.gsub 有这样一个等价的替换:
要理解其中的区别,可以看看只使用单纯的匹配 C 是怎么使用的 :
这里的 C 捕获了整个匹配,每一个 ‘/’ 增加了一个新的捕获,捕获的值用替换字符串代替。
而使用 Cs, ** 所有匹配 ** 都被捕获,最后组成一个字符串。其中一些捕获会被 ‘/’ 所修改,所以我们能够获得替换过的字符串。
在 Markdown 里,区块行以 ‘> ’ 开始。
这不是那么正确 - Cs 捕获所有东西 , 包括 ‘> ‘。 但我们可以强迫部分捕获返回空字符串: }}}
现在一切都可以正常工作了 !
这是最终用来转换 Markdown 文档到 Lua 维基格式的代码 :
因为这篇维基的转义问题,我需要在这个文本里将 ‘{’ 替换为 ‘[’ 。请注意!
SteveDonovan, 12 June 2012 – 翻译 : @spin6lock
组捕获和反向捕获
本节内容将剖析组捕获和反向捕获 (Cg() 和 Cb() )。
组捕获有两种: 命名式及匿名式。
我们先看看简单的部分:table 捕获里的命名组。
在表捕获里,第一个捕获的值 ("bar") 会被分配到对应的 key ("TAG") 里去。 就像你看到的那样, Cc"baz" 丢失了。 label 必须是一个字符串 ( 如果是数字,则会被转换为字符串 )。
注意分组必须是 table 的一个直接孩子,否则 table 捕获不会处理 :
捕获和值
在深入研究分组之前,我们需要探索一下捕获如何处理他们的子捕获。
有些捕获是操作它们子捕获的值,有些则是有时候这是反直觉的。
我们看看以下这个例子 :
就像你看到的一样,它把三个值插入了
我们把它用 table 报装一下:
Ct() 作用于值上面。 在上一个例子里面,
现在,我们试试替换捕获 :
Cs() 在捕获上操作。 它扫描第一层的嵌套捕获,并只取每个捕获的第一个值。在上述的例子中, "b" 和 "c" 因此被抛弃了。这是另外一个更清晰的例子:
其他章节里会更具体的讲述根据值捕获和根据行为捕获的区别。
捕获的不透明性
另外一个重要的事情,大部分的捕获会抑制他们的子捕获,但不是所有都这样。就像你上一个例子看到的,C"bcd" 的值被转到 /function 捕获里去,但最终捕获列表里不会出现。Ct() 和 Cs() 在这种情形下也是透明的。他们只产生一个 table 或者一个字符串。
另一方面, C() 也是透明的。正如我们上面所看到的,C() 的子捕获也会被插入流中。
唯一透明的捕获是 C() 和匿名的 Cg()。
匿名组
Cg() 将子捕获包装到一个单独的捕获对象里去,但不产生自身的任何产物。根据上下文不同,要么它产生的所有值都被插入,要么只插入第一项。
这是匿名组的一些例子:
这些行为有用吗? 在折叠模式捕获里有用。
我们来写一个非常简单的计算器,用来加上或减去一位数的。
捕获树看起来是这样的 [*]:
你可能已经看出来是怎样一回事了。。。就像 Cs() 一样, Cf() 操作捕获对象。 它会抽出第一个捕获的第一个值,然后作为初始值。如果没有更多捕获,这些值就会成为 Cf() 的值。
但我们有更多的捕获。在我们的例子里,它会将第二个捕获(组捕获)的所有值传给 calc(),紧跟第一个的值。这是上面 Cf() 的运算过程
[*] 实际上,在匹配的时候,捕获对象只存储他们的边界和额外的数据 ( 比如为 Cf() 储存 calc() )。实际值会在匹配完成后依次产生,但是,它可以让代码变得更清晰。在上面的例子里,嵌套的 C() 和 Cg(C(), C()) 是每次输出一个,对应到折叠过程里自身的循环中。
命名组
命名组 Cg()/Cb() 跟匿名组 Cg() 有类似的行为,但 ``Cg() 捕获的值不是在局部插入的。他们在 Cb() 的位置插入流中。
举个例子 :
如果有超过一个 Cb(),就会有副本产生。 另一个例子:
为了让代码更清晰,我一般会将 Cg() 命名为 Tag()。 我会在匿名组里使用前者,而在命名组里使用后者。
Cb"FOOO" 会往回查找一个成功的 Cg() 匹配。它会在捕获树里往回和往上查找,并消耗对应的捕获。换句话说,它会搜索比自己更年长的兄弟,以及父母的兄弟,但不会搜索自己的父母。也不会查找他们祖先的兄弟的孩子。
它是像下文一样运行的 ( 从 [ #### ] <--- [[ START ]] 开始,并随着数字回溯 )。
[ numbered ] 是按顺序测试的捕获。 用 [ ** ] 标记的则不是,原因见下。有点千头万绪,但是在我能考虑到的范围里是完备的。
PierreYvesGerardy 翻译 by:@spin6lock
RecentChanges preferences edit historyLast edited May 24, 2015 11:11 am GMT (diff)
102 - 为 python-sproto 添加 map 支持
上个月太忙了,做完这个修改还没写博客,现在补一下。。
之前使用 protobuf 做协议打包的时候,经常会有个痛点,没法用具体数据的值作为 key 来索引数据。比如现在客户端上传了造兵协议,协议大概长这样:
可以看到,造兵协议是一个数组,数组里每个元素是一个结构,包含 troop_type(兵种类别)和 amount(数量)。每次收到的时候,都需要遍历一次来建立一个以 troop_type 为 key 的字典,或者使用时根据 troop_type 来遍历查找。
最后,还添加了一点异常处理,若解包过程中出错,会把解出来的这个字典直接释放掉。有点担心异常处理的时候,会不会导致引用计数没有处理好,引起内存泄漏。以后有空再做一下内存泄漏分析 ~ 具体的修改可以参考:https://github.com/spin6lock/python-sproto.git
103 - 玩家回档原因分析
在最近一次维护后,玩家发现有较大规模的数据回档,还有一小部分玩家无法登录。现在尝试还原一下现场。
当天维护的时候,SA 执行了一次数据库维护。维护是通过一个脚本完成的,而且执行过多次,理论上没有问题。而维护的过程中,开发组这边需要执行一个脚本,给一批玩家增加经验。这一切完成后,QC 简单复测了一下,就开服了。开服后发现,服务器出现大量报错,而且都是玩家数据出现问题。定位这个问题的时候,发现玩家的数据丢掉了导致无法登录,顿时吓尿了 =_=||| 论坛里也有玩家开始叫骂,定位了一下貌似是那批增加经验的玩家,于是马上复查增加经验的脚本。玩家数据存储是使用 redis 数据库的,脚本里就使用了一条 hincrby 指令,不应该会清掉数据啊
接着,我们想到了一个可能,会不会是 SA 做迁移的过程中,我们跑脚本了,然后迁移数据的脚本看见有数据,就不再存入,导致玩家数据只剩下刷入的经验值呢?实践出真知,实验表明,redis 自身是有实现保护的,正在恢复数据库的过程里,外部复写的数据会提示报错。虽然没追踪到主因,但是我们之前额外做了一套旁路备份,用 golang+leveldb 实现的一套 redis 存盘代码。里面的数据肯定是对的,只是由于 redis 对应 uid 里有数据,所以不再从 leveldb 里取数据而已。说时迟那时快,快刀斩乱麻将加经验那批玩家的 redis 数据干掉,玩家就可以登录了。
慢着,报错还是没有停,还有一大票玩家遇到同样的情况。我们终于开始怀疑 SA 同学的脚本了。后来才发现,由于之前没有规范操作,导致备份的目录错了,SA 同学启用的数据库位置是正确的,但是之前错误操作,把一个老的数据库放进正确的位置了,导致实际上跑起来的,是一个 147 天前的数据库。于是,加经验的那批玩家中,是这三个多月里创号的,就会只剩下一个刷入的经验值,建筑数据等等都会丢掉了。而没有刷入经验值的玩家,是通过 leveldb,取到最新的档案,所以反而能够正常游戏。
最终,在 2130 这个高峰时间,我们停服维护了。把下午维护前备份的数据库恢复回去,少部分玩家丢失了 3 个小时左右的游戏数据,so sad。事实证明,我们的旁路备份是坚实有效的,前提是修复故障前,先要理清头绪,不要盲目修复,才能最大限度的减少损失。另外,不要设定不可能区域,SA 同学也是人,也有犯错的可能。
104 - 为 sproto 添加 python 绑定
项目地址:https://github.com/spin6lock/python-sproto
第一次写 Python 的 C 扩展,留点笔记记录一下。主要的参考文档是:Extending Python with C/C++, 之前也看过 cython,但是用 Python 语法写 C 还是没学会,稍后再尝试用 cython 写一遍看看。
作为一个 C 扩展,是以 Module 的方式 import 进去代码里使用的,所以需要注册一下,把自己的接口告诉 Python 解释器。代码如下图:
C 需要返回给 Python 的,一般有 int,string 和指针三类。前面两类都可以通过 Py_BuildValue 解决,参考如下:
如果要在不同的 C 函数之间传递 C 指针,则需要用到 PyCapsule_New 来建立一个 Capsule,把 C 指针包起来。这个 capsule 可以指定名字,方便 Python 代码里打印。还可以指定 destructor,当这个 Capsule 脱出当前 scope,被 gc 回收的时候,就会调用 destructor 来析构。Python 还贴心的提供了一个 Context,用来给这个 Capsule 带上额外的数据,方便后续使用。
对于 python-sproto 来说,之前有个问题一直没处理好,sproto_type 其实是对 sproto 的一个指针,指向其成员。所以,如果 sproto 被 gc 掉了,sproto_type 就有可能出错。而且这个出错是取决于 gc 时机,如果 gc 没跑,sproto 那块内存还在,就不会出错。这种隐藏的 bug 比较难查。简单来说,就是 C 扩展暴露给 Python 的对象,相互之间对生命周期有依赖关系。sproto_type 依赖于 sproto,所以 sproto 的生命周期至少应该和 sproto_type 一样长。为了向解释器说明这件事,需要用到 Py_XINCREF 和 Py_XDECREF,当生成新的 sproto_type 的时候,给 sproto 调用 Py_XINCREF,表示对 sproto 的引用加 1,销毁的时候就在析构函数里减 1,表示取消引用。
更优雅的做法,应该是把这类生命周期相关的信息,写在脚本里,而不是在 C 里处理。对外提供的可以是一个 Python 的类,这个类自己管理相关对象的生命周期,只要这个类还在,就能保证生命周期正确。
105 - 如何快速编写 Vim 语法高亮文件
这里有一份 中文的入门文档 ,但是太长了,不想读,所以有本文
- 最快的办法,就是找一个语法相近的语法高亮文件,稍微改一下
- 自己从头写的话,首先搞定关键字:
关键字搞不定的,一般用正则匹配:
正则有个麻烦是不能部分匹配,比如我要匹配花括号前的,/[a-zA-Z_]+\s{/, Vim 的语法高亮没有匹配组的概念,没法只高亮前面的字串,导致花括号也染色了。
这种情况下,需要用到嵌套识别,一般是 region 里嵌套 keyword 和 match,也可以 match 里嵌套 match。例如:
通过 contains 关键字,指定这个区域包含了哪些语法单位。
106 - windows 调试器尝鲜
曾几何时,我也下载过看雪论坛精华看的津津有味。可惜一直没有动手去调试,学到的 x86 汇编指令也忘得差不多了。最近将老机器的 T4200 CPU 换成了更省电,温度更低的 P8800,为了支援新的 VT 虚拟化,特地将 Dell 1545 的 BIOS 从 A8 升级到 A14。顺带发现 SLIC 已经自动升级到 2.0 了。但是升级以后,win7 开始菜单的睡眠功能就无法使用了,于是萌生了降级刷 BIOS 的想法。
下好了 1545A13 的 BIOS,运行后发现出现了一个 warning 信息,大意就是不能降级安装,点个确定就退出了。理想情况下 warning 应该是可以忽略的啊,网上搜索了一下,有个 /forceit 的命令行开关,实际执行发现没效果,决定上调试器。之前试用过 windbg,有个功能很不错,可以在访问指定范围的内存时停下来,可惜没找到如何进入用户态。换了 ollydbg,德国人出品的共享软件,非商用不要钱,写邮件注册下就好。
围观了一下 ollydbg 的教程,基本上简单的破解就三板斧,首先搜索所有引用字符串,然后定位到代码里引用这个字符串的位置,在附近下个断点,最后实际运行下,观察代码路径,看看是哪个代码分支跳转到字符串的,然后改跳转就好。于是按部就班的修改一下 1545A13 的驱动:

查找所有字符串,然后在弹出的窗口中搜索:

然后在反汇编器里面跟踪:

于是很清晰的定位到显示 msgbox 的位置:

可以看到,显示警告信息的前面几条指令里,有个条件跳转 JLE 00422E15。我们直接将其改为强制跳转,绕过警告信息的显示和接下来的退出流程。先按下 F2 打一个断点,然后按 F9 直接运行到该条指令:


将指令改为 JMP,地址不变
于是我们就看见亲爱的降级刷 BIOS 界面了,完。

107 - 休斯顿,我们遇到了一个问题
最近和前端同学聊得比较多,聊着聊着发现前端回报了一个诡异的错误,服务器端发给客户端的 JSON 错了,解不开。前端同学 bs 了一下服务器用的 JSON 库,居然连编码都会出错。我检查了所用的库,前后端的确用的不是同一个 json.lua,于是跑了一次简单的压测。当然,没有发现问题。过了两天,又遇到同一个问题了,这次我留心了一下错误的详细内容:
本来是引号的地方,变成了 2。比较一下两者的二进制表示: |0011 0010|2 |0010 0010|"
两者只差一个比特!再找到上一次的错误,是一个 , 变成了<: |0010 1100|, |0011 1100|<
看来,我们遇到了传说中的比特反转!相关的资料可以参考 这篇文章 。
一时好奇心起来,就写了个爬虫,爬了最近十天的日志记录(没有权限查数据库 Orz),分析了约 80 万条日志,总共扫出了 6 例类似的报错。发生的机型以国产机居多,以下是点名时间(啪啪啪): |SM-G3502 |Coolpad 8705 |Coolpad 8720L |HUAWEI G521-L076 |ASUS_T00F |vivo X3t
品牌从三星到华为,再到接地气的 coolpad 都有。
相信实际上发生的比特反转几率会比这个还要多,因为发生在 json 字符串中间,或者 json 数值中间的,都不会被发现。另外,二进制打包是用 protobuf 做的,pb 包损坏的报错其实也不少,只是这个就没法确认是 1 比特坏了还是多个比特坏了。据 参考资料 说,4G 内存的 PC 机,每小时 3bit 错误到每个月 3bit 错误都有,而移动设备的数量比 PC 要多得多,所以出现这种情况一点都不奇怪。
及后,我分析了一下我们的协议收发过程,当时实现的时候没有加上验证码。如果加上了,可以补上一个包重发机制,遇到错误的包要求服务器重发。或者添加某些校验码,类似服务器内存使用的 ECC,可以让只错了 1bit 的包恢复回来。第一次发现 TCP 也会不可靠,哈哈
108 - 糟糕的十一月
十一月感觉就是写邮件系统和两个策划要的活动而已。。。
一直觉得邮件系统十分简单,但是实现的时候却不是一回事。实现速度比预期的慢,一方面是边写边参考了礼包系统的结构,另一方面是抽象错误。就因为邮件放在礼包的位置,然后邮件看起来只是比礼包多一两个字段,所以就参考了礼包系统。这个错误实在太严重。表现层的相似性居然影响到后端的实现!!!
上周的 code review 里,被喷了两个多小时。焦点主要是两个地方,一是对内部来说,其他子系统用邮件的时候不友好;二是协议来说,冗余太多,浪费带宽,协议之间也没有正交。解决办法是,为各种类型的邮件建立模板工厂。写邮件的时候,只需要输入所需的少数几个参数,由生成出来的方法检查参数正确性,及特定邮件的固定参数。协议方面,添加了分页加载功能。
接着另一位同事,参考了其他项目的情况,抽象出一个更好用的存储层。虽然,存储层做的无非是 CRUD,对于邮件系统而言,更可以缩减为 CRD。具体实现上,还包含了一层 cache,避免对数据库的高频读写。但是,我原来的实现,是按照显示邮件所需的各个参数来做序列化的,因此,其他系统难以复用。当然,设计之初也没有打算提供给内部系统用。。现在,把这一块变成了 Json 做存储,谁都可以用,底层负责数据存储和消息通知,相当于一个带持久化的消息队列。有了这个队列,写邮件系统就简单多了,无非是检查客户端输入,然后到这个消息队列进行查询即可。这个队列写起来也很简单,只需要删除过期消息,不需要管具体存储,相当于有一块字符串过来就丢一块到数据库,取出来的时候按 tag 和 uid 直接取出相应队列即可,十分高效。
谢谢各位同事的包容,以后要加倍努力 ~
109 - skynet 的协程
之前对 skynet 的印象,主要是来自于我对 golang 的理解,对 gevent 开发的经验,以及云风的 blog。对于底层的代码,并没有仔细去阅读过。最近在实现业务系统的时候,发现有同事在同一个函数里做了一个互斥的判断,才发现对 skynet 的理解有误。
以前,用 python 的 gevent 框架实现游戏服务器的时候,会针对每个玩家建立 3-5 个 greenlet(协程),用于处理玩家身上的定时器事件,以及 IO 操作。然后还有少数几个协程处理全局的定时器事件。当然,战斗是放在独立的进程中实现的,那边基本上每个怪都有 1-2 个 greenlet,一个房间里有几十个 greenlet 是很正常的。总结起来,就是 python+gevent 为了规避全局锁,采用了多进程,每个进程多 greenlet 的实现方式。
而对于 golang,会变成底层是多线程模型,上面跑着多个 goroutine,当一个 goroutine 发起阻塞式 IO 的时候,底层负责跑这个 goroutine 的线程,可以随之阻塞等待。系统便随即开一个新的线程,从一堆 goroutine 里挑一个可以执行的,继续执行。golang 就相当于用多线程,取代了以前 py 的多进程。
读完云风的 blog,我对 skynet 的理解,就是每个线程来跑一个 Lua 的 VM,一系列的 VM 组成了一个队列。然后每个 VM 有自己的消息队列,VM 运行时,就从自己的消息队列里,拿出一条消息执行。得益于 Lua 的沙盒机制,即使某个 VM 发生 traceback,也能得到有效隔离。同时,因为同处一个进程内,VM 之间数据交互可以做到相当高效,字符串之类的传递只要传指针即可。
但是,我之前忽略了 Lua 协程在其中发挥的作用。原来,一个服务(即一个 VM)收到一个包 req,就会新建一个协程进行处理。处理过程中,如果产生一个对外的 call 请求,req 包是当成处理完的,当前的协程是会刮起,等待 call 请求返回来唤醒。这时候服务可以继续建立新的协程来处理新的消息包,而不会阻塞住。也就是说,如果处理一个包的过程中,发生了 skynet.call 调用,是会造成多个协程并发执行的。如果不注意用锁保护协程间的共享资源,就有可能出现问题。
110 - redis-persist 上线
九月份惨不忍睹,因为代码质量不够高,直接被 Boss 喷成了筛子。被反复教育说要高质量的代码,要可维护、高性能
幸而,最后一周终于在紧张的加班中,灰度上线 redis-land-go 了,项目也改名为 redis-persist,github 在此 。
之前实现的,是 redis 到 leveldb,以及 skynet 从 leveldb 中读取数据的接口。最后一周添加的,是 SA 同事可能会用到的功能。主要是:
- dump
- restore_one
- restore_all
- sync
- sync_all
- count
- diff
- keys
- check_all
- fast_check
这些指令可以分成三类,一类是从 redis 拷贝到 leveldb 的,比如 sync 开头的指令;一类是从 leveldb 拷贝到 redis 中的,典型如 restore 开头的指令;剩下的是用来检验两侧数据的,比如检查一个玩家数据的 diff,检查数量的 count,还有列出 leveldb 部分玩家 uid 的 keys
这里的 fast_check 是针对当前玩家存储做的一个特殊优化,在 leveldb 中用前缀分出了一个特殊的 key 表,里面是玩家 uid- 玩家数据 version 的 key-value 对。这个表足够小,可以整个放进内存里,所以对于只需比对数据版本号的情况,能够在极短时间完成。redis 和 leveldb 通过网络连接,不在一台机器上时,12w 数据不超过 1 分钟。
同时,折腾这套工具的时候,还顺便看了一下 leveldb 的结构。leveldb 有个 sstable 的概念,sstable 就是内存里一块按 key 有序排列好的表,可以改动的时候叫 memtable,准备写入磁盘的是另一个表,叫 sstable。当数据比较少的时候,层级也比较少,具体哪个 ldb 文件对应哪一段 key 范围,是记录在 MANIFEST 里面的。写入的记录,首先记入 log 里,这是顺序写,所以极快。然后是定期后台整理,将 sstable 和磁盘上已有的 ldb 文件合并,使得磁盘的数据越来越有序。
111 - 忙里偷闲的八月
八月依然有些很狗血的策划案要做,以至于花了两周时间,周五做出来后,连策划自己都觉得配置超多超复杂。。。
这个月比较过瘾的,是下决心做了 dns 的实验。当时为了防止 DNS 污染,曾经用 Python 写过一个 DNS 代理,通过 TCP 管道传输解析包,避免墙的干扰,地址在 google code。项目原本是通过丢弃最先返回的 udp 包来实现的,后来改为了 TCP 查询。不过,当时硬着头皮读的 RFC1035,只读懂了 TCP 的部分,只要将接收到的包体加上长度作为包头,就可以直接丢到 TCP 管道的另一端,解包也是根据包头解出 DNS 返回包,送回到查询者即可。
于是,这个月就再重读了一次 RFC,实现了一个基本的域名 =>dns 查询工具,地址在 github。真正实现的时候,RFC 文档还是很实用的,尤其是里面查询结构的定义,相当清晰。就是在 python 里不大好处理位,需要自己做与运算。实现时有个问题不是很明白,为什么域名要分成 label 这样的短字符串来实现,搞的一个域名有可能用了 3 个字节,只是用来分别标记 3 个 label 各自的长度呢?后面有提到域名 label 的复用机制,但是这个和一个完整字符串是不矛盾的啊。Anyway,这种 jump 指针的实现的确很巧妙,甚为折服。调试的时候,还初步学会了使用 scapy 工具,碉堡了。可以输入 RFC 里面的各种参数来构造一个包,还能打印出包体的字符串表示,通过对比很快知道了自己实现的缺陷所在。最爽的是还能从 IP 包构建到 UDP 包,通过 IP 包 /UDP 包 这种表示来表达 payload 的意思,有空用来写个 TCPkill 玩玩,哈哈。
另一件,是参与到晓靖的 levent 项目 里。levent 在 Lua 里基本复刻出 python 的 gevent,顺带创建了自己的类机制,还有一些非常实用的库比如 struct(跟 python 的 struct 相仿)。随手写了两个示例,一个是负责端口转发的 portforward,另一个是 http 代理 。写端口转发的时候,竟然有种写 golang 的感觉,一个 lua 的 coroutine,就好比一个 golang 的 goroutine。针对一个 socket 起了两个协程,一个负责读,一个负责写,在虚拟机里跑能有 2000 多的 qps,还算不错。对比 gevent,gevent 一开始能够上 3000 多,不过越跑越慢,最后完全跑不动了。用的是示例里的 echo server,测试用的 redis benchmark。http 代理的实现,参考了 PythonProxy 的实现。对于 1.0 的 http 协议,只支持了 GET,POST 等有限几种方法。除了 CONNECT 方法外,基本都是改写一下头部,丢过去服务器就可以了。CONNECT 方法更简单,连接后直接作为管道转发数据,连 header 都不用改写了。。。
希望接下来的 9 月顺顺利利啊
112 - 并行的边界
七月份忙的狗一样,还一度要 12 点赶回公司修 bug,真累。。。
入职以来的这两个月,一直在业务层摸索,苦于没有文档,rpc 协议、单件服务的启动、为热更新去准备的环境变量等等,都要一一在摸索中问出来。幸而,终于走过了这一段。这也促使我开始思考,skynet、gevent、golang 之间,各自的优点和缺点是什么。
先从 skynet 说起,最直观的感受是,skynet 在 lua/c 里几乎完全复制了 python 的标准库。上至打包用的 serialize、json 库,下至打印字典 (table) 的 prettyprint,都实现了一遍。所以,使用过程还是比较愉快的,前提是你找到了这个库。。另外,底层 rpc 使用了 Google 的 protobuf 负责打包,实际使用中发现,我们基本就用 int32 和 string,枚举和布尔值也用的不多。其实就跟上家公司一样,对 rpc 只要支持字符串、整型、数组和自定义结构体就够了。protobuf 单个结构的定义过程和标准的一样,不同的是协议的定义。使用了一个 protolist 文件标记所有的协议,然后又分默认写法、请求为空写法、回复为空写法。与其支持这么多东西,倒不如直接全部自己定义,不搞默认值那一套了。
最令人蛋疼的,是服务之间的交互。起服务的时候,要记得在两个地方注册,因为 skynet 有集群模式和单机模式的区别。然后服务之间交互,需要手动写 call,告诉 skynet 我调的服务叫什么名字,如果没有名字就传一个固定的 id 进去识别。然后写完逻辑,返回数据的时候,要记得用 skynet retpack 一下,要不发出请求的服务就会一直卡在等待状态,而且没有任何报错提示。如果说受限于 lua 的语法,不方便增加新的写法以表明跨越了协程,至少我写完 call,skyne 返回数据的时候能打包吧?据说,这个支持是为了在函数体中间给 skynet 返回结果,再继续做其他事用的。但是这种想象中的灵活写法,为业务层开发带来了隐含的信息假设,而项目又没有文档说明这个事情。
对于 skynet 的 agent 模式,我还是比较欣赏的。但是和 gevent、golang 不同,跨 agent 之间的通信需要显式调用底层的接口,这就比较疼了。我希望 agent 服务能够有自己的超时机制,如果跨 agent 的调用过一段时间没有返回,至少你给我个提示信息来查一下嘛。往大里做的话,还需要给 agent 的相互调用添加监视,控制调用频率、是否重试等等。作为分布式系统,其实是将单进程 / 单线程的复杂性转移到整个架构部署的复杂度上来,这样每个服务会变简单,复杂性就体现在服务的交互过程和服务本身的维护上了。
golang 没有显式的标记一个服务,任何函数只要用 go 这个关键字去跑,就可以作为一个协程单独跑起来。交互的时候,使用了 channel 这种东西去告诉底层,发生了一个跨越边界的消息传递。而 gevent 则是通过 spawn 这个函数去跑起一个新的 greenlet 作为协程。由于不会跨越线程 / 进程边界,gevent 也不需要对消息传递进行特殊处理,只要按普通函数的调用来做就好了。
综合来看,显式指定并行的边界,有助于底层并发的优化,但是没有合适的语法糖和基础设施,写业务的时候就会觉得好累了。
113 - 初来乍到
来到新公司后,终于有机会用 git 作为版本控制的工具。通过 github 私有仓库进行 Pull Request 和 code review,的确十分方便。使用的时候发现自己关于分支的知识不够用了,出现过一次提交 Pull Request 后被 merge,然后自己本地又 merge 了,导致 git pull 时版本冲突的问题。另外,客户端不希望出现 merge,所有对共享配置的修改,都需要用 rebase 方式合并,又犯了一次错误
最近提交的代码里,主要是用 python 写的一个日志分析处理的工具。原来 SA 的童鞋用 shell 脚本搞了一个,不过对 shell 相关工具链用的比较深,改起来和调试也不太方便,于是我们这边主推用 python 重写一个版本。对于数据呈现,使用了 dygraphs 作为前端展现的工具,使用上还是比较简单的,指定一个 div 让它替换为图标,把数据整理成 csv 喂给它就可以了。这绘图还带了一个拖动条,可以重点看某一段时间的数据,十分不错。
游戏的逻辑代码也开始接触了,预计下周可以 ship 到生产环境上。新公司的 qc 数量不是很够,出 bug 影响比较严重,所以 ship 代码会比较谨慎。在 skynet 上写逻辑,与我之前的代码写法有点像。之前做军团模块,为了抽离数据保存的细节,特别做了一层 agent,负责具体操作数据。新公司里,在 skynet 上跑的 Lua 代码,也是 agent,具体的数据放在 redis。就好比 redis 是一个数据结构的库,lua 只负责业务逻辑,通过 redis 来存储、获取和设置数据。redis 的效率很高,即使是集中发礼包这种活动,也只是卡了几秒就完成了。而且,分离开不稳定的业务逻辑层后,业务逻辑层的崩溃不至于丢失业务数据,随时可重启解决问题。
新同事不见得特别牛逼,也不是神一般不会犯错误,但是他们修复错误的速度很惊人,很快便找到完成目标的正确方法,这点很值得我学习。希望下周一切顺利
114 - 进程 daemon 化
最近跳槽,转去简悦了,新公司的技术氛围很好,我要更加努力 ~
有些问题不写博客的时候,以为自己是懂的,但是实际讨论的时候,发现有一些细节还是没有搞清楚,这次试试讲进程怎样 daemon 化。
首先上代码,这次的代码来自于 stackoverflow:http://stackoverflow.com/questions/17954432/creating-a-daemon-in-linux
fork 出子进程后,子进程结束时并不会马上被回收,而是形成一个僵尸进程。因为,父进程需要对子进程的尸体进行回收(以获得子进程的运行结果),如果父进程不关心子进程的状态,可以设置 SIGHLD 信号量的处理为忽略。考虑到不同系统实现不同,对于非 Linux 的系统,即使父进程设置了不关心子进程状态,依然有可能
115 - 嵌入式课程设计 -- 第一天
今天花了一个早上去配置开发环境,晕死。。。
主要问题是找到一个合适的 2410 实验箱。电脑方面虽然普遍带毒,好歹还是能跑起来。但实验箱方面就比较麻烦。一个是线缆的配合,包括串行线,串行线方面有两种,一种是斜纹,一种是直纹的,它们分别是交叉线和非交叉线。另一个比较重要的线缆是 JTAG 线,我们见的 JTAG 线比较少,所以刚开始的时候拿了另一个实验箱的线。
然后是熟悉了一下 vivi 的操作,首先是尝试把一个 helloworld 的文件通过 JTAG 线烧进去,这个理论上机器正常都可以输出结果,不需要串行线、键盘之类的配合,应该最简单。结果试过多台机器都不行。后来 partner 提醒道,大于 4KB 的文件是跑不起来的,而 helloworld 有 17KB
最后用老师平时演示的机器,终于把 hf_vivi 烧进去了。然后通过 hf_vivi 把 vivi 烧进去。最后成功了。刚下载好 360 杀毒,剩下的就等吧。。。
116 - 引用计数 gc 机制使用不当导致内存泄漏
上一篇文章找同事 review 了一下,收到的反馈是铺垫太长了,我尽量直入正题,哈哈
最近 dbd 压测时发现内存泄漏,其实这个问题去年已经暴露了,参见这篇 博客【压测周】。当时排查不够仔细,在此检讨下。关于 dbd 的内存问题,还有 这篇博客 讨论线程安全,以及 这篇博客 讨论临时变量的处理。当时还存了一个尾巴,因为用到关联数组进行脏数据管理,这部分数据是怎么释放的一直没搞明白。今天算是搞明白了,这个内存泄漏的 bug 也源于此。
基于引用计数的 gc 机制,应该是在引用计数为 0 的时候释放内存的,lpc 也基本没有例外。具体详情可以参看 free_svalue 的实现,里面基本是引用计数减去 1,然后检查是否引用计数为 0,若是 0 就执行相关的 Free 操作。其中,有一半的篇幅都是讲字符串的释放的,剩下的则是 object、buffer、array、mapping、class 以及 function 的释放问题。所以,基本上,lpc 不需要像 golang 一样,停止一切操作做 mark and swap 的 gc 操作。也不同于 Lua 的标记清除,不需要分步执行,只要引用计数为 0,立马释放掉。
为什么是基本上呢?因为对于 object 类型,lpc 并没有对其立即释放,而是放到一个链表里面,待主循环里没有函数执行时,再行销毁。这样做,一方面是为了配合复杂的热更新机制,另一方面,则是解决 object 循环引用的需要。对于对象的销毁,首先调用的是 destruct_object, 这个函数最终的作用是为对象打上销毁标志。在这个函数里,针对 master object 和 simul_efun object 做了热更新的处理。然后从栈上移除 object 的所有引用,从 object#n 列表里移除这个 object。最后打上销毁标记,并放入待销毁列表。
下一步,则调用 destruct2, 首先将该 object 的所有变量释放。如果该对象有对自身引用,则因为这一步而引用计数减一,方便接下来释放该对象本身。接着调用 free_object, 对象引用次数为 0,已打上销毁标记,功成身退,成功析构。
由于在 dbd 中,没有跑 lpc 脚本,所有的关联数组(mapping)都是在 C 层生成和使用的,因此引用计数需要手工维护,这就是万恶之源了。对于脚本层,新建的变量,引用计数都应该为 1,退出变量作用域时,则引用计数减一。放入 mapping 时,引用次数相应加 1。而在 C 层使用 mapping 时,所有变量的组织都是围绕 mapping 展开的,变量的生命周期就等同于 mapping 的生命周期。当序列化数据后,释放数据对应的 mapping 时,会对其中的所有变量引用计数 -1,但依然计数不为 0,因此无法释放。
解决的办法也相当简单,变量放入 mapping 前,先 free_svalue,将引用计数变为 0,则加入 mapping 后,引用计数为 1,生命周期就同 mapping 一样了。
117 - 脚本引擎栈指针误操作引起内存泄露
最近,为了确定目标部署机器的配置,我们对服务器进行了玩家登录的压力测试。在 E7500 cpu,3G 内存的开发机上,同一时间登录人数不能超过 20 人。以 0.01 秒间隔登录,测试人数 5000 人,登录时一个核心在 30%-60% 之间波动,另一个核心比较空闲。稳定后,CPU 平均在 5% 一下(玩家只是登录后保持心跳),峰值内存在 2.3G 以内。但比较诡异的是,当玩家全部断开后,服务器的内存还是没有降下来。我觉得,可能是发生内存泄露了。
发现这个问题后,我排查了底层对玩家 user object 的管理。user 有两个部分组成,一个是外部包裹的一层网络统计相关的信息,另一个是内部的 lpc object。外部的 user 有 online_user_tbl 这个哈希表负责管理,提供了遍历方法、总数统计及获取所有对象的方法。而实际数据的存放,则是在 all_users 里面,这个是一个大型数组,启动时按配置设定的最大在线人数进行预分配。
通过 dumpallobj() 接口,初步发现内存泄露时,user 对象虽然释放缓慢,但是在几分钟之内,已经全部释放完毕。因此排除了 user 对象的泄露。再加上预分配的 all_users 列表,大小是可以估算出来的,大概 400M 的样子,不可能引起那么大的问题。于是又通过 memory_info(), 打印出 lpc vm 各种 string, mapping, object 的内存占用,发现还是没有异常。跟老大商量过后,他认为是内部做了内存池之类的结构,证据是内存不会无限疯长,只要没有活跃玩家,峰值就停留在 2.3G 左右。由于没有头绪,只好暂时放下。
昨天,为了测试网关服务器的转发性能,我便写了个 ping pong 测试,大约是 3Mb/s,1000 包 /s 的样子。CPU 占用有点高,一个核心占了 50%。诡异的是,做 ping pong 测试没有涉及具体逻辑,但是内存一直在不停地涨。跟老大反映后,他认为是最近新加入的脚本层 socket 有问题。于是,花了大半天的时间,仔细审核那段代码。的确发现了有一处内存泄露,在某一处错误检测里,会直接 return 掉,没有处理中间分配的临时变量。不过那个条件分支没有跑到,所以内存泄露应该是别的地方。
今天,又特意写了黑洞测试来考察脚本层 socket。在只是打数据到远端服务器,不需要序列化,不需要处理逻辑的情况下,服务器内存占用相当稳定,看来可以排除 lpc socket 了。ping pong 的逻辑只有 100 行不到,那剩下来的应该就是序列化数据和反序列化数据的地方了。当时,出于通用协议的考虑,内部服务器之间的通信,没有具体定协议,只是以 req 和 resp 两条协议做支撑,参数序列化为 json 字符串进行发送。没想到,单独序列化和单独反序列化都没有内存泄露。我原以为是序列化 / 反序列化过程中,对临时生成的字符串没处理好,造成内存泄漏的。
后来,和老大一道,审读 json 序列化和反序列化的代码,发现栈顶指针操作有点异常。对于一般的脚本层调 C 层 efun,会用宏 SET_ALL_ARGS 获得参数的个数和偏移地址,在处理完参数转换后,再通过 POP_ALL_ARGS 清除所有栈顶的所有参数(参数的引用计数减 1)。当有返回值时,将返回值压入栈顶。没有返回值时,压入空值。但是,反序列化的函数,只是暴力的将栈顶指针指向自己生成的返回值,没有对传入的参数做任何处理。就是这个地方,导致了参数的内存泄漏。其实我早该想到的,不是序列化过程中的泄漏,也不是某一单过程的泄露,那就应该是传参出问题了。。。以后要统一规范,用对应的宏来正确处理栈指针和脚本层传来的参数。
118 - 译 libev 和 libevent 的设计差异
本文译自 what’s the difference between libev and libevent? 作者是 libev 作者
[ 问 ] 两个库都是为异步 io 调度而设计,在 Linux 上都是使用 epoll 机制,在 FreeBSD 上则都是 kqueue,还有诸如此类的很多相通之处。
除了这些表面上的差别外,其实这两者根本的区别在哪里呢?比如架构上,或者设计哲学上。
[ 答 ] 就设计哲学来说,libev 的诞生,是为了修复 libevent 设计上的一些错误决策。例如,全局变量的使用,让 libevent 很难在多线程环境中使用。watcher 结构体很大,因为它们包含了 I/O,定时器和信号处理器。额外的组件如 HTTP 和 DNS 服务器,因为拙劣的实现品质和安全问题而备受折磨。定时器不精确,而且无法很好地处理时间跳变。
libev 试图改进所有这些缺陷,例如避免使用全局变量,转而在所有函数中,使用上下文变量来代替。每个事件类型,使用单独的 watcher 类型(一个 I/O watcher 在 64 位机器上,只需要 56 字节。而 libevent 需要 136 字节)。允许额外的事件类型,例如基于挂钟的计时器,或者单调时间,线程内中断,准备并检查 watchers 来嵌入其他事件循环,或者被用于其他事件循环来嵌入。
额外组件的问题,是通过直接去掉额外组件来解决的,这样 libev 就可以小而美,快速高效了。但你也需要从其他地方寻找 http 库。因为 libev 没有带上。(例如,有一个库叫 libeio,可以完成异步 IO 的工作,也可以和 libev 配合使用 )。
总而言之,libev 试图做好一件事而已(目标是成为 POSIX 的事件库),这是最高效的方法。libevent 则尝试给你全套解决方案(事件库,非阻塞 IO 库,http 库,DNS 客户端)
一句话总结,libev 尝试追随 UNIX 工具箱哲学,一次只干一件事,每次都做到最好。
注意,这是 libev 的设计哲学,我想我作为 libev 的设计者,有着足够的发言权。至于这些设计目标有没有实际达到,或者这些设计哲学是否坚实可靠,则交由你来评判。
[ 译者注 ] 第一次注意到 libev,是在 gevent 的开发者 blog 上的这篇 libev and libevent,它简要说明了 gevent 从 libevent 切换到 libev 的决策过程。回顾 gevent,它实际需要的只是一个负责事件循环的 C 库,在上面的 HTTP 库和 DNS 库,都可以交由标准库强大得不得了的 python 完成。因此,作者的选择还是非常明智的。
从 Libevent 2.0 来看,libevent 团队已经意识到上述的问题,也提取出了 event loop 这个上下文 context,但是在具体的 DNS 解析,HTTPS 连接等等,还是有种力不从心的感觉。作为 libevent 的使用者,我们经历了 libevent 的试错阶段,发现 HTTPS 实现不行,再切换到 libcurl 去,与其这样,倒不如直接不提供该功能呢
119 - libevent 库 1.4 升级到 2.0 时无法 flush 的解决办法
libevent 的接口兼容性做的还算不错,基本上替换一下就转到新版本了。但是,强制 flush 数据的时候出了问题。目前的应用场景是,遇到顶号登录这种情形,先用 bufferevent_write 向客户端发送错误信息,然后再断开 socket。用的 flush 是这样的:
在 1.4 的时候,这段代码工作良好。但是,在 2.0 的 libevent 里,这段代码不能刷出数据。看了下 errno 和 socket_errno,错误码是 EINPROGRESS。百思不得其解下,在脚本层将关闭 socket 放在下一次 libevent 事件循环里完成,结果就好了。
大致猜测下,应该是 libevent 为了效率做的优化。因为 write 是比较昂贵的系统调用,若因为 evbuffer_write 的反复调用,而引起多次 write,会影响性能。翻了一下 libevent 2.0 的代码,evbuffer_write 是调用 evbuffer_write_atmost 的,对比下 1.4 evbuffer_write 和 2.0 的 evbuffer_write_atmost:
2.0 有个显眼的 freeze_start 的检查,正是这个检查,让 evbuffer_write 的调用直接跳过了发送阶段。于是,在 flush 的时候加了一个 dirty trick,直接调用了 evbuffer_unfreeze:
问题解决
然后跟了下 libevent 2.0 的文档,里面提到 freeze 的作用:
因为是从 1.4 移植到 2.0 的,所以没有理由自己 freeze 掉的。那么剩下的原因只会是 libevent 自己 freeze 了这个 buffer,内部对 freeze 的调用集中在 bufferevent_sock.c 和 bufferevent_pair.c 两个文件里,目前没有使用 socketpair,于是目标只有 bufferevent_sock.c
这就解释了为什么直接调用 evbuffer_write 没有作用,因为这个接口似乎就没有打算直接暴露给用户使用。根据 这篇文章 的分析,libevent 对注册事件的检查顺序是超时事件,然后是 I/O 事件,并将其一一放入链表里,逐个调用回调函数进行处理。回头看应用场景,当一个玩家顶号登录时,首先触发了本轮的 IO 事件,解包处理逻辑,执行踢人的逻辑处理,向缓冲区写入对客户端的提示信息。注意,本轮对写缓存的修改,并不会立即触发 bufferevent_writecb 进行发送。因为,其触发的只是用户设置的 callback 和上一轮留下的 deferred callback!正是因为这个原因,本次事件检查循环写入的数据,必须等到下个循环才能被执行。所以,脚本层想要发送完顶号提示信息后,立即断开 socket,就会导致 socket 过早被断开,提示信息无法发送出去了。
update:
其实底层的 write 还是有可能没发完,evbuffer_write 不提供保证。所以应该是去掉读回调,在写回调里判断是否已写完,写完则断开
120 - 游戏协议加密及身份验证
时间如白驹过隙,一眨眼就过去了,本打算在 2 月份发这篇的,结果一直误以为 2 月有 31 日
这一块之前一直感兴趣,终于在 2 月份争取到机会去做这一块的工作。前辈给我留下了一个鉴权的框架:
- 客户端连接服务器
- 服务器将随机数发给客户端
- 客户端用客户端私钥加密,发回到服务器
- 服务器端用客户端公钥解开密文,比对解开的随机数是否与原来的一致
- 如果一致,则客户端发送随机数到服务器,服务器用服务器端私钥加密,将密文发送到客户端;同时,产生新的随机数,用于稍后对会话进行 rc4 加密,并将这个随机数以客户端公钥加密,发送到客户端。
- 客户端用服务器端公钥解开密钥,比对随机数和自己发的是否相同,相同的话则用客户端私钥解开下一个包,取出用于 rc4 加密的 key 密文
- 至此,双方身份验证完成,会话先进行压缩,再通过 rc4 算法进行加密
在这里,私钥充当了一个身份的象征,只要拥有私钥,就认为对方是授信客户端。可能有朋友会问,如果客户端被破解怎么办?我觉得安全专家道哥有个观点很好,安全的本质是信任的问题。设计任何安全方案,最终都必须要有一个东西是「假设可以信任的」,只是看这个「可信任」的东西被攻击成功的概率大小。如果不这么做,则做不出任何的安全方案。所以,考虑协议安全的时候,我们只能选择相信客户端密钥被安全的保管着。
回头再看看这个方案,这里用到了私钥进行加密。熟悉 ssh 的同学应该会联想到其挑战过程,ssh 服务器是用客户端公钥对随机数进行加密,再发送到客户端的。公钥加密和私钥加密的区别是,在明文相同的情况下,公钥加密出来的密文每次都不一样,而私钥加密出来的密文是每次都相同的。示例代码可以参见: https://github.com/spin6lock/rsa_encrypt_and_decrypt_in_c 密文和明文总是一一映射,容易被碰撞攻击,进而绕过加密过程。因此,私钥加密多用于身份验证,比如电子邮件的数字签名,首先用 md5 对邮件明文进行信息摘要,然后用私钥进行加密,公钥是公开的,保证任何看到这封邮件的人都可以进行解密,获取 md5 信息进行验证,确保邮件没有被纂改。
于是,我花了一周左右的时间修改了验证流程。新的验证流程如下:
- 客户端连接服务器
- 服务器用客户端公钥加密随机数,发给客户端
- 客户端用客户端私钥解密,发回服务器
- 服务器对比随机数,不一样的话就断开连接
- 客户端用服务器端公钥加密随机数,发送到服务器
- 服务器用私钥解密,发送回客户端
- 客户端验证通过
- 服务器用客户端公钥加密 rc4 会话所用密钥,发送到客户端
- 客户端用公钥解开,接下来在 rc4 加密下上传
接下来,想针对手机网络模块的工作特点进行协议优化。由于手机受限于电量,网络芯片工作时会有启动,半速,全速,半速,设备待机这个速度曲线,如果能够在应用层对包进行打包发送,能够大大提高手机的待机时间,参见这篇 开发指南 。协议压缩放在下一篇吧 ~
121 - 初探 groupcache
groupcache 是用于 dl.google.com 的一个 memcached 的替代品,相对于 memcached,提供更小的功能集和更高的效率,以第三方库的形式提供服务。
groupcache 的常见部署可参考下图:

不同于 memcached,groupcache 面向的是静态的缓存系统,比如 google 家的下载站,用来缓存对应的文件区块。一经 set 操作,key 对应的 value 就不再变化。使用的时候,需要自定义缓存缺失时使用的 set 操作。当发生 miss 的时候,首先会从根据 key 的 consist hash 值找到对应的 peer,去 peer 里寻找对应的 value。如果找不到,则使用自定义的 get 函数从慢缓存(比如 db,文件读取)获取 alue,并填充对应 peer。下一次获取,就直接从 cache 里取出来,不再访问慢缓存。另外,为避免网络变成瓶颈,本地 peer 获取 cache 后,会存在本地的 localCache 里,通过 LRU 算法进行管理。
groupcache 的代码分为 consistenhash, groupcachepb, lru, singleflight 等几个目录,分别存放一致性哈希,groupcache 的 protobuf 协议,lru 算法实现,用来保证求值操作只执行一次的 singleflight。本篇主要看看 singleflight。
23 // call is an in-flight or completed Do call 24 type call struct { 25 wg sync.WaitGroup 26 val interface{} 27 err error 28 }
这里定义了一个 call 结构,包含了用来同步的 wg 等待组,一个用于承载任意值的 val,以及 err 错误信息。
32 type Group struct { 33 mu sync.Mutex // protects m 34 m map[string]*call // lazily initialized 35 }
这里定义的是 Group 结构,一个 Group 内 key 是唯一的,类似于命名空间。groupcache 使用了 Mutex 保护 map 变量。
41 func (g *Group) Do(key string, fn func() (interface{}, error)) (interface{}, error) { 42 g.mu.Lock() 43 if g.m == nil { 44 g.m = make(map[string]*call) 45 } 46 if c, ok := g.m[key]; ok { 47 g.mu.Unlock() 48 c.wg.Wait() 49 return c.val, c.err 50 } 51 c := new(call) 52 c.wg.Add(1) 53 g.m[key] = c 54 g.mu.Unlock() 55 56 c.val, c.err = fn() 57 c.wg.Done() 58 59 g.mu.Lock() 60 delete(g.m, key) 61 g.mu.Unlock() 62 63 return c.val, c.err 64 }
这里 Do 定义的就是一个带锁保护的保证单次执行的函数。因为 consistent hash 定位到的 peer 是唯一的,因此这里只需要同步该进程内的 goroutine 即可。为了减少锁的影响,锁控制的范围被切成了好几段。整个完整流程包括 3 步:1. 初始化 g.m 变量 2. 赋值 g.m[key] 变量为 val 3. 删除 g.m 的 key。第一步会加锁,第一个进入的 go 程会走到第二步进行赋值操作,到其他 go 程进入 1 的时候,第二步 key 对应的值已经有了,可以直接释放锁了。然后到第三步,第一个进入的 go 程会加锁,然后删除 key,再解锁。前面尽早释放锁,就是为了第三步这里不需要长久的等待。
122 - systemtap 折腾笔记
在这货上花费了不少时间,都是受了 @agentzh 大神的蛊惑 :) 他写的 nginx-systemtap-toolkit 监测的数据很有价值,对于系统优化实在是利器。
最早折腾 systemtap,是在 Ubuntu 12.04 上搞的,内核版本是 3.8.0-29-generic,流程参考 官方教程 。因为 12.04 版本比较新,所以不需要重新编译内核了。然后添加带调试信息的内核,以及相关的 Linux 头文件。整个过程还算顺利,就是公司网速比较慢。下载完成后,用 ubuntu 官方仓库自带的 systemtap 1.6,却出现各种奇怪的 C 编译错误,于是换到了 git clone 下来的最新版本。这次错误信息友好了很多,但 tapset 的脚本跟内核的 dwarf 信息似乎对应不上,报 semantic error: not accessible at this address [man error::dwarf]。至此,ubuntu 上的 systemtap 只能打出 hello world,其他脚本都跑不了,遂放弃。教训是,systemtap 要新版,内核要老版,若用老 systemtap 和新内核,一般是会挂的。
对 systemtap 的用户态监控还是很口水,虽然我司用的是自己写的定制语言,但是 -g 编译后应该可以监控私有语言的脚本栈,进而分析性能瓶颈。于是,死皮赖脸抢夺了一台 CentOS 的机器做测试。机器版本如下:
用的 systemtap 版本是最新的。跟 Ubuntu 相比,CentOS 的包管理就比较差了,内核的调试信息包需要自己手动下载安装。参考 官方教程 ,安装 debuginfo-common 和 debuginfo 后,就可以开搞了。还好,这次不需要编译内核。安装好 systemtap 后,跑起来却出现这个问题:
提示:
Checking “/lib/modules/2.6.32-279.el6.x86_64/build/.config” failed with error: 没有那个文件或目录
检查了一下相关的目录,/lib/modules/2.6.32-279.el6.x86_64/ 是一个软连接,链接到 /usr/src/kernels/ 里去的。而 2.6.32-358.23.2.el6.x86_64 这个目录是真的没有,有的是 2.6.32-358.23.2.el6.x86_64。谷歌了一下,这个目录是 kernel-devel 包的,通过 yum 安装的是最新的 2.6.32-358.23.2.el6.x86_64,跟当前运行的内核不符。继续放狗,找到 2.6.32-279.el6.x86_64 的 kernel-devel rpm 包,安装完就有对应目录了。试了一下 iotop 终于成功了。
看了一下,systemtap 似乎是根据写的 probe 编译成二进制模块,加载到内核里执行的。所以 systemtap 会在 home 目录下建立一个 cache 目录,避免重复编译相同的脚本。而 nginx-systemtap-toolkit 对 Lua 的栈探测,是通过监视 LuaL 开头的函数实现的,接下来准备按他的思路搞一下我们的私有语言。
123 - Mongodb 在 NUMA 机器上的优化
10gen 在 mongodb 的部署指南上,提到了在 NUMA 机器上,mongodb 可能会出现问题,参见:http://docs.mongodb.org/manual/administration/production-notes/#production-numa
里面引用了一篇博客,主要讲 MySQL 的 swap insanity,而 mongodb 也会遇到类似的问题,博客地址:http://blog.jcole.us/2010/09/28/mysql-swap-insanity-and-the-numa-architecture/。
这篇博客有点长,我这里简单概括一下。
对于单 CPU,多核心的情况,每个核心访问内存的速度是一样的,这种架构称为 SMP(Symmetric multiprocessing, 对称多处理器),又叫 UMA(Uniform Memory Architecture,与 NUMA 相对,一致性内存访问架构 )。
对于多 CPU,多核心的情况,如下图:

可以看到,每个 CPU 都有一组配套的内存槽。每个 CPU 访问自身的内存插槽,速度都很快,但对于主板上的其他内存插槽,访问速度就会下降。这种架构被称为 NUMA。
对于 Linux 来说,加载的时候就会检测内存,计算 CPU 到内存的访问开销,将 CPU 和内存分成一组组的。每个进程和线程,都会继承父进程的 NUMA 策略,这种策略包括这个进程 / 线程会在哪个 CPU 上运行,分配的内存应该用哪组插槽的。
面对内存分配,只要一经分配到指定的 CPU 内存槽,就不会再挪动了。对于数据库这类应用,理想情况下是一个单一的多线程进程,吃掉了几乎所有的系统内存,并尽可能多的消耗其余的系统资源例如 IO。
对于两个 CPU 的 NUMA 架构来说,如果一个核心分配的内存超过系统内存的一半,就会出现问题。而 Linux 的分配策略是,首先使用 CPU 0,然后再使用 CPU 1。这时候就会出现一种情况,CPU 0 的内存组已经率先使用完了,但系统还有很多空闲内存,都在 CPU 1 上。这时候,Linux 会选择将 CPU 0 的内存刷到磁盘上,以换取可用内存。但是,swap 过程远比跨 CPU 访问内存要慢啊。这就会造成内存还没用光,但数据库疯狂刷盘的现象了。
解决办法是用 numactl 指定分配策略,将数据库需要的内存分散在各个 CPU/ 内存组上,保证不会出现一个核心已满而另一个核心空闲的情况。
124 - 转设置 Android 手机以使用 ARMStreamline 进行性能分析(二)
General Setup( 常规设置 ),确保启用了 Profiling Support ( 分析支持 ) 选项。
Kernel Hacking( 内核开发 ),在子菜单中,导航至 Tracers 子菜单,然后按下 Enter。确保启用 Trace 进程上下文开关选项。
Kernel Features( 内核功能 ),确保启用 High Resolution Timer Support ( 高分辨率定时器支持 )。如果正在使用对称多处理器 (SMP) 设备,则启用 Use local timer interrupts (使用本地定时器中断)。
为加快工作速度,先下载一个内核更新包作为模板。对于 HTC Sensation 4G 手机,可通过 Google 来查找某些 kernel update packages(内核更新包)。
将其解压至工作文件夹
用重新编译的内核文件 zImage 来替换
/kernel 文件夹中的 zImage 文件。 将 init.rc 复制到
/kernel 文件夹 在
/kernel 文件夹中编辑或创建 mkbooting.sh 脚本来更新启动镜像 将重新编译的内核模块(wifi 驱动程序)复制到
/system/lib/modules 文件夹 将 gator.ko 和 gatord 复制到
/system/xbin 文件夹 在
/META-INF/com/google/android/updater-script 文件夹中编辑 updater-script 文件。添加下列行来更新系统分区,并将 gatord 程序的权限设置成可执行。 在
/META-INF/com/google/android/updater-script 文件夹中编辑 updater-script 文件。添加下列行来更新启动分区(内核及 init.rc)。 将
文件夹压缩为 update.zip 文件。请注意!切勿将 文件夹本身包括在内。 将 update.zip 文件复制到目标手机的 SD 卡根文件夹下。
125 - 转设置 Android 手机以使用 ARMStreamline 进行性能分析(一)
- Streamline 5.7 版。Streamline 是 ARM Development Studio 5 的一个组成模块。因此,可通过下载 ARM DS-5 专业版、基础版或免费的 DS-5 公众版(针对 Android 系统)来获得它。
- - [Qualcomm Snapdragon ](http://www.arm.com/zh/markets/mobile/qualcomm-snapdragon-chipset.php)1.2-GHz 双核处理器,ARMv7 架构
- Android 2.3.4 版
- Linux 内核 2.6.35.13 版
HTC 手机的内部代码。如果是 HTC sensation 4G 手机,那么内部代码是图中红框标示的 PYRAMID。内部代码是 HTC Android 手机的标识,通过它可搜索到 HTC 发布的正确 Linux 内核源代码包。
安全锁的状态。目前我这台手机的安全锁状态为 S-OFF(安全锁关闭),在图 1 中用红框标示。安全锁对实现本文目的十分重要。S-OFF 表示设备的 NAND Flash ROM 处于解锁状态并且可写,这也就意味着无需进行签名检查就可以更新 Android 系统的某些分区;例如,通过自定义镜像文件来更新启动分区。HTC 设备的默认设置为 S-ON,这表示只能使用 HTC 官方的固件镜像文件来更新系统(因为启用了签名检查)。
在 x86 PC 上运行的 64 位 Ubuntu 10.10 版本
Linux 系统下的 GNU ARM Toolchain,本文所使用的是下载自 Mentor Graphics. 的 CodeSourcery ARM GNU/Linux Toolchain。
从 Android 开发者网站 下载的 Android SDK r16-linux 安装程序。
通过 Android SDK r16-linux 安装程序下载安装的 Android SDK 平台工具包
USB 电缆 电缆两端为 USB 插头(A 型)和微型 USB 插头(B 型)
空的 SD 卡,容量为 1GB 或更大。
在 Linux PC 上配置通过 USB 访问 HTC Android 手机,方法如下:
126 - FreeBSD 打开 DTrace 支持
主要翻译自:https://wiki.freebsd.org/DTrace
FreeBSD 跟 Linux 发行版一个比较大的差异,就是提倡源码构建。因此这里提到比较多的编译开关设置。自 2012 年 5 月后,DTrace 支持默认是打开的,因此以下步骤不再需要了。留意 uname -a 输出的日期即可。
添加内核编译选项,打开 DTrace 支持
- 打开调试符号
- 对于 10.0 之前的 FreeBSD,添加:
- 对于 AMD64(64 位处理器),添加:
- 对于 9.0 或之后的系统,WITH_CTF=1 需要在内核设置里添加:
(关于编译内核的步骤,可以参考:http://tthtlc.wordpress.com/2012/08/12/enabling-dtrace-on-freebsd-9/,内核的代码都在 /usr/src, 拿一份比如 /usr/src/sys/amd64/conf 里的 GENERIC 复制以下,添加上面的选项就可以了。)
重编译并安装内核
- 对于 FreeBSD 9 及以后的系统
- 对于 FreeBSD 8-STABLE 及更老的系统
- 安装内核并重启
查看安装效果
- 加载内核 DTrace 模块
kldload dtraceall
- 确认 dtrace 安装正确:
dtrace -l|head
- 尝试添加 DTrace 监控:
dtrace -n ‘syscall:::entry { @num[execname] = count(); }’
如果你看到输出是:
说明前面没做好,重头再来吧
用户空间的 DTrace
对于 FreeBSD 9.0 及以后的版本
- 对于用户态的 DTrace 支持,需要在你的 /etc/make.conf 文件里添加:
CFLAGS+=-fno-omit-frame-pointer
这是用以提供栈跟踪的,可以提供更多信息
- 重新安装 world:
make WITH_CTF=1 buildworld
make installworld
127 - 压测周
本周主要工作是解决 dbd 的多线程 bug,可是失败了。
为了重现这个多线程的 bug,准备模拟多用户登录的情景,当多个用户需要保存数据的时候,就会跑到多线程序列化数据的部分,应该可以重现这个 bug。于是,从周一到周三,花了三天时间,用 python+gevent 写了一个模拟客户端,实现了客户端连接服务器和登录的流程。其实这个测试工具,在上一个项目里已经写了一点了,基本数据类型的解包比如整型,字符串解包已经有了。但是,我翻看代码才发现,当时没有写打包协议的实现写的过程比较流畅,用了 mixin 的方式将 rpc 协议独立出来一个 RpcMixin 类,这个类最后会被 SimulateUser 类继承,而 SimualteUser 则负责提供连接好的 socket,以及相应的 greenlet 协程、登录用户名。唯一比较严重的 bug,是启动时并发多个 greenlet 协程的时候,用了 range 而非 xrange,又手残多填了几个 0,结果 CPU 和内存都耗在了产生 range(1000000000) 这个巨大无比的整数列表上了。
解决完以上的问题,周四到周六就开始正式的压测过程。压测出来的结果比较诡异,主要情况是多玩家登录后,再断开连接,而 gamed(游戏逻辑进程)和 dbd(游戏数据储存进程)依然保持着高水位内存。有一次还显示 2000 多个在线玩家,但模拟客户端已经全部断开连接了。这个有可能是进程最大 fd 连接数引起的,错误处理没做好,fd 最大值设成 200000 后就没重现过这个问题了。
维持高水位内存,目前猜测是两种可能。一是内部实现了内存池之类的设施,一经申请后再不释放,因为上到高水位后,断掉模拟客户端,再重新连接进行压测,内存也不再增长,只保留在高水位。二是有内存泄露,因为高水位后断开模拟客户端,过一晚上之后内存还有轻微增长。翻看了一下引擎的文档,里面有一点前辈留下的关于内存泄露排查的记录。里面提到的主要是脚本层的内存泄露排查,提供了一些 simul_efun 去 dump 出所有内存里的脚本 object,各个 object 的引用数和大小。排查了一遍 object,只有一屏幕不到的类型,很快确定没有问题。单纯客户端连接登录,不做任何操作,脚本层对象的大小才 600+MB,这时候已经差不多 11000 的模拟用户登录了。然后再排查了一下基本类型,主要是字符串,mapping,array 这三种。数据也比较正常,无法拼凑出 gamed 1G 多的内存占用。
EDIT:gamed 引擎里的确有 pool 的概念,一经申请再不释放。在玩家管理里,用到了 user_stack,断线释放的玩家结构数据块都会放在这里。
128 - 类型系统线程安全
最近情绪有点失控,跟很欣赏的同事吵架了,真难过。有些话,可能真的只有吵架才会说出口,只好安慰自己,这未尝不是一次难得的交流。究其原因,就是一段代码由我开发,他接手维护,然后交给我继续跟进;最近频繁报 bug,他觉得在替我擦屁股,收拾代码,我也觉得我在替他擦屁股,大家心里有气,但是谁也没有说出口。多点面对面交流,多点讨论,工作压力小一点,可能就可以避免了。
最近修复的 dbd 的 bug,一个是字符串管理上面的, 上一篇博文 已经提到了 mapping_to_bson 的,这周还发现了 bson_to_mapping 过程中的问题。由于 dbd 的对象管理采用了 LPC 虚拟机带的那套,包括 hash 表和字符串管理,而这套东西默认是在单线程运行的,没有考虑线程安全,所以 dbd 作为唯一一个多线程运行的进程,就有线程安全的隐患了。我翻看了原始实现,在替换 mongodb 前,dbd 实现反序列化的时候,很机智的避开了共享字符串,不管这个用作 mapping key 的字符串是否已经使用过,直接从系统里分配内存。我理解另一位同事用共享字符串的理由,维基里提到 string interning,就是为了节省内存和时间。因为 dbd 作为玩家数据的缓存,存储的玩家一定有很多 key 是相同的,这部分内存如果节省下来应该蛮可观的。为了线程安全,可能需要牺牲掉这个优化了。
另外一个是 mapping 结点的管理。新建 mapping 结点的时候,会从一个 mapping 空闲结点池里取,如果没有空结点则 malloc 一个新的,放到池里,最后从池里取。由于这个空结点池是全局的,没有加锁保护,同样会导致多线程上出现问题。如果不用锁,就只能像 string 那样,不依赖自己实现的结点池,每次使用均向系统申请了。但如果加锁,由于 gamed 这个游戏逻辑引擎也会用到,到时候就有可能影响游戏逻辑的运行效率了。
但是,反观最近的修改,除了通过网络将 dbd 的数据打到 mongo 去,其余与最早的实现差别不多,字符串那个问题可以说是共享字符串引起,为什么 mapping 这个冲突问题以前没有暴露呢?我留意了一下原有的锁设置。原有的全局锁是一把 pthread 的读写锁,在接到 gamed 发过来的脏数据后,往脏数据队列里插入,这时候会加上写锁。如果写锁加上了,读锁自会处于等待状态。当写锁释放,读锁加上的时候,可以有多个读线程同时读。这时候,应该有可能出现读线程之间同时创建 mapping 的情况啊,为什么当时会没出现问题呢?待查
目前看来,只要在这些涉及到全局变量的点上,主要是 mapping 和字符串管理,加上可靠的锁保护,应该能够有效解决线程冲突的问题。只是,前提是能够重现线程冲突这个 bug
129 - dbd 到 mongo 的序列化问题及稳定性
最近工作压力有点大,情绪偶然会失控,要好好反省一下自己。
上周本来打算写 CSP 相关的东西,但是目前做得还不够多,积累的经验不足,就放弃了。中间找到很好的参考资料,一并放在这里。一篇是比较短的论文,可以观其大略:http://www.cs.ucf.edu/courses/cop4020/sum2009/CSP-hoare.pdf,另一个链接是 hoare 写的关于进程演算的书:https://dl.dropboxusercontent.com/u/5660734/CSPbook_2004_Hoare.rar 对于理解 CSP 这个模型的数学基础很有帮助。不过书好长,还没看完。。。
本周合并了另一个项目组对 mongodb 改造的修改,对方完全重写我的代码,但没有配套单元测试,合并当天就测出 bug 了,有点碎碎念啊。没办法,硬着头皮剥离一部分依赖,独立出一个可执行文件来测 bson_format 的问题。正如之前写的 这篇 博客提到的,难点在于类型系统的对接。本次修改增加了一个 array 迭代,保证初次在引擎这边分配 array 的时候,已经是一块足够长的内存,而不是我原来实现时,迭代 bson,有一个元素就合并一个。另外,上次序列化为 bson 时,我错将 array 当 mapping 来序列化了,原有的测试只针对长度,没针对具体内容,本次修改已经修正。
另外一个地方,是关于内存对象的生命周期的。本次修改直接重写了 dbo_new, dbo_load, dbo_unload 等方法,这些方法控制了 dbd 内存中,存放在 apr_list 里的一系列 db 对象。gamed 通过 rpc 调用,以 dbo_new 或者 dbo_load 方法创建对象后,除非调用 dbo_unload,否则对象是不会被释放的,整个生命周期非常清晰。虽然 dbd 启动过程中初始化了 vm 虚拟机,实际上并没有跑 lpc 脚本,所有工作都是在 c 层实现的。本次修改中,在序列化过程里,用到的字符串局部变量,都是通过 vm 虚拟机来申请和释放的。个人对此持保留看法。在序列化过程中,所用到的 key 值都是临时性的,bson 化后就没有意义。一个简单粗暴的做法,就是直接在函数内定义定长字符串数组,然后每次需要序列化 bson key 的时候,都复制 / 格式化到这个数组上。这一方面可以避免堆区内存分配,另一方面避免无谓的内存泄露,以及可能出现的二次释放问题。
稍后,通过单元测试,修正了当天测试暴露出来的,反序列化 array 嵌套 mapping 对象时,array 元素没有初始化好,导致序列化嵌套 mapping 时,引擎 core dump 的问题。接着,对方又抛出了一个新的修改,依然是没有单元测试。。目标是修正引擎的概率性崩溃,依据是序列化 mapping 过程中,对 key 做字符串化操作时,会改动到原有的 mapping,然后造成内存泄露和 / 或 mapping 元素的二次释放问题,引致引擎崩溃。经单元测试发现,这个理由不成立,但代码里的确会有误释放的问题。至于误释放为什么没有引起单元测试崩溃,这个还需要看看 gc 那一块的代码。这次 bug fix 就没有吸合了,稍后通过在函数内定义一个局部定长字符串数组,加上 key 的复制来解决吧。
通过这几次引擎的修改,越来越发现,没有单元测试的代码,真的会没有信心的。不是说你用这个代码跑了两周,没有发现存储有问题,这个代码就是没有问题的。不同项目组里,用到的储存结构不一样,也许你的代码嵌套 3 层以后就会崩掉呢?或者就是这次暴露出的,复合类型的嵌套储存 bug 呢?没有办法用单元测试重现的 bug,只靠看代码猜测,我觉得是不靠谱的,因为修好后你也没办法重现 bug 的环境,看看本次修改是否有效。希望大伙能够早日认同这个道理
做完底层又要赶逻辑代码,差点回不了家,残念
130 - 进程演算中的事件概念
最近将军团模块的 bug 修的差不多了,可以准备下一步的分布式改造了。只是每次想起这工程量,就有够头大的了。
在修改军团的时候,除了不断增补单元测试,就是思考分布式的交互。不同进程间的交互,一个 rpc 协议就是一个消息,消息间是有严格的先后顺序的,
131 - 青春请你归来,再伴我一会
加班到 12 点,走出公司的时候,发现大街上伴我同行的,只有一大帮小姐了,so sad
持续加班获得的效率红利已经渐渐消失,前面留下的技术债越来越成为前进的障碍。发版本的前一晚,提交频率非常高,经常有人抱怨更新后进不去游戏。客户端没有人搞单元测试,偏偏脚本又无法通过静态编译消灭一部分低级错误。于是,就变成了《唐伯虎点秋香》那一幕:


本周主要做的是公会的公告板系统。一般公会的聊天都是纯文本,只要记得记录就好,但是 coc 的公会还有同意和拒绝这种操作,以及捐兵,而且这两项还是实时推送。推送消息的时候,需要考虑到接受消息人的公会位置,普通成员要过滤掉部分信息。操作主要分成两步,一是修改原有的消息记录,另一个是发消息操作到客户端去。
同时,客户端还解决了一个内存越界访问的 bug。这个 bug 出现在地图寻路的时候,将地图块从脚本层传到 C 层,由于地图块的错误,导致访存越界。这个错误在真机上会不定时崩,在 win 下的模拟器上跑,会报堆访问出错。最终改为在栈上分配这个空间解决。
132 - 再堕噩梦,斩龙之旅

本周继续做公会功能,有点乏味。
这次主要是基于上周完成的框架,进行具体功能的协议对接。原本以为对接会很简单,毕竟之前的功能模块都已经写过单元测试了,虽然覆盖率不高,好歹还是能跑通 happy path 的。实际用的时候,才发现上周设计的 api 粒度太细了。隐约记得第一次做公会,也是犯了这个错误,api 之间是十分正交,每一个完成的功能也很简单,方便测试。但是,用的时候需要调用多个 api,因此需要处理多种错误情况,而没有 goto 语句,又导致需要将同一段错误处理代码多次复制粘贴。
另一个比较头痛的问题,是目前的网络流是异步 IO 模型的,导致一段正常的逻辑需要断开多个函数来写,搞得我思维负担很大,有时候还需要在多个文件间来回切换,工作效率不高。异步回调这个无法解决了,除非引入 coroutine 的模型,可惜目前能力有限,无法向领导层推动这个事情。连游戏的自动测试,都无法推动到商业合作的阶段,真的有点失落。多个文件切换这个,最后用单元测试部分解决了,测好一个函数,对接一个,避免首尾应接不暇轮番报 bug。
为了方便开发,避免频繁更新协议,内部协议采用了 JSON 作为序列化的工具。因此,很多回调函数的参数都是 mapping,类似 python 里的 dict,漏参数在编译器不会报错,运行期会出现各种诡异问题。当年用 python 写公会的时候,没有想到解决办法,总觉得熬过去就好,反正有 QC 保证。现在学聪明了一点,写了个入口检查函数,既然不能在编译期检查,就在运行期加上吧,实际尝试后,发现效果拔群!虽然没有做类型检查,只是检查了 key 值是否有缺失,已经很有帮助了。
另,最近同事在研习 bt 软件,用了一个从网上扒拉过来的 SHA1 算法,然后老是说这个算法改了他的全局变量,导致变量变成一个巨大无比的值。我检查了一下代码,SHA1 里没用全局变量,不可能是别人的误改动。后询问得知,这个错误在 Linux 上不会发生,在 mac 上编译才会出现。前段时间,引擎从 Freebsd 迁移到 CentOS 上的时候,也出现了类似的错误。有可能是内存越界访问导致的,也有可能是某个 unsigned 的类型定义不一样,(不可能,溢出绕回的话不会变成大于 max 的值,如果可以大于 max 就不会溢出了)只是,网上找到的教程都是 Unix 向 Linux 移植,没有反方向的,比较囧
133 - 抄作业的一周
本周主要处理军团的抄袭工作。。。
第二次做类似公会模块的东东了,分功能的时候还算轻车熟路,只是几个管理器之间概念层次不同,组装的时候还真费神。这一块的东西,技术上倒谈不上有什么难度,但是比较繁琐,就怕某个功能点没做好,以后填坑就痛苦了。这次配合着单元测试来搞,每个功能组件都有单元测试配套,然后自己写了一点文档,说明这个模块的组成,各个功能需要实现的目标,希望以后修改会比较方便。
本质上,公会是双向映射的结构,需要公会能查询到会员,还能根据会员属性排序。而会员不仅要能索引到公会,还需要能得到自己的权限表。权限表本身,也是一个可被修改的属性,也就是说,会遇到别人修改你的权限,而你正通过权限表执行某一操作这种情况。刚开始实现的时候,为这问题绕进去了,没想到现在游戏已经是串行化的,不需要考虑同步发生的情况。同一时间,只有一个人能够操作公会,只要处理好串行的情况就好了。
另外一个问题,是功能服务器之间通讯的问题。目前内部 RPC 协议的分发,只提供了一个 json 域给我。这样子可以避免频繁修改内部协议,经常重启服务器。至于这个 JSON 域怎么使用,怎么能够更好的表达业务逻辑,目前还没想好。也许,JSON 里包含操作指令及操作数就可以了?
另,最近朋友做爬虫,遇到一个全 flash 构建的,无从入手,我帮忙搜了一下,原来 adobe 当年推出过 swf2html 这个神器,虽然偶然 bug 掉,但是用来做爬虫实在合适不过了,而且还有 C++ 代码提供。
又另,发现构造 md5 相同的可执行文件已经渐渐变成现实了,参考 http://www.mscs.dal.ca/~selinger/md5collision/,很过瘾,方法有点取巧,evil 逻辑和 good 逻辑都放在同一个 exe 里面,通过一个开关值进行控制,然后开关值构造一下,用两个不同但 hash 一样的 pair 来完成
134 - supervisor 很赞!
最近,公司进行了新的架构设计,原来一个区服一组进程,变成了对外只有一台服,后面 N 组多进程进行服务的模式。于是,管理进程就变成了一个头痛的问题。原来是在写代码的目录里放置各种脚本解决的,关闭脚本,开启脚本,重启脚本,更新脚本,还有一打用来看各种日志的脚本。这些脚本还是严重目录相关的,要执行某些命令,只能 cd 到指定目录执行(或者用硬连接 + 设置脚本所在目录为当前目录解决?whatever)。遇到实际部署的时候,还需要 ssh 到指定机器上,运行指定脚本,有时候还担心服务器起不来,需要人肉 ssh 过去看 status 或者 tail 日志看。
现在,有 supervisor,将所有这些烦恼一扫而光!supervisor 有两个组件:supervisord 和 supervisorctl,组成了 client/server 结构。supervisord 负责读入配置文件,然后以子进程方式启动配置中定义的程序,将对应的 program 进行后台化(daemonize)处理。supervisorctl 则负责和 supervisord 进行沟通,获取运行中的进程信息,包含 pid,uptime 等信息。supervisorctl 既可以通过命令行参数进行控制,又能够直接进入一个特有的 shell,通过这个 shell 管控进程组。这样,既能够让部分同学准确把握进程状况,又能避免放开 shell 权限,一举多得。
以前做服务器逻辑的多并发,采用 gevent 可以很自然对应到逻辑上的并发微线程,但是处理部分游戏逻辑,需要用到锁,有时候还需要跨进程的锁。所以,当时一直很渴望有个网关进程顶在前头,将网络通信先行串行化,然后后台跑起多个不同工作任务的进程,消化不同的数据包。这样,每个进程处理的任务简单,比较容易做到正确和高效。然后没有并发事件,可以避免锁。现在想来,其实这种架构,是将部分业务逻辑的压力,压在了多进程上,名曰分布式处理,实际运行时,对进程的管控需求会提高,增加了运行时管理的难度。比如,一般需要一个 master 管理这种异质进程,控制其生生灭灭。
使用 supervisor,可以简化进程管理这方面的压力。但是,部分跟业务逻辑相关的进程生命周期,还是需要主动干预。哪些情况下,进程被关闭是正常,什么情况下需要重启进程,还是需要费心搞清楚的。幸而 supervisor 给了一个不错的思路。剩下的就是多服务器配置的生成和管理了,希望能找到可靠的开源工具。
135 - 添加 mongodb 支持
最近花了些时间,将引擎的存储换成了 mongodb。
私下,我觉得现有的存储机制极为落后。现在写数据的操作交由单独的进程完成,该进程兼当数据缓冲与持续化数据的责任。此次引擎的更换,只是简单的利用 mongo 的官方 c 驱动,将数据打到 mongo 里面,代替写文件的做法而已。该进程的数据缓冲角色,还是没有变化。mongodb 的优势在于对内存的高效利用,增加一层作为中转,就会失去这个速度上的优势。
往引擎里添加 mongo,比较头大的是跟引擎脚本的类型系统打交道。比较了一下 BSON 支持的数据格式,能够比较好的容纳引擎的数据。但是引擎的关联数组(类似 python 的 dict)和异构数组,在 C 层用起来不太方便。引擎这边的类型,都是用一个 svalue 进行封装,里面用 union 包装 int、float 等基础类型,以及字符串指针和数组等引用类型。但是,svalue 的打包却需要手工做,没有封装方便的打包函数。关联数组的使用还算方便,只要构造好 key 和 value 的 svalue 值,调用 find_for_insert,然后 assign_svalue 就可以了。
剩下的主要是对象的生命周期管理。连接对象由数据库连接池进行管理,如果多线程读写时有线程 hang 住,该连接就不会被释放了。用于传送数据到数据库的 bson 对象,会在每次传送完成后被释放,这里应该没有问题。从数据库序列化为引擎的数据对象时,产生的关联数组等数据交由 vm 进行管理,这块是通过引用计数做的,要分析泄漏的问题,可能要结合具体的脚本进行分析了。
性能方面,还没有进行测量,打算通过 Dtrace 或者 SystemTap 进行,顺便用 valgrind 做做内存泄漏检测。瞎猜测一下,socket 进行数据中转和序列化对象可能会是瓶颈。
136 - TheimplementationofLua5.0 阅读笔记(二)
6 线程和协程
读完这篇文章我才意识到 python 的协程到底缺了什么,这个就是 coroutine 和 semi-coroutine 的区别了。区别就是,semi-coroutine 只能返回(yield)到调用者所在位置,不能将控制权交到任意其他协程上去。具有这个特征的,都是 semi-coroutine。
Lua 实现协程的时候,充分利用了其 C 栈和 Lua 栈。进行协程调用的时候,解释器会在 C 栈上会进行一次递归调用,然后协程自身的栈在新建立的 Lua 栈里消长。当一个协程结束的时候,解释器会退出,返回调用者(即上一个解释器)。注意,这里是一个协程对应 C 栈上的一帧。与之相反,参考经典的 CPython 实现 ,每一次 python 的函数调用都会产生一层新的 C 栈,因此,python 的函数调用受 C 堆栈大小的限制。Stackless Python 之所以声名大噪,就是因为解决了这个问题,只有 tasklet 才会在 C 栈上产生新的栈帧。
作者还提到,这里实现协程的时候,比较棘手的地方是嵌套调用时如何处理外部的局部变量,因为存在协程时,很可能会出现一个函数引用的局部变量存在于另一个协程栈中。而这个问题,因为 Lua 的 upvalue 而被完美解决了。
7 Lua 的虚拟机
Lua5.0 之前的版本,使用的都是基于栈的虚拟机,直到 5.0 才转为基于寄存器的虚拟机,Lua 是第一门大规模使用寄存器虚拟机的工业级语言。
不过要注意的是,不是说基于寄存器的虚拟机就不需要使用栈,Lua5 依然有使用栈。栈上会分配栈帧用来存放寄存器,局部变量也都在寄存器中。基于寄存器的意思是,对于 Lua 函数的参数传递,不再需要繁琐的入栈和出栈操作了。作者顺带讨论了一下寄存器虚拟机的两个性能问题,包括生成的虚拟机代码大小以及指令解码的开销。和 Java 的 jvm 做了对比,结果是难分伯仲之间,寄存器机器会稍胜一筹。
Lua 的一条指令是 32 位,指令的布局可以参考下图:

指令是三地址码的格式,A 是存放结果的寄存器,B 和 C 就是操作数。由于指令长度的限制,如果想在一个指令里完成一个跳转语句,跳转的范围就会受到限制。因此,Lua 将条件语句变成一个 test 语句和紧接着的 jump 语句来解决(跟汇编很像 ^_^)。
这节里还提到寄存器窗口,不过没看懂。维基了一下,寄存器窗口是指实际寄存器数目会比可用寄存器数目要多,不同的函数调用,他们看到的同名寄存器可以是不同的寄存器。比如 func1 使用了 AX 和 BX,func2 也同样使用 AX 和 BX,不过实际上寄存器有 4 个,func1 递归调用 func2 的时候,func2 使用的 AX 和 BX 是 func1 以外的两个。
137 - TheImplementationofLua5.0 阅读笔记(一)
没想到 Lua 的作者理论水平这么高,这篇文章读的我顿生高屋建瓴之感。云风分享了一篇中译:http://www.codingnow.com/2000/download/The%20Implementation%20of%20Lua5.0.pdf
全篇的主题有 4 个:1. 基于寄存器的虚拟机;2. 用于将 table 作为数组使用的新算法;3. 闭包的实现;4. 以及协程。第二点我关注不多,会写的比较简略。
1 简介
简介主要就是说,我们搞 Lua 嘛,就是一个实验室出来的产品,没想到今天在工业界特别是游戏界红得发紫,这主要是得益于 Lua 轻灵小巧,注重可移植性。除了上面提到的 4 点,这篇文章还有一些铺垫的章节,帮助你们理解我们这个牛逼哄哄的东西。(这些铺垫的东东也很牛逼,建议参考中译)
2 Lua 的设计和实现
我们写的 Lua 简洁,高效,可移植,非常容易嵌入。
3 Lua 的类型系统
这段看代码比较简洁:
作者顺便扯了一下对象的装箱拆箱,嘲笑 python 的实现比 Lua 要慢。
4 Lua 的 Table
牛逼的地方在于,如果 table 是当 array 用,数字的 key 比较紧凑,我们就会拿一个真实的数组去储存它,即省空间又快速,如果是当成单纯的关联组来用,那么数组部分则不会分配,避免浪费
5 函数和闭包的实现
闭包在 lua 里应用得非常广泛。每一个函数都会被编译成一个 prototype 作为原型。实际执行的时候,则会为其生成一个闭包,包含了对函数原型的引用,对全局变量的引用表,以及对 upvalue 的引用(用来访问外部的局部变量)。
以函数为第一类对象,以及带词法作用域的语言,大多会遇到外部局部变量访问的问题。考虑下面的例子:
当调用 add2 的时候,add 函数已经返回,那么 add2 函数体内的 x 会不会随着 add 函数的退栈而被销毁呢?如果不被销毁,又应该如何保存这个变量呢?
Lua 巧妙的使用了 upvalue 解决这一问题,参考下图:

每当创建一个新闭包,Lua 就会检查外部定义的局部变量是否有加入 upvalue 链表,如果没有就创建一个 upvalue 加入双向链表里。所有对外部定义的局部变量访问,都是通过 upvalue 的指针进行间接访问的。当外部函数退出时,因为函数退栈,局部变量被清理,这时候局部变量就会被转存在 upvalue 的值域里,然后把 upvalue 的指针指向自身的值域。对于定义局部变量的函数,这些局部变量还是栈上的元素,不许通过 upvalue 访问。
对于多层函数嵌套的情况,当一个函数需要访问的变量不在上一层函数的局部变量,就访问上一层函数的闭包。闭包具有传递性,会由外部函数传递到内部。
138 - 移动安卓端网络库开发
最近在协助客户端做网络通讯和登录流程,增进了对 Lua 的了解,捣鼓 Libevent 的静态库编译,掌握了部分 Android NDK 的开发技巧。真机调试遇到一个比较大的问题,由于资源较大,打包出来的 apk 有 100M大小,每次因为一个语法错误或者路径大小写问题,导致重新写 apk,都有种吐血的感觉。因此,想搞个热更新的框架和联机远程调试的 Lua 调试器。
另外,由于项目预期只有短短 3 个月的开发时间,时间管理方面遇到比较大的问题。客户端的主程又死抱着 C++ 的那套对象思想,跟其他开发人员有冲突,如何协调好人际关系,以最大限度发挥大家的能力才干,完成开发目标,实在是前所未有之挑战。
目前,主力使用的客户端引擎,是依赖 cocos-2dx 开发的 quick-cocos2dx,它将所有底层系统相关的内容都打包成一个 player,方便页游的同学转过来进行开发。只是,内置的 cocos-2dx 有点老旧,部分新功能没有,需要等待每月一度的 quick-cocos2dx 版本更新,而且开发人员较少,活跃开发者似乎只有 3 个,有点忧心。未来希望能有时间投入该开源项目的开发,而不是只提 issue。
139 - 从 lua 调用 C 函数
最近在进入 Lua 编程的状态,一度令我困惑的是,Lua 提供的功能少的可怜,跟自备电池的 python 相比,可说是简陋了。连 table 的打印,都需要自己实现,也因此有了一打的第三方方案。后来我想明白了,以 Lua 和 C 如此紧密的关系,只需要建立 Lua 的 binding,那么丰富而性能强大的 C 库资源完全可以为 Lua 所用,这样就不愁功能缺失了。
关于 C 调用 Lua,前段时间已经写过一篇短文了:《多语言协作与二进制交互》,现在补上从 Lua 调用 C 的这一篇。先上一段 Lua 代码:
在这段代码里,我引用了一个 power 模块,并且调用了 power 模块里的 square 函数和 cube 函数。由此可知,在 C 语言编写的 power 模块里面,需要有相关的函数可以注册本模块提供的函数,并且让 Lua 可以感知到自身是一个模块。回忆一下 Lua 的路径搜索,可以看到除了后缀名为 *.lua 的文件之外,还有 *.so 文件,所以 C 扩展是编译为 .so 的。实际情况是,在执行 require 语句的时候,系统会调用 luaopen_power 函数,这个函数名是通过 luaopen_ 与 power 这个模块名拼接得到的。
现在看看 luaopen_power 函数的定义:
可以看到,通过调用 lua_register 函数,我们在 L 这个 lua 虚拟机里面注册了两个函数,一个是 square,一个是 cube,他们分别对应到 isquare 和 icube 这两个 C 函数。
回过头来看一看,lua 脚本里,这条简单的 require 语句,执行了两个步骤:一是先把名字为 power.so 的文件加载起来,二是调用其中的 luaopen_power 函数。下面来看一下具体的函数如何定义:
注释的讲解比较详细了,可以看到为 Lua 定义的 C 函数格式都是比较统一的,首先接受一个 Lua 虚拟机变量 L,然后从 L 里取出相应的参数(需要指定数据类型),最后将返回值再次压回虚拟机里面,通过返回 int 告诉 Lua 虚拟机,自己的返回值有多少个。
好,到这里就只差最后一步了,现在把这段 C 代码编译成 .so 文件。使用如下的编译参数:
(hellofunc.c 记得要 include lua.h, lauxlib.h, lualib.h 三个头文件哦)
这里解释一下两个参数的意思,-shared 是告诉 gcc,需要编译成 .so 文件,并且这个源文件里面不会有 main 函数,不要大惊小怪。另一个 -fPIC,是 Position Independent Code 的意思,具体的含义可以参考 这篇 ,主要用来避免同一份代码因为重定位位置不同而在内存中存在多个实例。
调用的结果:
当然,如果机器安装有多个版本的 Lua,需要指定执行 hellofunc.lua 的 lua 解释器版本。因为本篇教程是针对 Lua5.1 的,所以需要指定 Lua5.1 来执行,例如 lua5.1 hellofunc.lua,否则用 lua5.2 调用会引起 core dump
140 - 新的开始
原项目没有上线的机会了,停止开发,伤心了好久。目前转到手机开发上去了,使用开源的 cocos-2dx 引擎,貌似坑比较多啊
141 - 外服部署时遇到的问题
吐槽一下,公司的权限给的很死,部署的时候麻烦事比较多,趁手的工具需要自己手动编译,无法利用 port 安装。
昨天遇到一个外服部署的问题,表现为外服不能登陆,用部署工具重新发布代码后,仍然如此。于是联系运维的同学进行处理,运维的同学帮助排障时发现引擎启动报错,提示 rc/simul_efun must be loadable,认为是代码的问题。回去检查代码后,没有发现问题,而且这个文件已经很长时间没有更改了,怀疑是编译的问题。后来,手动连接外服,将验证服务器跑起来了,但是游戏服依然提示同样的错误。最后通过备份代码,然后用验证服的代码加游戏服的配置启动成功。但是,对于这个错误还是很耿耿于怀,于是找公司的前辈帮忙排错,发现发布代码的过程里漏了一个关键的步骤,补上后似乎没有问题了。
今天回想一下,感觉下次还是有机会出现上述的问题。首先,是引擎的报错太具有误导性,如果是代码缺失,就应该提示文件不存在或代码缺失,而不是代码有错误。(究竟是不是代码的问题,周一回去以后还要再次确认)其次,是我发布的时候粗心大意,这个应该通过更傻瓜化的工具解决,内网发布时我已经写了点 bash 脚本进行一键发布了,但是外服运行环境不同,还需要修改一下。再次,是发布工具的效率问题,一个是提示信息含糊不清,第二个是杀进程时只会 sleep 等待,不会主动监控进程运行状态。
关于外服内服环境不同,这个还要再吐槽一下。外服上运行的是 9.0 的 Freebsd,内部测试服则是 8.2 的,内部测试服同时兼任打包服务器、发布服务器的角色。在 9.0 的系统上编译得到的引擎,无法在 8.2 的系统上面运行。而指定发布机器时,外服和内服又是同一个标签之下的,也就是说,更新外服的话内服的引擎版本就错了,内服更新时,外服的引擎版本也会错。这个问题已经足够致命了,更致命的是打包发布脚本提示信息是可以通过 hostnum 指定机器的,但实际上却不可以,真让人抓狂。以后打算把游戏逻辑的 svn 版本和引擎代码的 svn 版本都打包到代码里面,可以在运行时查询,否则发布脚本的错误会导致大问题。
另外,公司的 svn 服务器证书过期,最近一段时间至少引起了 3 次问题,主要是策划利用热更新通过 svn 拉取数据表更新时出现。因为 svn 密码不允许明文保存,所以设置了 store-passwords = no。面对证书问题,会出现拒绝,暂时接受,永久接受。选择永久接受后,就一直出现 svn: E175002: Unable to connect to a repository at URL,但是证书错误的原因反而没有提示。干掉 ~/.subversion 目录后,再次出现证书的问题,每次选择暂时接受就可以正常 checkout 了。store-password 选项影响到 subversion 对证书的选择,好奇怪
142 - 迅捷 FASTFWR171-3G 实战 OpenWRT
FAST 是 TP-LINK 的一个子品牌,所推出的 FWR171-3G 与 TP-LINK wr703n 的硬件采用相同规格,而前者要便宜 20 块,区别只在品牌、外观与软件界面。于是果断入手,然后尝试 OpenWRT。
上手后第一件事,就是通过官方界面进行线路测试。目前的网络连接是,通过 RJ45 接口接入光猫进行 PPPOE 拨号,然后利用 wifi 信号完成无线路由功能。遗憾的是,通过官方界面进行拨号连接时提示密码错误,无法联通。于是,去找到了 wr703n 的固件刷上,文件是 wr703nv1_cn_3_12_11_up(110926)(Fast-FWR171-3G).bin 注意上传过程比较慢,上传和设备重启中不要断电或断开连接。
上传完成后,登入看到经典的蓝色 TPlink 界面,继续进行线路测试。经过测试,成功通过光猫 PPPOE 拨号。接下来就要进行 OpenWRT 的刷写了,首先下载文件 openwrt-ar71xx-generic-tl-wr703n-v1-squashfs-factory.bin 升级,注意,升级完后就没有 web 界面了,若对命令行有畏难情绪,请谨慎操作。刷入后,就只能通过 telnet 连上,然后通过 passwd 指令设置 root 的密码,输入密码的时候默认没有回显,是正常情况,提示密码较弱的可以忽略或更换更高强度密码。使用 passwd 设置密码后,以后就不能用 telnet 进行连接,需要用 ssh,在 windows 下操作建议用 putty。
当时走到这一步,由于懒 / 疏忽,没有进行 squashfs-sysupgrade.bin 的刷写,然后就直接接入网络了,结果 pppoe 死活拨不上号。要实现前文所述的拨号方案(pppoe+wifi 路由),需要修改 /etc/config/wireless 文件:
config wifi-device ‘radio0’ option type ‘mac80211’ option hwmode ‘11ng’ option path ‘platform/ar933x_wmac’ option htmode ‘HT20’ list ht_capab ‘SHORT-GI-20’ list ht_capab ‘SHORT-GI-40’ list ht_capab ‘RX-STBC1’ list ht_capab ‘DSSS_CCK-40’ option txpower ‘17’ option channel ‘6’
当然,radio0 的 disable 一行需要删掉或注释掉,注意文件中的注释即可。
以及修改 /etc/config/network:
(有博客表示 eth0 就是 wan 口,这是不对的,eth0 表示的只是以太网口,eth1 是另一个以太网口,对于 wr703n 来说不存在,wlan0 则是无线网卡口)
设置后一直无法上网,也没有办法装 luci web 管理界面。因为没有刷入 sysupgrade 的时候,内核不支持 PPPOE!!!可以通过 lsmod 查看当前加载的内核模块,insmod 安装内核模块。openwrt 的模块管理位置有点奇怪,还没找到。。。
由于一直卡在这步,我就反复改这两个文件,结果改错了进不了路由器。于是,只好自己焊接 ttl 线进行救砖。救砖前已经尝试过开机时快速插拔 reset 孔,无果。。。
手残只能焊成这样:

(左侧是信号地,右侧黑色是 TP_IN, 黄色是 TP_OUT, 对应的是 RX, TX)
通过 USB 转 ttl 线,成功连入路由器改回正确的配置,然后通过 dhcp 先安装好 luci,刷入 sysupgrade 即可。当然,更好的办法应该是在本机开启 http 文件共享,利用路由器的 wget 进行下载,用 mtp 进行刷写。
现在,路由器已经可以通过 rj45 接口顺利 pppoe 拨号,并通过 wifi 共享,不过挂载硬盘有问题,估计是驱动的问题,但 rom 太小装不下驱动了,以后试试 u 盘增加容量后再刷驱动。。。
143 - 游戏服务器设计的思考
gevent 并发模型:缺点:多玩家交互的时候需要使用锁,bug 比较隐蔽。进行耗时较长的查询时有可能某些资源已经过期,也需要使用锁保护。
Mudos Like: 优点:游戏逻辑进程同一时间只处理一个玩家的一个请求 缺点:与玩家交互比较密集的时候需要用到异步回调,需要从磁盘读数据的时候要异步回调,搞得写函数很恶心。而且回调函数里需要把前面的检查再做一次,跟 gevent 的并发模型比较没有了优势。
展望 erlang: 将游戏的功能按服务的方式提供,不提供服务时就关闭进程,进程间用消息机制解耦合,方便处理服务重启的情况。能够保证最小服务提供的情况下稳定长时间运行。
144 - 多语言协作与二进制交互
最近刚刚完成了服务器端 rpc 协议的 python 封装,理论上说,后续的开发可以以 python 继续进行了。只是代码热更新还没好,项目进度又吃紧,暂时先放下了。利用 rpc 协议连接不同进程,各个进程就可以自由选择语言去开发,不局限于 C、LPC 了。让项目能够充分利用各个语言的优势,在不同的场景下选择特长语言进行开发,这图景不错。
而客户端所用的 Lua 脚本,则是以另一种方式实现了多语言协作开发。通过精巧的 Lua API,C 层可以将一些灵活多变的逻辑操作转交给上层的 Lua 逻辑去完成,而 Lua 里的计算密集型的东西也可以放到 C 层去完成。
我一直很好奇的是,C 到底要怎么告诉 Lua,我调用的是 XXX,我给你传递一下参数 A,类型是 YYY,值是 ZZZ。这跟我刚实现的 RPC 协议是十分类似的,但是 Lua 面向的是嵌入式设备,计算能力受限,估计不会采用 socket 进行中转。尤其是,当需要传递的不单是基础类型如 int、string,还有映射表,列表等较为复杂的数据对象时,怎么实现这种转换呢?
Lua 采取的是利用栈进行交互,利用各种 Lua_pushXXX 将不同的值压入栈中,然后调用 Lua 脚本时自然会退栈取出参数运行,对于 Lua 的虚拟机来说,就像是发生了一次正常的函数调用。(这里采用的栈是 Lua 栈,因为若是 C 栈的话调用 Lua 的 C API 就会出错了。)需要注意的是,Lua 栈状态需要自己进行维护,若发生多线程同时对 Lua 栈操作,没有加锁保护的话会导致栈状态混乱然后出很诡异的 bug。
关于 Lua 调用 C 的函数,还没做完实验,稍后再补充。
145 - 从一段代码里看 FreeBSD 与 Linux 内存分配的不同
唉,拖延症无以复加了。
最近,公司移植服务器端游戏引擎到 Linux 上的时候,遇上了段错误。问题代码大略如下:
很明显,对操作系统分配的内存块进行了指针操作后,再扔回到 free 函数进行释放,是会导致异常行为的。但是,该引擎的代码已经有较长的历史了,为什么在 FreeBSD 上没有遇到问题呢?
这主要是因为 FreeBSD 与 Linux 的内存分配机制不同引起的。
146 - 存储器性能测试

Xeon E5620

E7500

In virtual machine, E7500
最近做了个存储器性能测试,结果如上图。z 轴表示速度,单位是 MB/s, x 轴和 y 轴一个表示步长,即两次访问数据之间的距离;另一个是读写的数据总量,单位是字节。源代码可以通过 http://csapp.cs.cmu.edu/public/1e/public/mountain.tar 获取。
这个测试是 CSAPP 书里用来说明存储器山的一个实验。关于这个测试,有两个基本的概念:时间局部性与空间局部性。
时间局部性:
空间局部性:
147 - 欢送 2012
新年快乐!2012 年就要过去了,本月看代码为主,少动手了,分享两篇文章给大家:
第一篇是 varnish 作者 Poul henning 写的,题为 Notes from the Architect,作者的观点可以总结为三点:
- 相信虚拟存储系统,不要手动进行内存分页管理,而是依赖虚存系统做这件事。不要和虚存系统作对。
- 减少内存的访问次数,最小化多核心之间对于 cache 的争夺。
- 合理调度线程,按最近工作时间来安排,尽可能保证 cache 已处于热身状态。
另一篇是 LuaJit 的作者 Josh Haberman 在邮件列表里提到的, 为什么手写的汇编码会比编译器的好 。作者着重讨论的,是编译器的主循环实现。由于编译器难以预测数以百计的可执行路径中,那个是快速路径,那个是慢速路径,走哪一个路径的概率比较大,所以无法很好的生成优化的汇编码。由于条件分支判断失败引致的惩罚较大,因此手写汇编码的确有可能做得比编译器好。
这两篇文章的启迪在于,现代意义上的编程,已经不再是单纯业务逻辑的考虑,而要通盘考虑计算机系统的储存器结构和 CPU 指令优化。看来还是要看底层一点的东西了。
148 - tig 支持中文搜索
tig 是一个基于 ncurses 库的 git log、status 的浏览器,看 log 的时候非常方便,可以非常简单的查看每次 log 的 diff,同时方便的切换到其他视角例如 diff、blame、tree 等等。但是,tig 有一个问题,不支持搜索中文。
检查了相关的 issue 以后,确认了链接时使用 -lncursesw,支持中文这种宽字符的显示,实际应用中也可以显示,但就是没办法搜索中文。于是,我向作者报告了这个 bug:https://github.com/jonas/tig/issues/99
似乎作者不太在意 i18n 的问题,等了好几天都没有给答复,只好自己动手了。遇到问题的是搜索,按 search 关键字查找,定位到 REQ_SEARCH 上面去,这应该是 tig 内部状态机的一个状态。在 main 函数里,是一个很清晰的状态机,用 switch 语句切换不同的状态。可以看到,REQ_SEARCH 与 REQ_SEARCH_BACK 都调用到 read_prompt, 最终落到 prompt_input 读取输入。
看来 prompt_input 就是无法输入中文搜索的罪魁祸首了。得益于 tig 代码清晰的结构,定位这个 bug 还是比较容易的。为了确定用户输入的结束,prompt_input 通过一个外部参数 handler 确定一个字符是否是可见字符,如果是不可见字符,则不加入到 buf 中来。由于 utf8 的字符是变长的,兼容 ASCII 码,剩下的都是两字节字符和三字节字符。区分字长,则由第一个字符(又称引导字符)决定。
关于 utf8 的字符是如何区分两个字节和三个字节,可以参考这篇文章:
http://blog.csdn.net/cscmaker/article/details/7986968 (囧,看完才发现我修复的不完美)
根据这篇文章,我做了一个小的修复:
https://github.com/spin6lock/tig/commit/159eff692b24aa05f766f76922b0f2515fbbf415#tig.c
这里将 utf8 字符单独处理了,但是没有处理 utf8 标准里 4 个字节字符的情况。
不过作者一直没有 merge 到主分支上,残念啊。
149 - 为什么 go 语言适合开发网游服务器端
前段时间在golang-China读到这个贴:有木人用(或打算)golang做游戏服务器端? 个人觉得golang十分适合进行网游服务器端开发,写下这篇文章总结一下。
从网游的角度看: 要成功的运营一款网游,很大程度上依赖于玩家自发形成的社区。只有玩家自发形成一个稳定的生态系统,游戏才能持续下去,避免鬼城的出现。而这就需要多次大量导入用户,在同时在线用户量达到某个临界点的时候,才有可能完成。因此,多人同时在线十分有必要。
再来看网游的常见玩法,除了排行榜这类统计和数据汇总的功能外,基本没有需要大量CPU时间的应用。以前的项目里,即时战斗产生的各种伤害计算对CPU的消耗也不大。玩家要完成一次操作,需要通过客户端-服务器端-客户端这样一个来回,为了获得高响应速度,满足玩家体验,服务器端的处理也不能占用太多时间。所以,每次请求对应的CPU占用是比较小的。
网游的IO主要分两个方面,一个是网络IO,一个是磁盘IO。网络IO方面,可以分成美术资源的IO和游戏逻辑指令的IO,这里主要分析游戏逻辑的IO。游戏逻辑的IO跟CPU占用的情况相似,每次请求的字节数很小,但由于多人同时在线,因此并发数相当高。另外,地图信息的广播也会带来比较频繁的网络通信。磁盘IO方面,主要是游戏数据的保存。采用不同的数据库,会有比较大的区别。以前的项目里,就经历了从MySQL转向MongoDB这种内存数据库的过程,磁盘IO不再是瓶颈。总体来说,还是用内存做一级缓冲,避免大量小数据块读写的方案。
针对网游的这些特点,golang的语言特性十分适合开发游戏服务器端。
首先,go语言提供goroutine机制作为原生的并发机制。每个goroutine所需的内存很少,实际应用中可以启动大量的goroutine对并发连接进行响应。goroutine与gevent中的greenlet很相像,遇到IO阻塞的时候,调度器就会自动切换到另一个goroutine执行,保证CPU不会因为IO而发生等待。而goroutine与gevent相比,没有了python底层的GIL限制,就不需要利用多进程来榨取多核机器的性能了。通过设置最大线程数,可以控制go所启动的线程,每个线程执行一个goroutine,让CPU满负载运行。
同时,go语言为goroutine提供了独到的通信机制——channel。channel发生读写的时候,也会挂起当前操作channel的goroutine,是一种同步阻塞通信。这样既达到了通信的目的,又实现同步,用CSP模型的观点看,并发模型就是通过一组进程和进程间的事件触发解决任务的。虽然说,主流的编程语言之间,只要是图灵完备的,他们就都能实现相同的功能。但go语言提供的这种协程间通信机制,十分优雅地揭示了协程通信的本质,避免了以往锁的显式使用带给程序员的心理负担,确是一大优势。进行网游开发的程序员,可以将游戏逻辑按照单线程阻塞式的写,不需要额外考虑线程调度的问题,以及线程间数据依赖的问题。因为,线程间的channel通信,已经表达了线程间的数据依赖关系了,而go的调度器会给予妥善的处理。
另外,go语言提供的gc机制,以及对指针的保护式使用,可以大大减轻程序员的开发压力,提高开发效率。
展望未来,我期待go语言社区能够提供更多的goroutine间的隔离机制。个人十分推崇erlang社区的脆崩哲学,推动应用发生预期外行为时,尽早崩溃,再fork出新进程处理新的请求。对于协程机制,需要由程序员保证执行的函数不会发生死循环,导致线程卡死。如果能够定制goroutine所执行函数的最大CPU执行时间,及所能使用的最大内存空间,对于提升系统的鲁棒性,大有裨益。
150 - LPC 及 MudOS 简介 ( 一 )
天下盛境这个项目让我萌生退意了,拖延了一个多月,没想到公司居然先解散了。接着是面试,入职新公司,回头看来,还是感慨人算不如天算阿。
新公司也是游戏行业的,初看了下项目的架构,与以前的有较大差别,是一套脱胎于 MudOS 的异步 IO、多进程的游戏架构。于是最近在研究 Mudos 的相关知识。刚刚入门,挑了最简单的 Lil Mudlib 进行学习,Mudos 的版本为 v22.2b14,既能够成功跑起来接受玩家的链接,又不会有复杂的功能阻碍理解,正好动手边改边学。
LPC 是一门专门为 Mudos 而设的脚本语言,类 c 语法,而且后缀名均为 c(这点比较让我困惑,搞不清什么是 c 什么是 LPC)。已经习惯了 Python 的我不太适应变量声明,幸好最近用 go 做了点小东西,不至于对类型系统太生疏。这门脚本语言主要是用来写逻辑的,所以很多接口都是基于底层用 c 写就的 mudos 接口。基本的 hash 表,字符串处理等都有了,可惜提供的库实在太少,不利于基于这门语言自身去了解它。比如说,python 里用 globals() 和 locals() 就可以查看当前的变量空间,有比较丰富的反射机制。而 LPC 不是没有,而是没有直接提供出来供调用,它是利用 mudos 做解释器的,类似的反射功能都需要调用 mudos 来完成。进一步来说,LPC 是用来定义和管理对象的,而这些对象的相互作用最终还是要通过 mudos 来完成。
LPC 的 OO 跟 go 语言有点相似,就是函数和变量组成。函数就是可以用名字来引用的一组指令,而变量则是供函数使用的储存信息用的容器,一个 lpc 文件对应的就是一个类的定义(这点非常喜欢)。它的类型系统还提供了一个特殊类型 mixed,类似于 go 语言的万能接口,可以存放任意类型的变量,同时可以在后期查到该变量的真正类型。
LPC 的虚拟机,即 Mudos,还提供了一个有用的功能,任何对象的执行都会被进行统计,同一调用链中,若某对象用完了所分配的时间线,就会被强制停止。这个功能有点类似 python 的 gil,任何线程都不能长期占用 gil,即使只有单线程,还是有 gil 的获取和释放过程。
151 - 大面积断线原因分析
昨天,在台服上运行的服务器爆发了大面积断线。从时间点上看,跟一个副本活动高度重合,因此,今天早上就紧急屏蔽了该活动模块。
拿到 log 进行分析,看到的异常大部分是从战斗副本返回主城时发生的。副本活动产生的异常倒是没有看到,而且这个副本在国内也经历过几个运营商实际运营的测试,出现问题的机会应该比较少。
从战斗副本返回主城的过程经过一次调整,原有的流程是副本退出时保存到 mysql,再在主城里从数据库恢复过来。现有的流程,是先把所需数据打包,然后通过 tcp 发送到主城,由主城进行解包并恢复到角色身上。
个人猜测,是因为序列化过程有性能问题,导致序列化过程缓慢。这个副本活动有个特点,就是同时返回主城的角色会比较多。因此,当多个角色同时返回时,主城进程就会因为序列化而卡住。客户端与主城间有保持心跳连接,当发生心跳包超时,客户端就自动断开连接。断开连接后,需要将角色数据保存至数据库,这无疑加重了主城进程的负担。于是,雪崩效应就形成了。
下午,主程发布了修复,是序列化过程里,用于标识序列化属性的列表不断增长导致的。于是,每次检查属性是否需要序列化的时候,都要遍历一个极长的列表,所以极为缓慢。问题解决
152 - 断线与资源释放
断线先不释放资源,待刚刚收到的请求完成后,再统一回收资源
开发框架应该提供一套通用的日志监控接口和资源分配接口,以确定资源的消耗情况,确定性能热点。
153 - RPC 的思考
基于 google protobuf 的 rpc 框架介绍系列文章
目前,基于消息包的消息收发
步骤:确定前端需要的相关信息
定义交互步骤
编写相应的 proto 文件
编译,分别生成前后端代码
层次太低。对前后端交互的思考,是在函数调用的层面上的,但是实际上做的,却是将函数调用手动转为数据包。针对具体传递的消息编写消息包的 proto,本无可厚非。但是,每次都要编写内容为空的 Request 包让我很蛋疼。究其原因,是每次都需要重写 Request/Response 语义的东东。
语义:基于函数调用
空参数的函数调用
空返回的函数调用
154 - 【翻译】HowwemakeGitHubfast( 我们如何让 github 更快 )
译者注:我是一名开源爱好者,十分喜爱 github,github 也是一个乐于分享的站点。这篇文章介绍了 github 为应对更高访问量而搭建的架构,虽然已经是 09 年的文章,仍有一定的参考价值,因此翻译此文分享给大家
[ 我们如何让 github 变得更快 ](https://github.com/blog/530-how-we-made-github-fast)
Translations: Беларускі, Deutsch, Русский. 现在工作已经上了轨道,我想和各位分享一下,为了让 github 更快速,更具扩展性,我们在 github 架构上作的改动。
在这篇文章的第一版里,我花了相当长的篇幅,仔细解释我们所做的每一个技术选择。但是,这篇文章迅速变得混乱,演讲与关于架构的讨论混在一起。所以我决定先简单的解释架构本身,再通过随后的文章详细解释我们做出的技术选择。
现代 web 应用有很多扩展的方式。我这里描述的只是我们所选择的那种。这不应该被视为唯一的扩展方式。请将之视为一个独特的案例,满足我们单一需求的案例。
理解所用协议
我们向最终用户开放了三种协议 : HTTP, SSH, 和 Git. 当使用网页浏览器上网时 , 你使用的是 HTTP 协议 . 当你 clone,pull 或者 push 去一个私有的 URL 例如 git@github.com:mojombo/jekyll.git 时,你在使用 SSH 协议 . 当你 clone 或者 pull 一个公开的 URL 时,例如 `git://github.com/mojombo/jekyll.git`, 你在使用 Git 协议。 要了解这个体系,最简单的方法是跟踪这些请求是如何在系统内传递的。跟踪 HTTP 请求
在这个例子里,我将向你展示,对 [http://github.com/mojombo/jekyll](http://github.com/mojombo/jekyll) 请求一页树状图时发生了什么。从互联网上来的请求,首先会到达负载均衡器。对于这个任务,我们使用了一对跑着 ldirectord 的 Xen 实例来完成。暂且将其称为 lb1a 和 lb1b. 任何时间里,这两台机器都有一个处于活动状态,另一个时刻准备进行故障切换。负载均衡器没有做什么神奇的事。它只是负责把 TCP 数据包根据来源 IP 和端口转发到不同的服务器,并且负责清理负载池里的异常服务器。当池里没有任何可用的服务器时,负载均衡器将返回一个简洁的静态页面(而非拒绝连接)。
对于主站的请求,负载均衡器会把你的请求传到 4 个前端机器的一个。这些机器的配置,都是 8 核心,16G 内存的裸机环境(bare metal server)它们称为 fe1, , fe4。Nginx 负责接受连接,并将其发往 Unix socket,这个 socket 是通过 16 个 Unicorn 工作进程支持的。16 个 Unicorn 工作进程的其中一个,会调用 Rails 代码完成请求。
很多页面需要数据库查询。我们的 MySQL 数据库运行在两台 8 核心 , 32GB 内存的裸机服务器上,配备有 15k RPM SAS 硬盘。 它们是 db1a 和 db1b.。它们在任何时候,均处于一主一从的状态。MySQL 同步是通过 DRBD 完成的。
如果一个页面需要 Git 仓库的信息,而这个信息不在缓存中,那就会调用我们的 Grit 库获取数据。为了适应我们的 Rackspace 设置,我们对 Grit 做了一点修改。我们首先把所有需要访问文件系统的调用都封装到 Grit::Git 对象身上。 然后将 Grit::Git 替换为一个通过 RPC 调用 Smoke 服务的桩 (stub) Smoke 对仓库有直接的磁盘访问权限,从而把 Grit::Git 封装成一个服务。Smoke 意即云中的 Grit。
Grit 桩对 smoke 发起 RPC 调用,经过负载均衡发送到 fe 上。每一个前端跑了四个 ProxyMachine 实例,处在 HAProxy 后,扮演着 Smoke 调用的路由代理的角色。ProxyMachine 是一层内容敏感的 (OSI 第 7 层 ) TCP 路由代理, 我们可以通过它使用 Ruby 编写路由算法。 代理服务器将每个请求中的仓库所属用户名抽出。然后我们会调用一个鉴权库 Chimney ( 意为烟囱,与前文的 smoke 语带相关 ) 来定位到用户。一个用户的路由表项就是用户仓库所在的文件服务器的主机名 (hostname)
Chimney 的路由项是向 Redis 查询得到的。Redis 在数据库服务器上面运行。我们将 Redis 用作一个 key/value 对持续化储存的数据库,储存路由信息和其他丰富的信息。
一旦 Smoke 代理发现了用户的路由项,就会建立一个到文件服务器的透明代理。我们有四对文件服务器。他们的名字是 fs1a, fs1b, , fs4a, fs4b。这都是 8 核心、16GB 内存 裸机服务器,每一个配备有 6 个 300GB 15K RPM SAS 硬盘, 组织为 RAID 10 磁盘队列。任何时间里,每对机器都处于双机热备的主备方式。所有的仓库数据都会定期通过 DRBD 进行主从备份。
每个文件服务器运行着两个 Ernie RPC 服务,它们都处在 HAProxy 之后。每一个 Ernie 拥有 15 个 Ruby workers。这些工作进程接受 RPC 调用并进行 Grit 调用。返回值是通过 Smoke 代理返回到 Rails 应用的,对应的 Grit 桩则返回预期的 Grit 响应。
当 Unicorn 完成了 Rails 的调用后,响应包通过 Nginx 直接传回到客户端(期间不经过负载均衡器)。
最后,你看到了一个相当漂亮的网页。
上面的场景是缓存没有命中时发生的。在多数情况下,Rails 的代码会使用 Evan Weaver 的 Ruby memcached 客户端查询 Memcache 服务器, 每个从 (slave) 文件服务器上都会运行。因为这些机器相当空闲,我们在每台机上放置了 12GB 的 Memcache。暂且称它们为 memcache1, , memcache4.
BERT 和 BERT-RPC
对于我们的数据串行化和 RPC 协议,我们使用 BERT 和 BERT-RPC。你从前从未听说过它们,因为它们是全新的。我对我尝试过的所有可选项都不满意,我也希望实现萦绕在心头的一个想法,所以我创造了它们。在你对 NIH 综合征生厌之前 ( 或帮助你解决这个症状 ),请阅读我与之相关的另一篇文章:[Introducing BERT and BERT-RPC](http://github.com/blog/531-introducing-bert-and-bert-rpc)(对 BERT 和 BERT-RPC 的简介)。文章里会介绍这些技术是怎么来的,以及我希望用它们来解决什么样的问题。如果你只想看看规范说明,请点击 http://bert-rpc.org。
对于代码狂,请 check out 我的 Ruby BERT 串行库 BERT, 我的 Ruby BERT-RPC 客户端 BERTRPC,以及我的 Erlang/Ruby 混合 BERT-RPC 服务器 Ernie。这就是我们 Github 用于储存所有仓库数据的库,经过实战检验 :)
跟踪 SSH 请求
Git 使用 SSH 作为加密通讯协议,用于你和服务器之间的通讯。为了了解我们的架构是如何处理 SSH 连接的,首先需要知道 SSH 是如何运作的。Git 依赖于 SSH 提供的在远端服务器执行命令的功能。例如,执行 ssh tom@frost ls -al 会在 tom 的 home 目录上运行 ls -al ,home 目录所在的机器是 frost 。我可以在我的本地终端上得到结果。SSH 实际上把远程服务器上的 STDIN, STDOUT, 以及 STDERR 挂接到我本地终端上来了。
如果你执行 git clone tom@frost:mojombo/bert, Git 实际执行的会是,SSH 到 frost,以 tom 的身份登录,然后远程执行 git upload-pack mojombo/bert 命令。然后你的客户端就能和远程服务器在 SSH 连接里通讯。很简洁是吧?
当然,允许任意执行指令是很危险的。所以 SSH 有个功能,用于限制能够远程执行的命令。简单来说,可以限制为 git-shell ,一个 Git 附带的小玩意。这些脚本会保证,你执行的是以下 git upload-pack, git receive-pack 或者 git upload-archive 这三者中的一个。如果真的是其中之一,则会调用 exec 用新进程替换当前进程。然后,就能够得到相应结果,就像你直接执行那个命令一样。
现在你知道了 Git 的 SSH 的基本原理了,接下来我会向你介绍这一切是怎么在 Github 架构里完成的。
首先,你的 Git 客户端会初始化一个 SSH 会话这个连接首先到达我们的负载均衡器。
然后,这个连接会到达其中一个前端,由 SSHD 接受。 我们对 SSH 守护精灵做了 patch(补丁),使其可以在 MySQL 数据库里进行公钥查找。你的公钥标示了你的用户身份,这个信息会和原始命令参数一起送达到我们的专有脚本 Gerve (Git sERVE)。请将 Gerve 理解为 git-shell 的超级智能版。
Gerve 可以检测你是否对仓库有相应的执行权限。如果你是仓库属主,则拥有所有权限。否则, 会发起多个 SQL 查询去定位你的权限。
当访问被允许后, Gerve 使用 Chimney 来查找仓库的路由。现在的目标,已经变成在合适的文件服务器上执行你的原始命令,并且将你的本地机器挂接到那上面来。免去了另一次 SSH 的启动,牛吧?
或许这听起来有些疯狂,但是这方案工作的很好!Gerve 只是使用 exec(3) 来将自己的进程替换为 ssh git@<路由> <命令> <参数>. 这次调用之后,你的客户端就挂接在一个前端机器的进程上,而前端机器的进程则挂接在一个文件服务器的进程上。
想想这种解决方案有多么美妙:在确认了权限和仓库的位置之后,前端机器在会话的剩余时间里,只充当一个透明代理。这个方案唯一的缺陷,就是内部的 SSH 需要进行无谓的加解密操作(内网安全,无必要加解密)。我们可以将内部的 SSH 替换为某种更为简单高效的连接,但是原方案实在是太简单直接(而且还非常快!),所以目前我们还没有太大的动力去做这个优化。
跟踪一个 git 请求
执行公共仓库的 clone 和 pull 操作就跟 SSH 的一样。 不需要 SSH 进行鉴权和加密,只需一个服务器端的 [Git Daemon](http://www.au.kernel.org/software/scm/git/docs/git-daemon.html)。这个 daemon 负责接受连接,检验所需运行的命令, 然后使用 `fork(2)` 和 `exec(3)` 来产生子命令进程。 记住这个概念,下文我将为你展示一个公开的 clone 操作是怎么进行的。 首先,你的 Git 客户端发起了一个 [ 请求 ](http://github.com/mojombo/egitd/blob/master/docs/protocol.txt) ,这个请求包含了你需要执行的命令和对应的仓库名。请求首先进入我们的负载均衡系统。从那里开始,请求将发往其中一个前端。每个前端跑 4 个 ProxyMachine 实例,前面则有 HAProxy 挡着作为 Git 协议的路由代理。代理会从请求中抽取出仓库名(或者 gist 的名字)。然后使用 Chimney 查询路由表。如果没有发生其他的错误,代理就会通过 Git 协议向 Git 客户端发回合适的信息。当路由查询完毕,仓库名(例如 mojombo/bert)就会转换为磁盘路径名 ( 例如 a/a8/e2/95/mojombo/bert.git). 以前的配置里,我们没有使用代理,所以我们需要一个修改过的 daemon,使其能够将对应的用户 / 仓库转换为合适的文件路径。通过代理完成这一步骤,我们就能使用一个未经修改的 daemon,使得升级路径变得更简单。
然后,Git 代理建立了一个到文件服务器的透明代理,转发(经过修改仓库路径)的请求。每个文件服务器运行着两个 Git Daemon 进程,均处于 HAProxy 后面。Daemon 会使用文件打包协议,将数据流打回到 Git 代理,直接和你的 Git 客户端通信。
当你的代理得到了所有数据,你就已经克隆了仓库,而且可以开始工作了!
子系统和网站系统
除了主要的 web 应用程序和 Git 系统外,我们还运行着多种子系统和网站系统。子系统包括工作队列,打包下载,账单管理,镜像系统,svn 导入等。网站系统包括 GitHub 网页,Gist,gem 服务器,还有一打的内部工具。这些子系统的一部分是如何在新架构下运行的,我们创造了哪些新技术,去让应用跑得更为平稳,将会在未来的一系列文章中讲解,敬请期待总结
这里描述的架构很好的适应了我们对网站架构的扩展,而且还让整个站点的性能得到了质的提升。以前,我们的 Rails 应用平均响应时间是 500ms 到数秒,取决于系统的负载。转移到裸机和 Rackspace 的联合储存 (federated storage) 以后,我们的 Rails 应用响应时间降到了 100ms 以下。而且,工作队列可以轻松应付每天 28000 个背景作业而游刃有余了。当前的硬件集威力还没有完全发挥,我们有更大的成长空间,而且当需要扩展时,我们能够轻易加入更多的服务器。我对这一切感到惬意,如果你像我一样,你一定在每天享受崭新的 GitHub 了!理解所用协议
BERT 和 BERT-RPC
跟踪一个 git 请求
总结
155 - tricks: 如何把 sqlalchemy 的数据转化为 json 格式
sqlalchemy 最恶心的对象,就是通过 execute 得到的结果,那是 rowproxy 列表。为了优化,rowproxy 使用了 slot,使其失去了动态性,而又经常要转换成 json 格式,于是可以这样:
156 - 项目总结
入职一年有余了。
收获
第一次参加实战项目,也是第一次参加多人协作的项目,感觉很新鲜。回头看,学校应该多开展这样的训练。多人协作跟个人开发最大的不同,是需要大量阅读他人的项目代码,在实现功能的时候,也需要不断的进行妥协。要阅读一个新项目的代码,从最初的版本 checkout 进行阅读往往是比较好的选择,可以比较清晰的看到项目的架构思想,把握模块开发的惯用法。另外,首先阅读核心工具库帮助很大,一是能够很清晰看到老大的功力(笑),二是对于阅读他人的新模块,尽快投入开发,能够有较大帮助。
在学校学习 python,我只是掌握了基本语法和少数几个库。来到公司后,基本把 python 自带的库都用过一次了。第一次理解了什么叫做 Battery-Included,python 果然强大。除了官方库外,项目里还用到一些优秀的第三方开源库,例如 Google 的 protobuf,还有 gevent 协程库,项目的前任老大也向开源社区贡献了两个包,little and shiny,很不错。我发现我真的很享受开源社区的开发工作。
参加实战项目后,第一次发现,操作系统和计算机网络里的内容,很多都涉及到了,恰好当年对这两门课最感兴趣,因此开发还算顺利。回想起来,这一年里干的龌龊事还是不少的 XD,比如说将数据库当消息总线,满足多进程通讯的需要;又比如利用内建的 rpc 机制做了个 bug 重重的两层包转发;再比如那个利用 Mysql 的 InnoDB 行锁实现的多进程锁。当年操作系统课上,对于纤程只是一带而过,而 Gevent 的协程机制就很有点纤程的意味。Gevent 就是一个异步 IO 事件响应的框架 + 高性能定时器阵列,并发性能相当惊人,当然也有部分缺陷,容后再述。
发现的问题
当然,在项目中也受过不少苦头,例如策划拍脑袋改需求的事,还有各种上线前爆发的疑难 bug 侦错,真个是步步惊心。于是私下总结了一些经验教训,希望将来的自己能记住。
架构上
从初期版本上看来,设计的时候还是比较注意单一职责原则的。IO 层,业务逻辑层分野明显,业务逻辑开发也颇有点插件式增量开发的味道。可惜后来自乱阵脚,不知道是策划、老板催的太紧,还是人本身的惰性使然,后来的功能开发,都是东插一块,西垒一堆,每次提交都差不多十个文件,code review 的时候很难发现重点。
如果能够重来,我会把消息队列作为业务逻辑开发的基础。在游戏操作的关键点前后都 pub 出消息,以后的插件只要监听消息就能够进行了,不需要再到处插代码。资源的申请与释放应该有一个统一的地方完成,内存泄露也容易查,功能代码上也不需要做很多冗余的错误处理。开发新功能时,尽量以插件的方式提供,资源则由框架提供。
当然,这一切都取决于项目的概念完整性。整个项目的架构设计 ,应该由一到两个人完成,其他人的好建议可以吸收,但总的概念和走向应该由这一到两个架构师把握,从全局上统筹开发风格,避免项目变成大杂烩。
gevent
gevent 的并发性能相当优异,而且结构简洁,对我等开发者而言实属福音。但是,游戏里遇到一种情况,例如打击计算、ai 逻辑等部分,希望越快执行越好,而数据查询类的操作,例如排行榜,则可以接受较大的延迟。Gevent 的调度器没有优先级的概念,这里可能需要自己 hack 一下,或者更进一步的分离开数据查询操作,以此提高打击判定的速度。
版本控制
在项目的开发过程中,越来越感到版本控制的重要性。新功能提交和 bug 的提交不要混淆,尽量做到每次只提交一个功能点,普及 code review,bug tracker 和 code commit 可以考虑联动。如果用上 git 或者 hg 做开发支持,每个新功能作为一个分支,若发现影响很大的 bug,就可以整个分支抽离,将对其他功能的影响降低,也提高了版本发布时的代码稳定性。
157 - 智能去除选定区域
这篇文章缘起于这篇博客:http://xiaoxia.org/2011/12/03/shocked-by-gimp-filter-smart-remove-selection/
看完以后着实震惊了,这下要去掉照片里的东西实在太简单了。在群里吼了一声以后,美术表示 Photoshop CS5 很淡定。于是我找来了 Photoshop CS5 (PS CS5) 教程 看看,大约 9 分钟的时候,CS5 潇洒地 P 掉了背景中的一个人,神奇了!
这项工作原来是要靠人手完成的,自己选取一块相近的纹理,通过 PS 的图章工具补上去,但是人手补上的话会有个问题,一个是纹理不对,一个是光线不对,反映在图上就是修补的区域没有过渡,变成很生硬的一块。
而通过软件完成这项工作,不仅大大节省了时间,而且效果与人手修补毫不逊色,比我本人 ps 更是好的多了 XD
于是找来了 resynthesizer 源码分析,似乎最关键的就是以下这段代码:
这段代码是 GIMP 的 resynthesizer 插件进行取样的过程,取样最特别的地方,在于对自身进行复制,形成一段纹理。具体的工作原理,可以参考作者的论文:《A NON-HIERARCHICAL PROCEDURE FOR RE-SYNTHESIS OF COMPLEX TEXTURES》
我简略地翻译一下概要:
再看 photoshop CS5,里面有个关键词,content aware, 这个概念可以参考这篇文章:http://dl.acm.org/citation.cfm?id=1276390 不过毕业以后就看不到 ACM 的全文了。。。content aware 的神奇之处,在于不仅根据几何形状,还根据图像中的能量进行识别。至于能量函数,abstract 里说的很抽象,印象中是利用图像中的熵这类东西解决的。所以,PS CS5 的智能去除,应该是通过 content aware 的 SEAM 将目标物盖住吧,可惜 ps 没有开源,没办法得到确切答案了。
158 - 分享三个好用的装饰器
这个用于缓存计算量比较大或者需要 IO 的情况,用的时候只要 @Memorized(10) 这样就行了,不用更改原代码的逻辑,看起来比较干净清晰
用于记录谁修改了指定值
159 - 根据 pythonprotobuf 自动生成 protobuf 包收发接口
利用 protobuf 进行串行化和反串行化处理,封装出来的 rpc 服务很好用。但是有个缺点,就是测试时,一些很简单的接口都要重新实现一次,程序体内就一些简单的赋值语句。写了个代码生成器,用来生成 protobuf 对应的请求函数和回应函数,请求函数根据 req 的内容,生成赋值函数体;回应函数只是负责把服务器返回的包进行打印。
先用 .proto 文件生成 protobuf 的 xxx_pb2.py 文件,将其放入 protobuf 目录
160 - 台电 k6 你立功了
等了一年,还是停留在 v2.11 的固件上,英文就一渣排版。只能自己动手了
写了个英文排版的,两种排版方式,一是按 最小破损度 进行排版,最小破损度追求的是文章排版的整齐性,也就是行尾空格数目尽可能相等。这样外观上就会比较平整,当然,行尾的空格可以移到行内,使得每行刚好满足给定宽度。另一种是按 最小行数 进行排版。这种排版相当直观,就是把原文一个词一个词地放入一行中,当不能再放入时,就进行换行。
源码:
上述代码按动态规划做应该能够进一步提升效率,现在只是用了记忆化搜索,仔细想来调用函数的次数还是会比动态规划要多得多,而且函数调用的代价还是比较高的。另外一个问题,是无法直接对全文进行排版,估计是效率太低,一直没有输出,我是分段切开再行排版的,有可能出现上下两段间宽度不一致的情况。
161 - python 实现的简单的 epub2txt
等了 1 年,还是没等到台电 k6 的固件更新,好失望。
由于 k6 不支持 epub 的目录跳转、内嵌字体,且每次阅读均需要重新解压 epub,既浪费电又浪费时间,因此干脆转成 txt 算了。
先用 zipfile 进行解压
然后用 HTMLParser 进行正文提取
最后输出同名 txt
代码在 http://code.google.com/p/yaepub2txt 上托管,google code 上的另外一个 epub2txt 似乎也是国内的兄弟写的,是基于 html2txt 的库和 xml 解析做的,我懒,直接解压,读 html 文件了事了 B-)
162 - vim 定制配色方案
个人一直比较喜欢内置的 desert 配色,无奈安装了 pyflakes 之后语法错误的地方老是看不清楚,纠结了很久。在 muzuiget 的指点下,有所进展。可以参考他写的 《Vim 终端配色转换工具》。但是转换色彩之后,还是无法转到自定义的颜色方案。
我使用的终端是 ubuntu 自带的 gnome-terminal, 既然不是古董级产品,不应该有色彩支援上的问题。为了验证这一点,我参考了 arch 维基的 这一篇 ,还有 这一篇 。一语惊醒梦中人,原来 vim 需要开启 256 色方案才可以。输入 set t_Co=256 开启 256 色支援。
要设置为默认方案,需要在 ~/.vimrc 中添加一行
colorscheme your_color_scheme_name
附上我的方案:
163 - ubuntu 下访问 E72
由于家里的电脑没有蓝牙,每次传送文件都十分麻烦,像我这种懒人又不甘心去找数据线,只能够在 wifi 上打主意了。
E72 采用的是 s60v3 版 FP2 的系统,虽然是 sb 系统,不过比较实用。要完成这次跨系统文件传输的任务,还需要一个
好工具:SymSMB 4.0。 它可以模拟 win 的共享模式,方便其他系统进行访问。我使用的是 dospy 论坛汉化的版本,
参考过 这篇教程 。大致的流程是:在 SymSMB 的控制面板里,找到帐号,新建一个用户,建议设置密码(免得酿成
一个男人不会修电脑,后来大家都知道了的悲剧)。然后在 SymSMB 根目录的我的移动电话里新建共享,用户设
置为刚新建的用户,读写权限请按需设置。最后在连接里找到刚刚新建的用户,点击启动,选择连接到你的无线路
由器上。手机端就此设置完毕。
ubuntu 自带有 SMB client, 我使用的是 ubuntu 11.04,使用 nautilus 随便打开一个文件夹,点击菜单栏的文件,点
击连接到服务器,选择 windows 共享,输入在手机上看到的 ip 地址(若看不到可以通过路由器的客户端列表找),然
后会提示输入用户名密码。输入成功后,即可看到手机的文件夹。大功告成!
164 - python 实现的最近最少使用算法
LFU(Least Frequently Used,最少使用 ) 是一种缓存管理算法,其过期策略为替换出缓存中最少使用项。若各项使用次数相等,则参考 LRU(Least Recently Used,最近最少使用 ) 进行替换。
实现过程中,一直希望绕开链表去实现。尝试过用优先队列,但是优先队列对于优先级的调整处理很复杂,而当替换某些缓存项时,优先队列里保存的索引值又会过期,暂时未想到解决方法。一个比较拙劣的实现是使用 sort() 对使用次数进行排序,Python 内置的 sort 相当独特,是一种运用了 merge sort( 合并排序 ) 和 insertion sort( 插入排序 ) 的混合排序,因其作者 Tim Peter 而命名。据说实际运行效果中,因为利用了子表的有序性,实际比较次数往往远小于 O(nlogn)。
目前的实现,采用了双向链表进行管理。链表中的位置表明了该项的使用次数在全体成员中的序号。通过一个 dict 直接找到链表中的项,然后通过比较相邻项的访问次数决定是否调整位置。
代码见:
165 - GreaseMonkey 渐进
此段代码是从 document 中取出所有标签为 div 的节点,放入 zPara 数组中,然后通过 for 循环统一改变其背景色和前景色。
166 - 新浪微博显示原创图片
鉴于我跟室友都比较渴求这个功能,尤其是观察美女时用,特别写了这个 userscript:
167 - 如何组织文件
最近想入手个 1T 的移动硬盘,但是想到如何组织文件,就觉得十分头痛。
自我总结下文件组织的经历:
Windows
windows 天然的不稳定性,每每让我胆战心惊,很可能忽然在周末跪低,然后父亲大人就把 C 盘格式化了。因此,历史经验表明,C 盘是不能放资料的。惯常的组织方法是:
C 盘 只安装系统
D 盘 安装软件,放我的文档和收藏夹
E 盘 安装游戏或作为备份盘
F 盘 BT 下载
如此组织,一是方便系统重装的时候,常用软件和日常数据能够得到妥善保存;二是避免 BT 下载之类带来频繁磁盘整理的压力。
随着使用时间的增加,各盘的剩余空间迅速减少,但是剩余空间之和却是相当大的,这就造成了一种变相的浪费。另外,XP SP2 开始稳定性有了较大的进展,终于不用再频繁重做系统了。因此,后来就直接变成
C 盘 系统和各种软件
D 盘 私人数据和下载的数据
软件方面,可以利用云端软件平台进行管理,既能够享受绿色安装的快感,又不需要费神找下载文件,担心病毒问题。收藏夹方面,主流的浏览器都带有收藏夹备份功能,因此可直接放在 C 盘。(另外,chrome 取消了书签管理器的快捷键,似乎希望淡化书签这个概念,代之以历史记录。细想,其实翻收藏夹的机会真的极少极少)增加下载的缓存大小,允许创建临时文件,足可以避免 BT 下载对硬盘造成的损害。
至于具体的文件夹组织,依个人习惯而不同。按项目分类,再在项目里按时间分子目录,似乎是一个不错的选择。分层则不宜过多,我觉得,超过 3 层的目录就会变得很冗余,也许你只是想把某些文件藏起来而已。同一目录下,子目录及子文件过多,也十分不雅。后来,厌烦了分类的我直接用 Everything 来进行搜索,文件直接放在同一个目录下,基本上用 Everything 的搜索视图来代替原始的 Explorer 界面。 若你有组织多层目录的习惯,Total Commander 会是一个不错的选择。
关于文件命名的问题,可以参考善用佳软的《三段式命名》,我反对那种文件名前还要加序号的方法,但是审慎命名文件,始终如一坚持一套有效的命名规则,的确能够带来极大的效率提高。于我个人而言,采取 tag cloud 的方式管理文件才是最天然合理的,一个文件可能有多重身份,或许是某个团队项目的一部分,或许属于下载来的文件,或许存在于某年的备份中。要体现文件的这种复杂身份,基于目录的管理方式太落后,tag cloud 才是最佳选择。只是基于 tag cloud 进行搜索定位文件的软件迟迟未出现,也许需要在文件系统上提供更多属性的支持?
Linux:
linux 的目录树管理方式十分灵活,而且有利于进行优化。有时候不禁 YY 下,代码文件都在 /src 目录下,编译出来的文件放在 /bin,然后 /bin 目录使用更大的文件簇,/src 目录则使用 reiserFS 和更小的文件簇,减小空间的浪费。更进一步,可以把 /boot 目录及 /bin 挂在 SSD 上,提高系统的响应速度,同时这两个目录较小的写入次数应该能够延长 SSD 的使用寿命。
对于各个系统而言,良好的命名是一个通用的习惯。毕竟,真正负责思考的是计算机前的你,而不是冷冰冰的电子回路。

168 - 在 cygwin 上安装 gevent
由于公司点餐要用 QQ,只能寄身于 WinXP 下做开发。但是 win 下各种不能折腾很不爽,幸而有 Cygwin
然而,使用 easy_install 居然安装不了 Cygwin,弹出一大堆 core.c 的错误,一直没搞懂。只好与 win 的丑陋的命令行相伴,还设置了 PATH 指向 cygwin 的 bin,为的就是能顺利 ls。
遍寻不获后,今天看到这篇日志 http://d.hatena.ne.jp/ymotongpoo/20110108/1294494273,终于醒悟过来了。。。我没有装 libevent,cygwin 的源里也没有这个东东。
剩下的就简单了,./cofigure、 make、 make install 安装 libevent,使用
169 - 使用 python 对 txt 格式的小说进行处理
vim 的确是神器,可惜 sed 与 vim 不完全通用。这篇文章受《
用 vim 对 txt 格式的小说重新排版》的启发,在此致谢!经常下载 txt 的电子书,格式却不合心意,只好自己再处理。首要的就是处理段内换行。
原来的打算是定制一个 vim 模式,到时候处理小说时进入该模式,再使用各种快捷键。以此避免 txt 快捷键对日常编程的干扰。后来发现,vim 不像 emacs,可以定制自己的模式。(可能可以定制专用的 vimrc 解决,未经尝试)
于是转向脚本寻求解决办法。sed 与 awk 是此中翘楚,首先试试。可惜早些日子学的 sed 已经忘的差不多了,找不到比较简洁清晰的解决办法。sed 与 grep 类似,先读入一行,删除 \n,进行各种处理,最后写入文件,再添上 \n。 N 可以读入下一行到当前模式匹配空间再行处理。但是我需要对整个文件进行匹配,暂时未找到解决办法。
只好再次转投 python。Python 有自己的 re 模块,应该没问题。re.sub 可以进行替换。费了些时间的,是对中文的匹配。在 vim 中,可以用 [^\x00-\xff] 匹配双字节字符,然而 python 中却行不通。经过一番 google,发现可以用 [\x80-\xff] 匹配汉字(perl 同此,似乎两者对中文的正则支持还是有待改进)。
至此,问题初步解决:
#!/usr/bin/env python
#encoding=utf-8
import re
from sys import argv


if __name__ == '__main__':
	if len(argv) != 2:
		print 'usage: filename'
	else:
		fh = open(argv[1], 'r')
		content = fh.read()
		out = re.sub('\n([\x80-\xff])', r'\1', content)
		print out
规范行首:
#!/usr/bin/env python
#encoding=utf-8
import re
from sys import argv


if __name__ == '__main__':
	if len(argv) != 2:
		print 'usage: filename'
	else:
		fh = open(argv[1], 'r')
		content = fh.read()
		out = re.sub(' +([\x80-\xff])', r'     \1', content)
		print out
当然,下载来的文档通常是 GB2312,需要自己转换为 utf8 再行处理,可以参考我的 《python 中文编码笔记》
在 win 下,有个优秀的文本处理工具可以利用,叫 cnbook。在百度的 fmddlmyy 贴吧可以下载到最新版本。
170 - RLE 游程长度编码
昨天看心情好,就花了两个小时写了个 RLE 的 demo,可是 p7zip 帮我删了。。。晚上再写,用 gcc rle.c -o rle.c 脑抽啊我
今天不死心,再写了一个!【RLE 压缩 】
RLE 是基于这样一种思路:如果整个文件由 A 构成,那么我们只需要用 A 次数去表示该文件就可以了。 为了表示序列开始,需要一个标识符,我选择了 0xff。这样,每个序列就表示为 0xff 字符 次数。 当单个字符出现次数少于 3 的时候,压缩就得不偿失,因此对小于 3 个字符的不处理而直接输出。
详见维基百科:http://zh.wikipedia.org/zh/%E6%B8%B8%E7%A8%8B%E7%BC%96%E7%A0%81
171 - SICP 与函数式编程
马马虎虎地看完了第四章跟第五章,终于可以为 SICP 这本书画上一个句号。
似乎 GCD 跟 fibonacci 这两个程序在每门语言里都会被实现一遍。这应该是涉及到递归的定义吧,对于函数式编程来说,递归是深刻而基础的,循环可以没有,递归不可或缺。特别是 fibonacci 的双递归,一方面考验了编程使用者的技巧,另一方面考验了这门编程语言的实现。(参见 维基百科 )
其中印象比较深刻的,是将函数作为参数和返回值。而且在 scheme 的语法中,显得非常自然。C 中也有函数指针,相对地就显得复杂。
另外,就是引入表作为一种通用的数据界面进行处理了。得益于后台运行的 GC,使用表的时候不用担心自动增长的问题,可以专注于工作本身。而且,对于表的操作也只有两个原语:CAR 与 CDR。 通过这两个原语的结合,再配合前述的递归,scheme 就能发挥出它的强大威力,令人叹为观止。
数据抽象一节,很容易联想起 C 的结构体一节与 C++ 的对象,利用带标志数据,在表上实现了多样的抽象对象。后面接的就是模块化,作者煞费苦心搞出了 set!来配合讲解与 C++ 相若的对象概念,以及用计算机中的对象模拟现实世界运行的 OO 思想。那个数字电路的模拟器写得很棒,特别是约束传播,很有感觉。
数据抽象里最有力的一节,是引入流和时间解耦。流的实现居然只是简单的在 cdr 上加了一个简单的壳,用一个许诺代替了具体数据。通过引入流,作者轻松地将循环等等抛弃掉,连带的还有局部变量。对象的状态看作是一组跟时间相关的值的流,漂亮地解决了并发冲突后(实际上,时间与通信似乎有着天然的联系,参见相对论中关于火车、隧道与闪电的例子),状态就跟时间本身解耦了! 状态跟时间解耦,意味着并发性不再受到限制,这就是函数式编程天生支持高并发的原因吧。
流的另一大惊喜,是对(发生器 - 过滤器 - 累加器)这一编程模型的优化。通过流,这三者的配合可以交替执行,因此节省了中间结果所占据的巨大空间和时间。我很好奇 Linux 下的管道是否也用上了类似的优化。(流的自身迭代也很美,特别是欧拉加速器!)
第 4 和第 5 章没看懂,暂不发表意见了。以后有时间就看看 the little schemer XD
172 - 视频数据编解码技术
我真的很难专心持续做一件事情呢,最近因为课程需要写了篇文章应付,博诸君一笑
** 视频编码与文件格式的常见误区 **
常见的视频编码
MPEG2
MPEG-2 是 MPEG 工作组于 1994 年发布的视频和音频压缩国际标准。MPEG-2 通常用来为广播信号提供视频和音频编码,包括卫星电视、有线电视等。MPEG-2 经过少量修改后,也成为 DVD 产品的核心技术。MPEG-2 的系统描述部分(第 1 部分)定义了传输流,它用来一套在非可靠介质上传输数字视频信号和音频信号的机制,主要用在广播电视领域。MPEG-2 的第二部分即视频部分和 MPEG-1 类似,但是它提供对隔行扫描视频显示模式的支持(隔行扫描广泛应用在广播电视领域)。MPEG-2 视频并没有对低位速率(小于 1Mbps)进行优化,在 3Mbit/s 及以上位速率情况下,MPEG-2 明显优于 MPEG-1。MPEG-2 向后兼容,也即是说,所有符合标准的 MPEG-2 解码器也能够正常播放 MPEG-1 视频流。MPEG-2 技术也应用在了 HDTV 传输系统中。MPEG-2 的第三部分定义了音频压缩标准。该部分改进了 MPEG-1 的音频压缩,支持两通道以上的音频。MPEG-2 音频压缩部分也保持了向后兼容的特点。MPEG-2 的第七部分定义了不能向后兼容的音频压缩。该部分提供了更强的音频功能。通常我们所说的 MPEG-2AAC 指的就是这一部分。
MPEG4
MPEG-4 是一套用于音频、视频信息的压缩编码标准,由国际标准化组织(ISO)和国际电工委员会(IEC)下属的动态图像专家组(Moving Picture Experts Group,即 MPEG)制定,第一版在 1998 年 10 月通过,第二版在 1999 年 12 月通过。MPEG-4 格式的主要用途在于网上流、光盘、语音传送(视频电话),以及电视广播。MPEG-4 包含了 MPEG-1 及 MPEG-2 的绝大部份功能及其他格式的长处,并加入及扩充对虚拟现实模型语言(VRML , Virtual Reality Modeling Language)的支持,面向对象的合成文件(包括音效,视频及 VRML 对象),以及数字版权管理(DRM)及其他交互功能。MPEG-4 大部份功能都留待开发者决定采用是否。这意味着整个格式的功能不一定被某个程序所完全函括。因此,这个格式有所谓 profiles 及层次(levels),定义了 MPEG-4 用于某些特定应用的某些功能的集合。
H.264
H.264,或称 MPEG-4 第十部分,是由 ITU-T 视频编码专家组(VCEG)和 ISO/IEC 动态图像专家组(MPEG)联合组成的联合视频组(JVT,Joint Video Team)提出的高度压缩数字视频编解码器标准。
MPEG7
MPEG-7 标准被称为多媒体内容描述接口,为各类多媒体信息提供一种标准化的描述,这种描述将与内容本身有关,允许快速和有效的查询用户感兴趣的资料。它将扩展现有内容识别专用解决方案的有限的能力,特别是它还包括了更多的数据类型。换而言之,MPEG-7 规定一个用于描述各种不同类型多媒体信息的描述符的标准集合。该标准于 1998 年 10 月提出。
** 视频解码的常见过程 **
视频解码的 4 个过程,通常包括获取文件、分离音视频流、解码、输出。
获取文件
视频流的来源可以是文件,也可以是 UDP 等数据流,主要是将视频流放入内存缓冲区中。
分离音视频流
正如前述,视频文件只是一个容器。视频数据与音频数据按照一定的标准组合在一起。为了下一步的解码,首先要把视频和音频分离开。
解码工作
分离开的音频和视频,由各自的 codec 负责进行解码,得到原始数据流。
输出
将得到的原始数据流在窗口里进行渲染,使之变成可以看到的图像。
** 视频编码的核心过程 **
下面以现时的 MPEG1 编码为例,试讲述视频编码的核心过程。通过摄影机、摄像头等得到的图像,首先会进行模数转换,变成数字码流。但是,在时间尺度上和空间范围上,均有大量的冗余信息,得到的比特流会占用大量的空间,不利于储存和播放。因此,就需要对原始视频流进行编码压缩。常见的方法是,对原始视频流进行色彩空间转换。由于人眼对于亮度的敏感大大优于对色度的敏感,转化为 YCbCr 色彩空间能够缩小体积而视频质量仍保持在较高质素(同时,这也去除了色彩方面的冗余)。接着进行 DCT 离散余弦变换,由于离散视频变换具有很强的能量集中特性,大多数自然信号(包括声音和图像)都会集中在离散余弦变换后的低频部分。(这意味着系数矩阵的大多数元素均为 0)通过量化,就可以进行熵编码。上一步得到的数据往往具有较高的冗余量,对其进行熵编码(如常见的霍夫曼编码)就会有较好的压缩效果。
对于视频来说,往往会进行运动补偿,使用已经编码的帧对当前帧进行预测。最简单的运动编码可以是将当前帧减去参考帧,对剩余部分(只剩下较少能量的残差)进行较低码流的编码。比较常用的是分块运动补偿,通过对宏块的平移预测当前帧。其中,涉及到探测并计算最优平移向量。当然,还有通过向前向后预测来优化的(向前向后是指同时使用前后两个参考帧进行预测)。
参见:
维基百科
173 - C 程序设计语言答案 chapter3
第三章答案 主要围绕 itoa 做文章,加深对整数类型的理解和字符串数组的操作。
第三章貌似是一个转折点,前面的练习更加像一些玩具,后面的会更有挑战性。
175 - C 程序设计语言答案 chapter1
最近面试屡屡受挫,搞得颇为狼狈。断断续续地看完了 K&R 的 C Bible,刚把第一章的习题完成了。不得不说,这本薄薄的小书习题很有质量。对于指针的运用很有启发,给了我很多的灵感。看完很想说:原来 C 语言还可以这样用!
习题都是自己做的,若有错漏,还请不吝赐教。
176 - ubuntu 下 svn 上传到 googlecode
在 Google code 上也混迹了一段时间,提交 patch 和 issue 都试过了,可惜一直没找到哥们给个 commitor 当当。今天特地去挖了个坑,试试 owner 的滋味。
- 在 source 下的 checkout 里,可以很清晰地看到需要填写的命令。可是 ubuntu 的 svn 有点诡异,以 ownership checkout 一个 project,居然也不需要输入密码,搞了我很长时间。
- 更纠结的还在后头,svn add 添加完文件,svn commit 进行提交,发现首先要输入的是一个 Gnome keyring(null) 的密码,我输了很多遍 google code 的密码和邮箱密码,都不对,原来那是本机用户的密码。
- 接下来 google code 的服务器就会问你要帐号,若是 gmail 账户的话直接输入用户名即可,不用添加 @gmail。
- 接下来输入的是 google code 的密码。可以在 http://code.google.com/hosting/settings 里找到,这个密码十分复杂的说,在命令行下输入相当有难度。
177 - 操作系统逻辑地址与物理地址的转换
逻辑地址 / 页面大小 = 页号 逻辑地址 mod 页面大小 = 页内偏移 通过页号查找页表得到对应的物理区块 物理地址 = 物理区块 x 页大小 + 页内偏移
页号也可以通过位映射的方法实现,例如页表只有 4 项,则只需逻辑地址的前两位就可以确定页号。
参考:
178 - 入手台电 K6
最近入手了电纸书,折腾了好久,感觉有点浪费时间阿,这时间和钱拿去买书读书该多好
期间遇到一个问题,6 寸屏幕的电纸书看 pdf 相当痛苦,幸好新固件有 pdf 重排。但换行依然不知所谓不明就里不能人道于是需要自己处理下,网上流行一个 wps 处理法 ,大意就是将 txt 文本粘贴进 wps 的 6 寸模板里,然后另存为 pdf。这样可以设置自己喜爱的字体,的确是不错的选择。此外还有通过虚拟打印机打印成 pdf 的。
txt 源不是那么容易找的,万一找回来的已经是 pdf,怎么办呢?可以通过 pdfcrop 进行切边,这款软件在 ubuntu 下是一个 perl 脚本,原理大概是直接提取文本外的那个盒子,再以之为页面大小,这样白边自然而然就没有了。但速度非常慢,转换后体积扩大 10 倍,不够实用。还有一个 pdfnup,是 pdfjam 的一个工具,可以将两页 pdf 做成 1 页,拿去打印就方便了。也附带有切白边的功能,原理却不一样。它是新建一个 latex 文件,将原文 pdf 像图片一样嵌入其中,然后进行缩放处理。通常都能减少体积,而且速度也快,但切多少就要靠自己手动控制了。另外切完白边后放进机器中似乎不能重排了,这点待验证。
不由得又想起 TAOUP 里面提到的,纯文本最好。当然,这里不包括为了营造格式随便断行的 txt。如果 pdf 有相应的 ps 或者 tex 文件,要变 6 寸 pdf 还不简单?相信改个模板就行了,像 pdf 带盒子是最难处理的,将 html 直接 dump 成 txt 似乎也带有换行,比较麻烦。总的来说,数据是文本流这种模式最好,图片之类的应该是处于漂浮状态的,由排版方决定图片的位置,这也是 html 的思想。
关于机器,台电 K6 似乎是市场上最便宜的 6 寸 E-ink 机器了。然而,似乎易万卷的 S600 更好一些。上市日期差了 3 个月,硬件方面却有较大区别。k6 用的是 arm7 的,瑞芯微的解决方案,而 S600 用的是 arm9,而且用的是 linux 系统。买之前没考察清楚阿,嵌入式设备上的固件也很重要,需要列入考虑方案。虽然 K6 也支持 16 灰阶,但仅仅是硬件上,要等到相应固件不知何年何月,另外还有 pdf 切白边的功能,不知道台电还打不打算继续做出来。易万卷的 Linux 系统起码让人看到了那么一丝可以 hack 的机会啊
总结:6 寸电纸书看文学类的书最好,epub 格式不错,本身基于 xml 结构,排版方面没有什么问题。要看扫描版 pdf,还是等 10 寸吧,10 寸携带不方便,如果那种可以卷曲的电子纸可以普及,那么阅读扫描版电子书的时代就真正来临了。
179 - archlinux 安装 quick-init 导致根目录可读的修复
不得不说,Arch Linux 真的非常快!搭积木式的构建方式可以给我一种掌控感。后来听说 quick-init 可以 4 秒启动,禁不住去试试,结果。。。失败了,只好卸载之,结果根文件系统变成只读,无法上网。。。
经过一轮 google,锁定在 /etc/inittab 和 /etc/rc.conf 文件上,首先把这两个文件恢复原样。/etc 中可以看到 inittab.pacsave 或 inittab.original 的备份文件,恢复即可。
若重启依然无法解决,通常是因为把 initscripts 这个包也卸载了。如果 pacman 无法上网,则需要 minimalCD 帮忙,按照新手安装指南配置好网络,然后将 /etc/resolv.conf 复制到硬盘相应目录上,再利用硬盘的 pacman 更新解决。
现在大约 20s 就可以看到 Google 首页了,很期待新一代 chrome OS 的成绩!话说基于 suse 构建的 chrome OS 真的很慢
180 - virtualbox 安装 gentoo
一直想尝试一下 fvwm,又不想搞坏现在的 ubuntu,顺便就搞个 gentoo 玩玩。
基本的安装顺序照官方的 guidebook 就可以了,但配置内核的时候要注意如下选项:
按以上配置的时候就可以得到 virtualbox-friendly 的 kernel 了
配置完成后继续按照官方指南做就可以了。
有两个地方花了我很多时间,一个是文件系统,一个是网卡驱动,照以上配置应该可以顺利完成。网络方面,我采用 NAT 共享,所以在 minimal CD 的时候就要顺道把 dhcpcd 装上,免得启动以后上不了网 emerge。
mirrorselect 貌似不起作用,检查配置的时候记得顺手加上,我用的是 163 的源,速度蛮快的。
我的最终目标是安装 X,所以还要麻烦一点。基本的 virtualbox Guest addition 要装上,然后是
xfree86-input-virtualbox
xfree86-video-virtualbox
最后配置 /etc/X11/xorg.conf
官方指南里说 xorg-x11 和 xorg-server 是等效的,只是 xorg-x11 带了很多字体,推荐用 xorg-server。
没想到 x-term、xclock、tvm 等等都要自己手动装
参考:
[http://www.cnblogs.com/likun/archive/2009/10/15/1584208.html](http://www.cnblogs.com/likun/archive/2009/10/15/1584208.html) [http://www.ha97.com/2333.html](http://www.ha97.com/2333.html) [http://en.gentoo-wiki.com/wiki/Virtualbox_Guest](http://en.gentoo-wiki.com/wiki/Virtualbox_Guest) [http://forums.virtualbox.org/viewtopic.php?t=15679#](http://forums.virtualbox.org/viewtopic.php?t=15679) [http://www.gentoo.org/doc/en/xorg-config.xml](http://www.gentoo.org/doc/en/xorg-config.xml) [http://ubuntuforums.org/showthread.php?t=777759](http://ubuntuforums.org/showthread.php?t=777759)181 - Ubuntu 下利用 expect 脚本自动登录 ssh 作代理
这类文章网上已经有很多了,实在不想再重复,可惜一直没有一个双击就连上 ssh 的,要不写个 GUI?putty 很搞,还是弹出一个命令行出来填用户名密码,那我干脆直接在 terminal 搞定啦。
网上流传的大多都是上面一段代码,问题就在最后一句上面:
interact
即交互模式,我用 ssh 只是拿来做代理的话,只需要后台运行就可以了,哪来 interact 呢?还有考虑更周到的,加了个 timeout,每分钟发送一个空格防止被踢,我严重怀疑这个脚本的可行性,特别是 ssh 用上了 -n 的时候。另外还有 ssh 的 -f,我以为这个是用于作 Daemon 运行的,结果发现只是暂时将 ssh 放在后台了。
最后,我将 interact 改成了 expect eof,世界清静了。
当然,还是建议采取公钥加密的,这样就不用每次都输入密码了。
182 - 着迷 twittering
似乎最近迷上了翻过伟大的长城这项体育活动,而且还是为翻墙而翻墙那一种。。。
继 twip 之后,又迷上了 gtap 这个 twitter api proxy。这个代理架设在 gae 上,用的还是我熟悉的 python 语言,非常亲切。当然,那坨 Django 的代码也不是我暂时能够捣鼓出来的,hack 的时候用了点拙劣的手法。
twitter 这种思维碎片,我总喜欢将其归为短信一类,因此手机发推才比较接近我的习惯。鉴于非智能机 hack 的难度较高,没有 vpn 和 ssh 可用,只好用 gae 做 proxy 了。既然 gtap 支持 Oauth,当然是一个不错的选择(我对于第三方要求原始帐号和密码都比较反感。。。)。但手机界最节省流量的 twitter proxy,应该算是 birdnest 了,号称 50% off。参考过 birdnest 的代码进行测试,我觉得 50% 这个数字太保守,一般情况下能省掉三分之二的流量。原理其实很简单,每条推只传输基本元素,例如 What、Who、When,这样省下的流量就很可观了。另外,这需要客户端的配合,假如你的客户端需要多媒体的支持,例如显示对方推友的头像,推中的图片自动显示缩略图,这种纯文字的 api proxy 就不合适了。
可惜的是,birdnest 不支持 Oauth 认证,而 twitter 已经停止了 basic authorization 的认证方式,于是我就参考了 birdnest 的代码将 textOnly 的特性加入了 gtap。(via issue 71)这几天回顾了一下,又加了一个过滤特定 Client 的功能。某君用了 Google2Tweet 这款插件,但我已经在 Greader 上 follow 了,不需要接收这些冗余信息了,再屏蔽之。结果是 50 条推基本在 35-48KB 之间(开启 gzip)。我很好奇这离压缩的极限有多远,有位 laobubu 的网友自己写了服务端和客户端,采用了自己的数据格式进行传输,据称每次可以在 1KB 左右,参见其作品快速推 FastTwitter。
我用来配套的是 jibjib,基本的读推、发推、锐推、mention 以及私信都支持,但我 follow 的人不多,获取最流行的信息有点难度。加上没有列表和搜索的支持,着实让人头痛。不过 Java 于我一向比较头大,hack 这个暂时有点难度。非智能机似乎还真没有多少好用的 java 客户端,稍后可能会投靠奶瓶推这种 web 版客户端,当然要在有可用 php 空间的情况下了。话说 jibjib 的作者更新很勤快,twip 的 cnyegle 狐狸也是!坦白说,狐狸你的 VPN 让我动心了,尤其是可以蹭 CMCC 这点 ~~~
183 - python-twitter 与第三方 api 协作
上回讲到搭建了 twip 作为 twitter api proxy,那当然要好好地利用一下。正好最近做了一个 twitter 的机器人,每次都要翻代理上推实在麻烦,另外一个问题是 twitter 对 http basic authorization 的限制逐渐收紧,现在的 api 限制为 60 per hour,稍后会再次缩减到 45,而 oauth 则相反,准备在 150/h 的基础上逐渐推到 1500/h(via)。因此,利用 twip 的 oauth 特性进行中转会是相当不错的选择。
这个机器人以前是通过 proxychains,以 ssh 直连到 twitter 官网进行操作的,服务器端需要执行
这命令十分头痛,似乎 tee 没有发挥到应有的作用,screen 也不能 detach 了。现在,使用 twip 进行中转后,只需
就可以了。
当然,python-twitter 0.6 还不支持 api proxy,但 python twitter 都是采用 http basic authorization,那么理论上只需要更改 api 的地址即可。我 checkout 了最新的代码,欣喜地发现了原来的 http://twitter.com 已经被 basic_url 参数取代了,兴冲冲地试试,沮丧地发现这个参数是留给 Oauth 的。 这个有点不解,如果 python-twitter 本身直接采用 oauth,那么没有必要修改 base_url。如果采取的第三方 api,难道 python-twitter 也通过 oauth 跟第三方进行认证吗? 后来采取了最直接的方法,直接拿了一个 twitter.py 放在 code 目录里改,将所有的 twitter.com 都改成自己的 twip 地址,世界清静了。。。注意,要将 python-twitter 的 api 认证里面的密码改成 twip 里的密码,否则会遇到 HTTP 401。
这个问题已经有同胞反映过,追踪 google code 上 issue89 可以跟进该问题的进一步发展。
184 - Oauth 与 twip 杂感
今天帮忙搭建 twip 了,主要参考了 http://yht.in/archives/90 这篇文章。
twip 的主要原理,就是通过一台在墙外而国内又可以访问的独立主机作为跳板,国内用户首先连接到该独立主机上,然后再通过主机与 twitter 交换数据。为了提高安全性,twitter 今年 6 月份停止了 http basic authorize,取而代之的是 Oauth 的认证。用户的登录过程由 twitter 完成,最后 twitter 将用户的认证结果和授权告诉应用。得益于 twitter api 的简洁,以及标准的数据交互方式(可选择 xml、json 和 atom 其中一种),大量的第三方应用如雨后春笋般涌现出来,极大地丰富了 twitter 的表现形式(我终于可以手机上推啦 XD)。
发觉 Oauth 这套认证真的很不错,无需用户重复繁琐的注册步骤,即可对用户进行认证。稍后考虑一下用上这套认证,到时候注册就方便多了,反正面向的主要用户群都是 twitter 的老用户顺便扯一句,这年头连 twitter 和 digg 都不用 MySQL 了,也是,对于 key-value 这种字典型的应用,吞吐量又大,传统的关系数据库经常需要多表联合查询,的确会拖慢效率。
最后打开了服务器的 gzip,twitter 真的是流量大户,更新一次就 20 多 kb 了
185 - sshtunnel 翻过伟大的长城
项目进入到一个稳定期,就等词库的扩张了。我打算在 twitter 上架设一个 twitter 机器人,搞搞新意思。看了下 twitter api 的文档,发现 python 的 twitter 库还真不少,看中的有两款:python-twitter 和
tweepy, 稍微看了看,python-twitter 首页就有示例了,就你吧。以迅雷不及掩耳盗铃之势装好了 simlejson 和 oauth 的依赖,就可以开始工作了。本地测试通过~~由于众所周知的原因,不能直接访问到 twitter,似乎 python-twitter 这个库也找不到设置代理的接口。不想 hardcode,跑去问 google 大神了。google 说 proxychains 是个好东西:通过设置 LD_PRELOAD 环境变量,使所有 TCP 连接都经过代理出去。(奇怪的是我找不到这个变量,却能够使用代理。。。)
既然要处理代理的事,顺便就把 ssh tunnel 搞定了。以前一直没搞懂,究竟执行 ssh -D 以后,forward 的是服务器端还是本地。后来终于想通了,本地通过 ssh 加密连接到服务器上,服务器负责转发功能。假设执行的是 ssh -D 12345,则设置 socks 代理后,数据就发往本地的 12345,这些数据通过加密的 ssh 信道传到服务器,服务器上再通过非加密通道 forward 出去。因为代理的 TCP 连接都通过 ssh 传输到远端服务器,就像在 ssh 隧道中通行一样,所以称为 ssh tunnel.
186 - python 中文编码笔记
最近碰了很多钉子。。。
不得不说,python2.6 相较于之前发布的版本,就编码方面来说,有明显的进步。本机使用的是 python2.6,同样的代码根本没有遇到问题。到了服务器上部署时,一台服务器的 python2.5 和另一台服务器的 python2.4,都折磨得我苦不堪言。
先厘清几个概念:python 内置的字符类型是 unicode,当需要进行编码转换时,都要先转成 unicode,然后再转换成目标编码。而 str 类型是二进制类型,例如
声明变量 uniStr=u’ 的 ‘,uniStr 的类型为 Unicode
执行 gbStr=uniStr.encode(‘gb2312’),则 gbStr 的类型为 str,长度为 18 字节(gb2312 标准里用两个字节表示一个汉字)。
若执行 gbStr.encode(‘gb2312’),则会报错,因为 ‘ascii’ codec can’t decode byte 0xd3 in position 0: ordinal not in range(128)。
关于 unicode:unicode 可以想象成一个比 ascii 大得多的码表,能够包含所有现存字符。每个字符有一个对应的编码,编码的范围是 0 到 0x10ffff,那么我们可以使用 32 位的 int 来储存一个 unicode 字符。但这样比较浪费空间,人们就提出了别的编码方案,例如 utf-8。简而言之,编码方案就是把 unicode 值映射成字节流,术语是 encoding。
utf-8 方案编码方案是应用较广的一种,编码规则如下:
- unicode 编码值小于 128,原封不动;
- unicode 编码值在 128 到 7ff,将转换为 2 个字节,每字节值范围在 128 到 255 之间;
- unicode 编码值大于 7ff 的,将转换为 3-4 个字节,每字节值范围在 128 到 255 之间。
参见:
http://www.b-list.org/weblog/2007/nov/10/unicode/
http://boodebr.org/main/python/all-about-python-and-unicode
http://www.cl.cam.ac.uk/~mgk25/unicode.html
http://docs.python.org/howto/unicode.html
http://hi.baidu.com/a370500904/blog/item/9ff8aff49d8344d5f3d38534.html
187 - 分布式有感
最近有点疲于奔命的感觉,孤军作战不是好事阿。
以前学分布式计算原理与应用,一直对老师和教材有不满。教材虽然写的中规中矩,可是对 java 的偏向性无疑是一个败笔。书中的 Java 代码起个 helloworld 的作用还可以,真要用起来总觉得生涩无比,整天就在流里面转来转去。实验方面,socket 的相关代码没有 c 的清晰,要不是 string 类封装了一些应手的函数,真不知道有什么优点。RMI 看上去很美好,只是这种美好是建立在实验的基础上的。要真的应用起来,单单异常处理就会要命,网络的不确定性太多了,不是随便架起一层就能抹平的。
最讨厌的是老师整天在吹嘘 servlet 的高性能,喋喋不休简直是 Java 活脱脱的营销人员。servlet 相对于 cgi 的优点,在于两点:一是持续运行,可以轻松维护 session 信息;二是可以拥有线程池,启动快速,不需频繁启动关闭进程,减少系统消耗。
有时候真的很难理解他的思维,多个 cgi 进程就需要加载多份程序?Linux 早就实现了多个副本共享一个代码段了。没有线程池方便?可以用进程池啊。而多进程抗崩溃的能力不是多线程能够轻易赶上的。fastcgi 的出现,也使得 cgi 的持续运行成为了可能,维护 session 不再遥不可及。
最重要的一点是,cgi 模型非常清晰易懂。前端的服务器做一个 dispatch 的作用,将请求分发到不同程序,并可以应付一定的 IO 请求。cgi 程序自身从环境变量读取请求信息(get)或从标准输入流读入(post 方法),最后将结果输出到标准输出流,服务器轻松地将 cgi 的标准输出流重定向到自己身上,再返回给 Browser 端。 而 fastcgi 则采取了一种更为激进一点的方式,fastcgi 具有 daemon 进程,服务器端与 fastcgi 端通过 socket 进行通讯。
ajax 的出现,使程序的行为变得更加灵活。原来的动态网页,流程一般是从 Browser 发起请求,服务器端接受请求转发给 cgi,cgi 程序与数据库交互,返回动态构造的网页,服务器再转发给 Browser。而 ajax 则可以通过在 Browser 端运行的 js,直接在客户端动态构建网页,切实减轻了服务器端的负载。
188 - CrossSiteRequestForgeries 跨站伪请求
今天看 Django 的 tutorial,里面提到了这样一种跨站攻击:
假设有客户 Bob 在浏览论坛页面(Bob 真可怜~~~),Alice 发布了一个很热的帖子,里面有
而在这个场景里,论坛和银行都是 Bob 所信任的,这就是 csrf 的可怕之处 。Django 推荐凡是影响服务器端数据的动作,均使用 post,另外还引入了 csrf_token 预防事故。
189 - chrome 关于 404 的错误处理
190 - web.py+gae= 我的第一个留言板【二】
下面接着说说 google application engine 和 webpy 配套的问题。在我完成留言板的时候,这方面的资料还是很少,中文资料更少,希望 webpy 社区能够壮大啊。
gae 据说很有 Django 的风格,也是内置 Django 的,而 web.py 则需要自备。因此,在应用目录中应该放入 web.py 解压后得到的 web 目录。否则会导致 Import error: no module named web
详细的发布过程,可以参考 chinaunix 的这篇文章:http://bbs.chinaunix.net/viewthread.php?tid=1487470 [ 笔记 ]Google App Engine 上试用 web.py
由于 gae 的限制,应用的模板文件需要编译后才能在 gae 上执行读取,否则会导致 No module named templates 。上面的文章有具体的解决办法。
注意,源代码的 app.run() 需要改成 main=app.cgirun() 才能正常工作。 否则会导致 ImportError: No module named flup.server.fcgi
gae 上面只能使用 google 的数据库,使用称为 gql 的查询语言。
要定义一个表:
from google.appengine.ext import db
content=db.StringProperty(multiline=True)

date=db.DataTimeProperty(auto_now_add=True)

title=db.StringProperty(multiline=False)

myKey=db.StringProperty(multiline=False)
db.get(db.Key(myKey))
批量查询:
db.GqlQuery(“SELECT * FROM data ORDER BY date DESC”)
record=data()
设置 record 的相关属性
record.put()
删除记录:
q=db.get(db.Key(myKey))
db.delete(q)
与 python 自带的 web server 不同,在 gae 中 print 语句也是直接输出到浏览器而不是服务器的日志中。 像是一个典型的 cgi 应用。
比较有参考价值的文章:http://hi.baidu.com/xusx/blog/item/801704fa5d84259258ee90dd.html 手把手教程,没读完
http://baiduer.net/2010/03/05/ 使用 webpy 创建一个 blog/ 另一个手把手。。。
最后推荐几个用 python 写的 blog: http://maoxingxu.appspot.com 这个是国内的技术人写的。
					[http://www.k4ml.com/archive/old/page165.html](http://www.k4ml.com/archive/old/page165.html) 这个风格很简洁。。。

					[http://webpy.appspot.com](http://webpy.appspot.com/)   这个非常值得参考,似乎就是 webpy 的人写出来的。

					[http://micolog.appspot.com/zh-cn](http://micolog.appspot.com/zh-cn) 目前比较通用的 blog,可以直接使用。
我的留言本源代码:/Files/Lifehacker/myApp.7z
191 - web.py+gae= 我的第一个留言板【一】
最近体验了一把 web.py 开发的便捷。
建议在看 web.py 的 cookbook 之前,对 http 协议的 get 方法和 post 方法先了解一下,html 最好也要有基本的知识。
web.py 的工作流程,一般是从 URL 映射开始,然后把请求分派给不同的处理类处理,处理类比较像一个粘合层,负责从数据层拿数据,以及告诉 render 如何形成最后的页面效果。同时,它也负责控制整个交互的过程。数据层封装了数据库相关的操作,有了它,可以很方便的更换不同的数据库。当然,在具体的字段属性上,可能会有一定的差异,需要注意一下。
render 是一个模板渲染系统,它使 html 变成了类似函数一样的东西,可以通过变量填充形成最终的页面。通过 $ 符号,就能直接在 html 中写 python 语句,方便扩展功能。 为了控制网站的整体风格,可能需要一个统一的 layout.html 和 css 去控制一些公共的框架。
因此,遇到问题的时候,请从 URL 映射开始,遵循工作流程查找问题所在。特别是 500 服务器内部错误,很有可能是改动的时候只改了一处地方,相配合的负责展现的 html 模板或者数据层没有进行对应的修改。
参考:http://webpy.org 建议参照 tutorial 和 cookbook 动手做做, 还是挺有趣的。另外,codeExample 还有几个比较简单的例子可以参考,有助于快速建立自己的应用。我的留言板也参考了里面的 blog 例子。python 自带了 web server,所以即使你没有安装 Apache 之类的,还是能直接访问到自己的成果。
若遇到 attributeError 的问题,可以参考上一篇我的上一篇 文章 ,主要是 web.py 0.3 的某些调用方式改变了,而 webpy.org 的例子还是 0.2 版本。
192 - Datagramsocketwithconnection-orientedinJava
数据报通常采用 udp 协议进行传输,UDP 相较于 TCP 协议能够节省带宽,相应的获得较高速度,但不能保证包的安全抵达和顺序不变。
Java 关于 datagram 提供有 connect 方法,该方法绑定了远端的 IP 地址和端口号,即该 socket 以后只能向绑定目标主机发送数据或接受数据。
当目标地址不可达,且收到了该地址不可达的 ICMP 包时,会抛出 PortUnreachableException 异常,但不能保证一定抛出该异常。
** 该方法也不能保证包的顺序和安全抵达 **,只是为了发送的时候简便一点而已。。。
193 - thetruthaboutsessions 择译
cookie
get parameter
cookie+fingerprint generated by user agent
194 - web.py0.3 版本 tutorial 示例
我承认我看中文了。。。中文安装指南导向的是 web.py 0.2 版本的 tutorial 翻译,版本有点旧,且 0.3 与 0.2 的 tutorial 不兼容。
首先是下载压缩包,然后解压,最后 sudo ./setup.py (我用的是 ubuntu )
示例代码如下,主要是 run 方法的方式有点不同。
好简洁的一个 web app,感觉比 java servelet 的一大堆概念要清晰多了。
195 - apache-tomcat-6.0.26 的 cgi 配置过程
这东西折磨我太久了,写篇笔记。
Apache 的目录很好认,我下的是 zip 绿色版,解压开就看见 running 这个说明文件了,建议大家读读。
conf 目录是放置配置文件的,bin 则是可执行文件的位置,只需双击 startup.bat,即可启动 Apache。
要运行 cgi,主要是改两个文件,一个是 web.xml,一个是 context.xml。
context.xml 主要是改这么一行:
直接在 context 后加上 privileged 就可以了,用于放行可执行文件。
web.xml 修改的是 cgi 那一段,其实默认也带有 cgi 的配置的,只是被注释掉而已。
还有:
配置过程中遇到一个问题,就是静态网页可以正常显示,但点击其中的 cgi 连接时,cgi 就被当成文件下载了,而不是由服务器解释执行。
这个问题需要 html 文件、目录结构和以上 web.xml 配置的紧密配合才可以解决。
假设当前目录结构是:
cookie
What is your customer id:
上述的 html 代码,是无法正常工作的。点击按钮时,Apache 会在 html 所在当前文件夹下寻找 cgi 文件。但默认的 cgi 前缀是 WEB-INF/cgi-bin,路径不对,无法执行。改成 /cookies/cgi-bin/cookie.cgi 以后就可以了。
至于 cgi 没有执行,变成文件下载了,主要是因为 web.xml 中 servlet-mapping 那一段的问题,只有路径中带有 /cgi-bin/* 的 cgi 文件才会被执行的。
因此,只有 web.xml 的配置、目录结构以及 html 文件中指定的路径三者紧密配合,才有可能成功执行一个 cgi。
196 - MatlabCell 功能
最近完成模式分类的作业,需要大量使用 matlab, 期间发现了一个问题,是 matlab 代码的复用程度。
在面向过程编程里, 基本的复用单位是函数,程序的复杂度籍此下放到函数的接口上。设计好函数间的接口,基本上就成功了一半。在面向对象编程里, 基本的复用单位是对象,对象使得数据具有了一定程度的自维护。而在 matlab 里, 我很长时间都没有找到方向,因为我搞不清楚复用的单位是什么。
matlab 中,基本的单位是矩阵,针对矩阵系统有一大堆的函数供你调用。但是,想自己写程序还是有一定的麻烦的。for 循环语句在 matlab 里似乎是一个禁忌,所有老师都敦敦告诫,不要轻易使用 for。而函数调用也是同样的低效, 有兴趣的同学可以参见 此文 。那么我们应该基于什么模块进行复用呢?
答案是 Cell 模式。 Cell 是 matlab 的一个特色功能,将一段代码以 %% 标记为 cell 以后,就可以重复执行了,相当于在命令行输入该代码块。以前,为了测试不同参数的结果,往往要用 up arrow 执行上一条指令。遇到需要多条指令的地方,就很容易出错。而算法又没有完善到可以封装成函数的地步,整天来回跑代码让人不堪其烦。通过 cell 模式,可以非常方便地在不同的代码块之间跳转,或重复执行一个代码块。
对于我来说,matlab 中的编程越来越趋向于 bash 编程,所用到的语言只是起到一个粘合剂的作用,负责把系统内置的高性能函数组合起来。这种对语句块的复用方式能够快速地调试出需要的功能,有点类似传统的 goto,但是可以一直观察着执行的结果,事前无须编译 ,也不用考虑函数的接口问题。当算法稳定下来,就可以考虑用一个接口轻易地封装成函数了。同时也可以直接保存为 mfile 供以后使用。
197 - 浅论函数式语言的环境,兼谈闭包
函数式语言与命令式语言的一个根本不同,就是下面这个两个数交换的例子居然是正确的:
输出 2 1
究其原因,是环境造成的。什么是环境呢?通俗点讲,你可以将环境看成是一个栈,栈单元的内容就是各个变量的值。可见,上述 a 和 b 赋值时的环境均是 a=1,b=2。再看一个 lisp 的例子:
设环境 r 为 r=( (X.(A B)) (Y.(C D)))
则 r((EXPR (X Y) (CONS X Y)) (CDR Y) (CAR X))
=r1 (CONS X Y)
其中 r1=( (X.(D)) (Y .A) (X .(A B)) (Y . (C D)))
可见列表求值跟上述赋值的结果是一样的,环境决定了自变量的值。
而闭包,则是打包了环境,相当于内部函数是在外层函数的环境下运行的。因此,又有人称 JavaScript 中的闭包是没有释放的资源(若释放了相关资源,调用内部函数就无法得到正确结果了)。
198 - 最近要跟函数式语言干一仗!
本来打算先征服 ML(meta language)的,结果可耻地失败了,并且归结为译者水平太低。
然后拿了本《Lisp 语言》回来看,语言很平实,的确比较适合我,可惜作者马希文教授已经作古了,天妒英才啊。
但是看完表之后还是卡住了,思维的转变的确不是一朝一夕的事。不过马教授比 ML 作者出色的地方,是开卷即讲述 s 表达式的概念,教你分清原子与 s 表达式。然后介绍简写法,流畅地引入了表的概念。而且表的描述非常生动(没有右支是非 nil 原子结束的 s 表达式),接下来的 append、car、cdr 都很入神了。
下面讲讲配置的经过吧:
lisp 其实主要是一个技术标准,具体实现的时候允许不同版本之间的合理歧义。我选择的方言(即 lisp 的具体实现)是 clisp,主要是因为它受众面比较广一点。
刚刚配置的时候是采用 cgywin 升级安装 clisp 的,大约 16MB。安装完之后,发现输入 clisp 出现了一个类似 shell 的对话式交互,解释执行的意思吧。
后来采用 vim 配合的方法,先把函数定义写入文本文件,然后再在 lisp 中编译。不过好像没有语法高亮,而且运行的时候刷的一声就过去了。不清楚是否有 main 方法可以调用自己的函数进行测试。
最后,选择了 lispbox 作为配合的 IDE。lispbox 带有 slime,却一点都不 slime 要 26MB 多,安装完成后就可以得到一个分割窗口,上部显示跟 clisp 的交互,下部显示错误信息。需要注意的是,不要选择带有空格的路径进行安装。
Emacs 的快捷键很多,可我是 vimer,再记一套快捷键有点记忆负担啊,现在最常用的是 M-p(m 表示 meta,是 alt 键的意思,这是 Emacs 继承下来的快捷键表示法),键入上一条。
199 - RBF、K-NN 与 Decisiontree
要做一个 classifier,的确不易。面对需要训练的 classifier,是否 training error 越少越好呢?显然不是,因为虽然 training error 降低了,但 test error 不见得就会降低,实际表现为一个拐点。如下图:
为了平衡 error 的权重,我们引入了额外的函数 lambda*,训练效果由 error 和 lambda* 共同评价。下面讨论一下 lambda 的取值:
 (存疑)
因此,我们采取多个函数综合评估的方式进行,即 RBF(radial base function)
RBF 采取多个正态分布函数进行评估,各函数的均值和方差不一样。
(待续)
K-NN 最近邻算法。俗话说物以类聚,人以群分。该算法就是采用离目标点最近的 k 个邻居,对目标点进行分类。但 k 值的选取非常关键,而且易受干扰。

200 - java 路径设置
这个问题简直是痛中之痛,为什么如此现代,标榜人性化的 java 居然会让我等在环境变量的设置上反复煎熬?!
在 path 变量中 (没有则新建),添加
新建 CLASSPATH 变量 , 添加
文件名保存为 Hello.java,当前目录进入命令行,输入命令:
javac Hello.java
java Hello
今天花了差不多一个小时,正常编译通过,就是因为敲了 “java Hello.class”,所以一直报错 could not find main class program will exit,悲剧
201 - 同步与异步
202 - 最长公共子序列 --- 从动态规划说起
我比较不长记性,你要我马上写一个动态规划给你是比较有难度的。在我眼里,动态规划就是一个优化程序的手段,适合于有大量重复子计算问题的时候用,原理就跟缓冲有点像,把需要重复计算的东西都放进内存里,需要的时候通过索引之类的东西直接查询,节省重新计算的时间。
下面来看一幅图:

假设要从 A 到 H,在这个带权图中求最短路径。那么有:
min(H)=min(min(F)+FH,min(G)+GH)
min(F)=min(min(D)+DF,min(E)+EF)
min(G)=min(min(D)+DG,min(E)+EG)
从前三步,我们可以发现,min(D)、min(E) 均是重复计算了的,那么如果将其存起来,下次计算的时候就可以节省时间了。
从这个例子可以发现,动态规划要求问题必须要有最优子结构,即原问题可以递归到规模降低的子问题进行求解。
203 - JavaScript 中的闭包
一看到闭包这个词,我就会想起线性代数中的封闭空间,也就是说,这个空间中的所有向量,无论经过何种运算,最终结果还是会落在该空间中。那么 JavaScript 中会不会也是类似的概念呢?
我们来看一个定义:
所谓闭包,指的是一个拥有许多变量和绑定了这些变量的环境的表达式(通常是一个函数),因而这些变量也是该表达式的一部分。
这说明了,JavaScript 中的闭包是包含了上下文的函数,也就是说,这个函数的作用基础,是它所处的环境,这是不能超越的,跟线性代数是不是有一点似曾相识的感觉呢?
换个角度看,闭包的作用是为了实现 OO。JavaScript 中,没有像 C++ 那样的 public、private、protect 属性标识, 建立起类比较困难。类是带行为的数据,而闭包是带数据的行为,在 JavaScript 中我们用函数的定义代替类的定义,用闭包代替了 setter/getter 方法。请看一段 livecode:
上文中 n 的声明和函数 getter 组成了一个典型的闭包。最终返回的函数,即刚刚所讲的行为,其实目的就是为了得到 n 的值,所以说闭包就是带有数据的行为。
另外,我觉得阮一峰说的闭包也是很简洁的:我的理解是,闭包就是能够读取其他函数内部变量的函数。
我希望各位能够真正从学术上的定义理解闭包,因为所有对闭包定义的诠释和简化都是对 JavaScript 的片面解读。
204 - StandardML 语言(一)
在 Windows 平台下推荐使用 Moscow ML 解释器,主要是安装比较方便,其他有 Standard ML of New Jersey, 安装后需要设置环境变量(即 bin 目录所在位置)。
要引用系统模块,请使用 load “module”, 例如:
-load “Math”;
-Math 4.0;
函数名后需要空一格。
从 C/C++ 语言转来的同学,请多多练习 andalso 与 orelse,另外,条件表达式
if E then E1 else E2
else 部分必须存在(即 else 需要严格匹配,一个 if 对应一个 else)。
附上 ML 程序设计教程 课后习题答案
205 - 初探 Git
今天闷着头看了半天 git,终于明白了 git 的基本工作原理。想提高你对 git 的认识,请移玉步到 http://progit.org/book/zh,中文翻译很不错,感谢先行的兄弟们!
以前项目组进行版本管理的时候,采用的是 tortoiseSVN,正如某君所说,SVN 并非一无是处,但是总有又痛又痒的感觉。学习 SVN,我有了和其他人进行版本协作的经验,不过发生合并冲突的机会还是比较少的(一般每个人负责一个单元),常用的操作就是 checkout 然后 coding。不得不说,由于和服务器的交换速度太慢,且小文件居多,每次 checkout 和 commit 都非常痛苦。那时候就幻想,为什么版本管理不能放在本地呢
后来,做另一个项目的时候,更加晕菜。其实真正写代码的人就两三个,但在实验室写的代码经常要带回宿舍看,一来二去的比较混乱。我们又是那种想到哪改哪的人,出错的时候总想回到原来,要有时光机多好啊。最后实在没办法,想出了一个笨办法,每次成功运行就打包一次,标上日期。那段日子简直是中世纪!!!
最后,git 慢慢进入了我的视野。我开始明白到,分布式版本管理是需要的,但不是最急迫的。我最需要的,是一个版本管理系统协助我进行 coding。git 有 tag,代码每次成熟到一定阶段,就可以打上一个 tag,灰常方便。 当然,git 最强大的是 branch。
206 - Linux 超级块
Linux 超级块的结构
207 - 嵌入式系统概念笔记
208 - linux 进程信息
209 - watchdog
210 - copyonwrite
211 - 反转分页表(Invertedpagetables)
212 - 银行家算法(Thebanker'salgorithm)
- 已被进程占用 1. 进程资源需求最大值 1. 系统可用资源 1. 有 A、B 两进程,当前可用资源无法满足任一进程的需要,但 A 在运行时暂时释放了所占用的资源,使得 B 得以结束,从而释放更多资源,使得 A 顺利结束。1. 有 A、B、C 三个进程,当前资源可以满足 A 的运行需要,因此此时 A 并没有陷入死锁。